Bản tổng kết của đoàn hệ tim mạch Bạch Hải viết: “Trong 10 năm theo dõi, ghi nhận 1.628 ca biến cố tim mạch lớn.” Con số này nhiều hay ít? Lúc này bạn chưa thể trả lời. Nếu là số ca của cả một tỉnh hàng triệu dân thì nó khác hẳn chính số ca ấy trong vài nghìn người cao tuổi; nếu là số ca của một năm thì nó cũng khác hẳn số ca dồn lại qua nhiều năm. Một con số đếm chỉ có nghĩa khi ta biết đếm ai, trong bao nhiêu người và trong bao lâu.
Chương này đi tìm lời đáp cho câu hỏi: một bệnh “phổ biến” đến mức nào, và con số nào mới đáp đúng điều bạn đang hỏi? Học xong chương này, bạn có thể:
phân biệt số đếm, tỷ lệ, tỷ số và tỷ suất; chỉ ra tử số, mẫu số và khoảng thời gian của bất kỳ con số tần suất nào;
tính và diễn giải tỷ lệ hiện mắc, nguy cơ và tỷ suất mới mắc từ dữ liệu từng người có thời gian theo dõi;
chọn số đo phù hợp với câu hỏi: đo gánh nặng hay tìm nguyên nhân, quần thể đóng hay quần thể mở;
giải thích quan hệ giữa nguy cơ và tỷ suất, giữa hiện mắc, mới mắc và thời gian mắc bệnh, và nhận ra khi nào phép xấp xỉ sai;
tính tỷ suất tử vong, tỷ lệ tử vong trong số ca bệnh, tỷ lệ tấn công, và nhận ra những chỗ chữ “rate” bị dùng sai.
Dữ liệu giả định
Mọi số liệu trong chương này đều là dữ liệu giả định, mô phỏng từ mô hình có hạt giống ngẫu nhiên cố định, và không phản ánh địa phương hay cơ sở y tế có thật nào. Chương dùng năm bộ dữ liệu: doan_he_tim_mach (đoàn hệ tim mạch Bạch Hải, Mục C.3.7), quan_the_mo và quan_the_mo_dot (dân cư phường D và các đợt trầm cảm, Mục C.3.3, Mục C.3.4), hai_tinh (tử vong ở tỉnh Lục Vân và tỉnh Bạch Hải, Mục C.3.1) và o_dich_tiec_cuoi (ổ dịch sau một tiệc cưới ở xã E, Mục C.3.18).
1.1 Đếm ai, trong bao lâu: tử số và mẫu số
Dịch tễ học (epidemiology) nghiên cứu sự phân bố của bệnh trong quần thể (population) và những yếu tố quyết định sự phân bố đó. Việc đầu tiên của ngành này rất giản dị: đếm. Nhưng số đếm (count) đứng riêng, như 1.628 ca biến cố tim mạch, chỉ cho biết khối lượng công việc của bệnh viện. Muốn so sánh hai nơi, hai thời kỳ hay hai nhóm người thì phải đặt số đếm lên trên một mẫu số và nói rõ khoảng thời gian.
Vì thế, mọi con số tần suất bệnh đều phải trả lời được ba câu hỏi: tử số đếm ai, mẫu số gồm những ai, và trong bao lâu? Mục này lần lượt đi qua từng câu.
1.1.1 Quần thể có nguy cơ
Xương sống của chương này là một nghiên cứu đoàn hệ (còn gọi là nghiên cứu thuần tập; cohort study): một nhóm người được xác định tại một thời điểm rồi theo dõi dần theo thời gian, để ghi nhận ai mắc bệnh hay gặp biến cố cần nghiên cứu. Năm 2015, nghiên cứu chọn ngẫu nhiên 20.000 người từ 40 đến 74 tuổi trong dân cư tỉnh Bạch Hải. Mỗi người được khám một lần lúc vào nghiên cứu, gọi là khám nền, rồi được theo dõi tiếp 10 năm. Lúc khám nền, chưa ai từng bị đột quỵ, nhồi máu cơ tim hay bệnh mạch vành, vì nghiên cứu hỏi về lần mắc đầu tiên. Kết cục (outcome), tức sự kiện mà nghiên cứu đếm, là biến cố tim mạch lớn (major cardiovascular event) đầu tiên: lần đầu một người bị đột quỵ, nhồi máu cơ tim hoặc tử vong do tim mạch. Chữ “lớn” ở đây nghĩa là nặng, quan trọng về lâm sàng, chứ không phải “lớn nhất”; ai gặp nhiều biến cố cũng chỉ được tính một lần, ở biến cố đầu tiên.
Trong 10 năm ấy, đoàn hệ theo dõi được đủ mọi người: không ai mất theo dõi (loss to follow-up), tức không ai bặt tin giữa chừng đến mức ta không biết họ có gặp biến cố hay không. Người chết vì nguyên nhân khác thì thôi theo dõi từ lúc chết.
Chi tiết bộ dữ liệu
Đoàn hệ tim mạch Bạch Hải (doan_he_tim_mach, xem thêm Mục C.3.7).
Chọn người. Năm 2015, nghiên cứu rút ngẫu nhiên từ sổ đăng ký dân cư của tỉnh, riêng trong từng nhóm tuổi và giới. Số người rút ở mỗi nhóm cân xứng với cỡ của nhóm ấy trong dân số, nên đoàn hệ đại diện cho người 40–74 tuổi của tỉnh. Bộ dữ liệu coi như ai được mời cũng nhận lời.
Ai không được đưa vào. Người đã từng bị đột quỵ, nhồi máu cơ tim hay bệnh mạch vành.
Tìm biến cố. Mỗi năm, nhóm nghiên cứu liên lạc lại với từng người, đồng thời tra hồ sơ bệnh viện và sổ đăng ký tử vong. Bộ dữ liệu coi mọi biến cố đều được phát hiện và xếp loại đúng, và không ai mất theo dõi.
Tăng huyết áp lúc khám nền. Huyết áp trung bình của 3 lần đo chuẩn từ 140/90 mmHg trở lên, hoặc đang điều trị tăng huyết áp.
Các thông tin khác lúc khám nền. Hút thuốc là tự khai đang hút. Uống rượu bia nhiều là tự khai uống từ 14 đơn vị cồn chuẩn trở lên mỗi tuần; một đơn vị cồn chuẩn là một lượng cồn quy ước, cỡ một cốc bia hơi. Phì đại thất trái, tức thành tim bên trái dày lên, được ghi nhận trên điện tim. Trong dữ liệu, THA không liên quan đến giới.
Mẫu số đúng của một số đo tần suất là quần thể có nguy cơ (population at risk): những người có thể trở thành ca mới trong khoảng thời gian đang xét (Lash và c.s. 2021, ch 4; Celentano và Szklo 2019, tr. 45). Một người thuộc quần thể có nguy cơ khi hội đủ ba điều: còn sống và còn được quan sát, chưa mắc kết cục đang đếm, và về mặt cơ thể có khả năng mắc kết cục đó. Phụ nữ đã cắt tử cung không thể mắc ung thư thân tử cung, nên không thuộc mẫu số khi đo tần suất của bệnh này.
Đưa người không thể mắc bệnh vào mẫu số sẽ pha loãng số đo. Phường D cho ta một ví dụ cụ thể. Từ 01/01/2020 đến 31/12/2024, mọi người trưởng thành sống ở phường này đều được quan sát, và mỗi lần mắc bệnh được đếm là một đợt trầm cảm điều trị tại trạm y tế phường. Người đang trong đợt trầm cảm thì không thể “khởi phát” một đợt mới cho đến khi khỏi, nên trong thời gian ấy họ tạm rời khỏi quần thể có nguy cơ, khỏi bệnh rồi mới quay lại. Mục 1.4 sẽ tính đúng phần thời gian này.
Chi tiết bộ dữ liệu
Dân cư phường D (quan_the_mo và quan_the_mo_dot, xem thêm Mục C.3.3, Mục C.3.4).
Ai được quan sát. Mọi người trưởng thành cư trú ở phường D trong thời gian trên. Ai chuyển đến hay bước sang tuổi trưởng thành thì vào quan sát từ ngày đó; ai chuyển đi hay qua đời thì thôi quan sát từ ngày đó.
Đếm gì. Chỉ những đợt trầm cảm được điều trị tại trạm y tế phường, mỗi đợt có ngày bắt đầu và ngày khỏi. Một người có thể có nhiều đợt.
Đợt dở dang. Có người lúc vào quan sát đã đang trong một đợt. Đợt nào chưa khỏi khi người bệnh rời quan sát thì không có ngày khỏi.
Giả định. Dữ liệu được dựng sao cho số dân, tốc độ khởi phát đợt mới và độ dài trung bình của một đợt gần như không đổi suốt thời gian quan sát; Mục 1.6 dựa vào điều này.
1.1.2 Định nghĩa ca bệnh: tử số cũng là một phép đo
Tử số đếm ca bệnh (case). Nhưng ai mới được tính là một ca? Điều đó do định nghĩa ca bệnh (case definition) quyết định: bộ tiêu chí lâm sàng, xét nghiệm, thời gian và nơi chốn mà một người phải thỏa mãn mới được đếm.
Đoán trước khi đọc tiếp · mức vừa. Sau một tiệc cưới, nhiều khách bị đau bụng, tiêu chảy. Đội điều tra đếm ca theo ba cách: người khai có triệu chứng tiêu hóa, người đạt định nghĩa ca bệnh của đội, và người cấy phân thấy vi khuẩn gây bệnh. Cách thứ ba cho con số nhỏ nhất. Vì sao?
Ổ dịch sau một tiệc cưới ở xã E, tỉnh Lục Vân, cho thấy định nghĩa làm tử số thay đổi đến mức nào. Sau bữa trưa ngày 15/11/2025, đội điều tra phỏng vấn được 310 trong số 350 khách dự tiệc, và 165 người khai có ít nhất một triệu chứng tiêu hóa. Theo định nghĩa ca bệnh của đội, ca bệnh là người bị tiêu chảy hoặc nôn, kèm đau bụng hoặc sốt, khởi phát trong một khung giờ nhất định sau bữa trưa; có 151 người đạt định nghĩa này. Chỉ 18 người là ca xác định, tức cấy phân thấy vi khuẩn Salmonella, nhưng cũng chỉ 25 người được lấy mẫu phân. Ba định nghĩa cho ba tử số. Con số “xác định” nhỏ nhất không phải vì ít người bệnh nhất, mà vì ít người được xét nghiệm nhất.
Chi tiết bộ dữ liệu
Ổ dịch sau tiệc cưới ở xã E (o_dich_tiec_cuoi, xem thêm Mục C.3.18).
Ai. Tiệc có 350 khách cùng ăn bữa trưa ngày 15/11/2025. Đội điều tra liên lạc và phỏng vấn được 310 khách. Mọi con số của ổ dịch trong chương đều tính trên số khách này, với giả định họ đại diện cho mọi khách dự tiệc.
Định nghĩa ca bệnh. Tiêu chảy (từ 3 lần phân lỏng trong 24 giờ) hoặc nôn, kèm đau bụng hoặc sốt, khởi phát 6–72 giờ sau bữa trưa.
Ca xác định. Người đạt định nghĩa ca bệnh và có thêm kết quả cấy phân dương tính với Salmonella.
Giả định. Bộ dữ liệu coi lời kể của khách về những món đã ăn là đúng.
Tử số và mẫu số còn phải lấy từ cùng một quần thể. Nếu tử số đếm mọi ca nhập viện ở Bệnh viện Đa khoa tỉnh Bạch Hải, kể cả bệnh nhân từ tỉnh khác chuyển đến, còn mẫu số chỉ là dân số của tỉnh, thì phân số ấy sẽ phóng đại tần suất bệnh của tỉnh. Ngược lại, người dân trong tỉnh đi chữa bệnh ở nơi khác thì tử số lại bỏ sót họ. Ai được đếm ở tử số cũng phải là người có thể nằm trong mẫu số, và ngược lại (Celentano và Szklo 2019, tr. 55–58).
Định nghĩa càng chặt thì càng đếm ít ca và ít ca “nhầm”, nhưng cũng bỏ sót nhiều ca thật hơn. Sai sót khi phân loại ai là ca sẽ bàn ở Chương 10; còn cách phân loại ca xác định, ca có thể và ca nghi ngờ trong giám sát xin dành cho Chương 12.
1.1.3 Tỷ lệ, tỷ số, tỷ suất: ba thứ khác nhau
Có tử số và mẫu số rồi, ta còn phải biết hai thứ ấy quan hệ với nhau thế nào. Có ba loại phân số, và sách gọi mỗi loại bằng một tên tiếng Việt riêng (Bảng 1.1).
Tỷ lệ (proportion) là phân số có tử số nằm trong mẫu số, chẳng hạn số người tăng huyết áp (THA) chia cho tổng số người được khám; con số này không có đơn vị và nằm giữa 0 và 1. Tỷ số (ratio) là thương của hai đại lượng bất kỳ, tử số không cần nằm trong mẫu số, chẳng hạn số nam chia cho số nữ. Tỷ suất (rate) đo tốc độ một sự kiện xảy ra theo thời gian: số ca mới chia cho tổng thời gian theo dõi những người còn có thể mắc bệnh. Con số này có đơn vị “trên một đơn vị thời gian”, và về nguyên tắc có thể lớn hơn 1 (Lash và c.s. 2021, ch 4; Szklo và Nieto 2014, tr. 69).
Xem mã R
knitr::kable(ba_loai, align ="llll")
Bảng 1.1: Ba loại phân số trong dịch tễ học, với ví dụ từ đoàn hệ tim mạch Bạch Hải. Dữ liệu giả định.
Loại
Tử số nằm trong mẫu số?
Đơn vị, khoảng giá trị
Ví dụ trong đoàn hệ
Tỷ lệ
Có
Không đơn vị; 0 đến 1
THA lúc nền: 6.001/20.000 = 30,0%
Tỷ số
Không cần
Tùy hai đại lượng
Nam/nữ: 9.602/10.398 = 0,92
Tỷ suất
Không: mẫu số là người-thời gian
Trên một đơn vị thời gian; 0 đến vô cùng
1.628 biến cố/181.699 người-năm = 9,0 trên 1.000 người-năm
Nhiều tài liệu tiếng Việt gọi chung mọi con số này là “tỷ lệ”. Sách giữ ba tên riêng, vì mỗi loại trả lời một câu hỏi khác và được diễn giải theo cách khác. Tiếng Anh cũng chẳng nhất quán: “attack rate” và “case fatality rate” thực ra là tỷ lệ chứ không phải tỷ suất, hai trường hợp mà Mục 1.7 sẽ quay lại.
Ghi nhớ
Trước khi tin một con số tần suất, hãy hỏi ba câu. Tử số đếm ai, theo định nghĩa nào? Mẫu số gồm những ai, và họ có thật sự có thể mắc bệnh không? Khoảng thời gian là bao lâu? Con số nào chưa trả lời đủ cả ba câu thì chưa thể đem so với con số nào khác.
1.2 Hiện mắc: chụp ảnh tại một thời điểm
1.2.1 Hiện mắc điểm và hiện mắc kỳ
Hãy hình dung bạn chụp ảnh toàn bộ quần thể vào một ngày, rồi đếm xem trong ảnh có bao nhiêu người đang mang bệnh. Phân số thu được là tỷ lệ hiện mắc (prevalence):
\[
P = \frac{\text{số người đang mắc bệnh tại thời điểm } t}{\text{số người trong quần thể tại thời điểm } t}
\tag{1.1}\]
Tỷ lệ hiện mắc: một tỷ lệ, không đơn vị, từ 0 đến 1
Tử số
Mọi người đang mắc tại \(t\), dù mới mắc hôm qua hay đã mắc nhiều năm
Mẫu số
Mọi người trong quần thể tại \(t\), kể cả những người đang mắc
\(t\)
“tê”
Thời điểm chụp ảnh: một ngày, hoặc một lần khám
Tử số gồm cả ca cũ lẫn ca mới, và đó là chỗ khác nhau cốt lõi so với các số đo ở mục sau. Toàn bộ những người đang mắc tại một thời điểm gọi là nhóm hiện mắc (prevalence pool) (Lash và c.s. 2021, ch 4; Celentano và Szklo 2019, tr. 51).
Đoán trước khi đọc tiếp · mức dễ. Ở phường D, tỷ lệ nào lớn hơn: tỷ lệ người đang trong một đợt trầm cảm vào đúng một ngày, hay tỷ lệ người có ít nhất một ngày trầm cảm trong cả năm?
Ảnh chụp tại một thời điểm cho ta tỷ lệ hiện mắc điểm (point prevalence). Ở phường D, ngày 01/01/2023 có 3.012 người trưởng thành đang cư trú, trong đó 58 người đang trong một đợt trầm cảm: tỷ lệ hiện mắc điểm là 1,9%. Còn nếu bức ảnh “phơi sáng” suốt một khoảng thời gian, ta có tỷ lệ hiện mắc kỳ (period prevalence): mọi người đã mắc vào bất kỳ lúc nào trong khoảng đó, kể cả người khỏi bệnh trước cuối kỳ. Năm 2023, 162 trong số 3.265 người từng cư trú ở phường D có ít nhất một ngày trầm cảm, tức 5,0%. Hiện mắc kỳ thường lớn hơn hiện mắc điểm, vì tử số có thêm những ca bắt đầu hoặc kết thúc trong kỳ (Szklo và Nieto 2014, tr. 72).
1.2.2 Hiện mắc đo gánh nặng, không đo tốc độ mắc mới
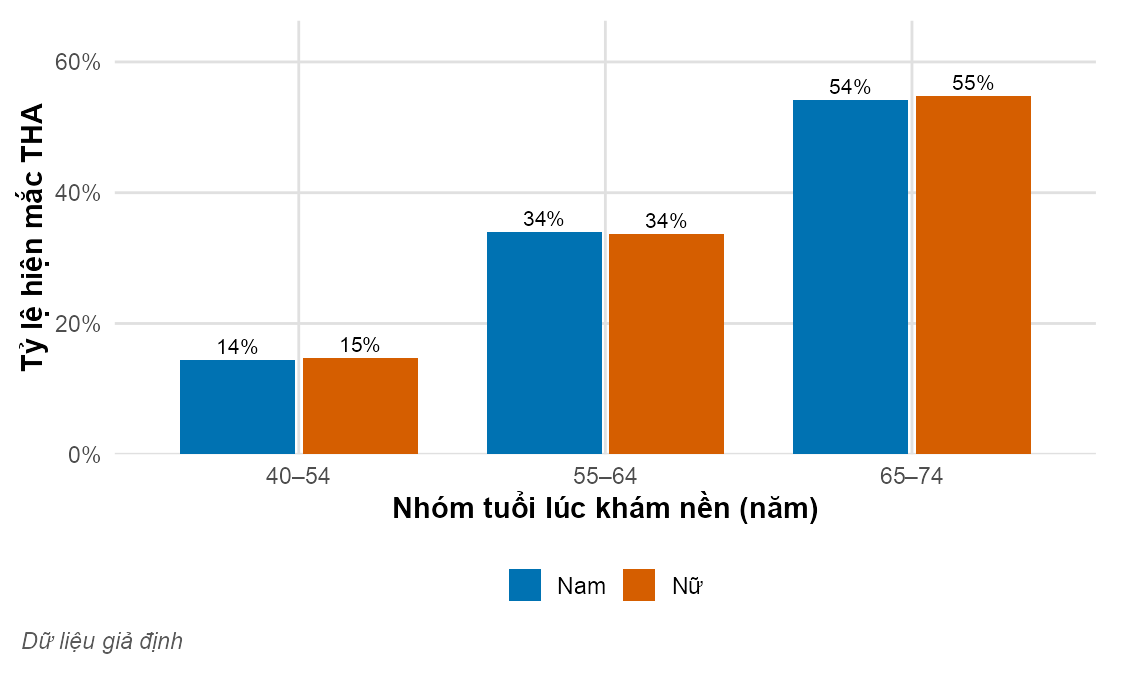
Lần khám nền năm 2015 của đoàn hệ chính là một bức ảnh như thế: có 6.001 trong 20.000 người bị THA, tỷ lệ hiện mắc 30,0%. THA ở đây gồm cả người đo thấy huyết áp cao lúc khám nền lẫn người đang điều trị THA; ngưỡng huyết áp cụ thể có trong hộp “Chi tiết bộ dữ liệu” của đoàn hệ ở đầu chương. Tỷ lệ này tăng rõ theo tuổi: từ 15% ở nhóm 40–54 lên 34% ở nhóm 55–64 và 55% ở nhóm 65–74 (Hình 1.1, Bảng 1.2). Còn trong mỗi nhóm tuổi, nam và nữ gần như bằng nhau.
Xem mã R
hinh_tha_tuoi() +gia_dinh()
Hình 1.1: Tỷ lệ hiện mắc tăng huyết áp lúc khám nền theo nhóm tuổi và giới, đoàn hệ tim mạch Bạch Hải. Hiện mắc tăng mạnh theo tuổi và gần như không khác giữa nam và nữ. Dữ liệu giả định.
Xem mã R
bang <- tha_tuoi_gioi |>transmute(`Nhóm tuổi`=unname(nhan_tuoi_tm[as.character(nhom_tuoi)]), `Giới`=as.character(gioi),`Số người`=so(n, 0), `Số người THA`=so(x, 0), `Tỷ lệ hiện mắc`=phan_tram(p, 1))bang <-bind_rows(bang, tibble(`Nhóm tuổi`="Chung", `Giới`="", `Số người`=so(N_tm, 0),`Số người THA`=so(tha_n, 0), `Tỷ lệ hiện mắc`=phan_tram(tha_p, 1)))knitr::kable(bang, align ="llrrr")
Bảng 1.2: Số người khám nền, số người tăng huyết áp và tỷ lệ hiện mắc theo nhóm tuổi và giới. Dữ liệu giả định.
Nhóm tuổi
Giới
Số người
Số người THA
Tỷ lệ hiện mắc
40–54
Nam
4.192
606
14,5%
40–54
Nữ
4.639
683
14,7%
55–64
Nam
3.200
1.089
34,0%
55–64
Nữ
3.467
1.168
33,7%
65–74
Nam
2.210
1.198
54,2%
65–74
Nữ
2.292
1.257
54,8%
Chung
20.000
6.001
30,0%
Con số này rất có ích cho người lập kế hoạch. Đoàn hệ được chọn ngẫu nhiên từ dân cư nên đại diện cho người 40–74 tuổi của tỉnh, vậy trạm y tế cần chuẩn bị thuốc hạ áp và lịch tái khám cho khoảng 30% nhóm dân số này. Hiện mắc đo gánh nặng: bao nhiêu người đang cần chăm sóc ngay bây giờ.
Nhưng để tìm nguyên nhân thì hiện mắc là công cụ kém. Một bệnh có tỷ lệ hiện mắc cao có thể vì nhiều người mắc mới, vì người bệnh sống lâu với bệnh mà không khỏi, hoặc cả hai; hiện mắc trộn hai thứ ấy vào một con số, và Mục 1.6 sẽ viết quan hệ này thành công thức. Muốn biết bệnh xuất hiện nhanh đến đâu, ta cần đếm ca mới.
Chương này chưa kèm khoảng tin cậy (confidence interval) cho các số đo. Đó là khoảng cho biết một con số có thể xê dịch bao nhiêu chỉ do may rủi, và xin dành cho Chương 5. Phần lớn số đo ở đây dựa trên nhiều ca, chẳng hạn 1.628 biến cố trong đoàn hệ, nên dao động ngẫu nhiên nhỏ so với những khác biệt ta đang bàn.
1.3 Nguy cơ: xác suất mắc trong một khoảng thời gian
1.3.1 Quần thể đóng và tỷ lệ mới mắc
Đoàn hệ tim mạch là một quần thể đóng (closed population): mọi người cùng vào lúc khám nền, sau đó không thêm ai nữa. Người ta chỉ rời quần thể khi gặp biến cố, khi chết vì nguyên nhân khác, hoặc khi hết thời gian theo dõi.
Với quần thể đóng, câu hỏi tự nhiên là: trong số những người chưa mắc lúc bắt đầu, bao nhiêu phần sẽ mắc trong một khoảng thời gian? Đó là câu hỏi về mới mắc (incidence), tức về sự xuất hiện của ca mới, và lời đáp là tỷ lệ mới mắc (incidence proportion), còn gọi là tỷ lệ mới mắc tích lũy (cumulative incidence). Xét một người, đó là nguy cơ (risk) mắc bệnh trong khoảng thời gian ấy; xét cả nhóm, đó là tỷ lệ người mắc (Lash và c.s. 2021, ch 4; Szklo và Nieto 2014, tr. 49).
Nguy cơ (tỷ lệ mới mắc) trong một khoảng thời gian theo dõi
\(A\)
“a hoa”
Số ca mới xuất hiện trong khoảng thời gian đó
\(N\)
“en hoa”
Số người có nguy cơ lúc bắt đầu khoảng thời gian
Độ dài của khoảng theo dõi ký hiệu là \(\Delta t\) (đọc là “đen-ta tê”). Ký hiệu này không có mặt trong công thức 1.2, nhưng \(R\) luôn phải được nêu kèm nó: một nguy cơ không kèm khoảng thời gian thì không diễn giải được.
Nguy cơ là khái niệm của từng người, nhưng ta chỉ đo được trên một nhóm. Mỗi người trong đoàn hệ có nguy cơ riêng, tùy tuổi, giới, huyết áp và nhiều yếu tố khác, còn tỷ lệ mới mắc của cả nhóm là trung bình của những nguy cơ cá nhân ấy (Lash và c.s. 2021, ch 4). Nói “nguy cơ của một người 65–74 tuổi” thì thực ra ta đang gán cho người đó nguy cơ trung bình của những người giống họ.
Với đoàn hệ, \(A = 1.628\) biến cố trong 10 năm và \(N = 20.000\) người, nên nguy cơ 10 năm là 0,0814, tức 8,1%. Như mọi tỷ lệ, \(R\) không có đơn vị và nằm giữa 0 và 1.
1.3.2 Nguy cơ luôn đi kèm khoảng thời gian
“Nguy cơ 8%” chưa phải là câu trả lời. Trong đoàn hệ, nguy cơ 1 năm là 0,9%, nguy cơ 5 năm là 4,5%, nguy cơ 10 năm là 8,1%. Cùng một nhóm người, cùng một bệnh mà ra ba con số rất khác nhau: nguy cơ 10 năm gấp 9 lần nguy cơ 1 năm. Nguy cơ không kèm khoảng thời gian thì không diễn giải được (Lash và c.s. 2021, ch 4). Đọc thấy “nguy cơ tái phát 8%”, câu hỏi đầu tiên luôn là: trong bao lâu?
1.3.3 Khi người tham gia rời đi sớm: quan sát bị chặn
Phép chia \(A/N\) ngầm giả định mọi người đều được quan sát trọn 10 năm, nhưng thực tế không như vậy. Trong đoàn hệ, 1.836 người chết vì nguyên nhân không do tim mạch trước khi có biến cố tim mạch nào, nên ta không còn cơ hội quan sát một biến cố tim mạch ở họ nữa. Khi một người thôi được quan sát trước lúc gặp biến cố, ta nói quan sát ở người đó bị chặn (censoring), hay người đó rời diện quan sát trước biến cố (Szklo và Nieto 2014, tr. 49–50).
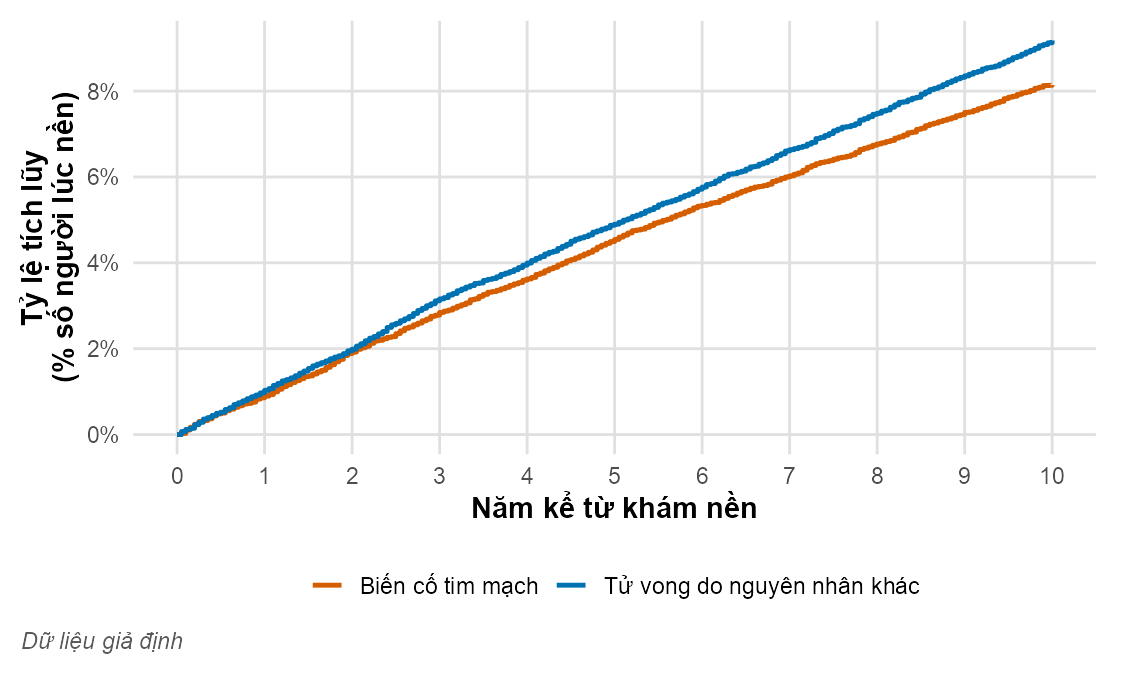
Ở đây, tử vong do nguyên nhân khác còn là một nguy cơ cạnh tranh (competing risk): một biến cố ngăn hẳn không cho biến cố đang nghiên cứu xảy ra. Hình 1.2 cho thấy hai loại biến cố tích lũy song song theo thời gian; đến năm thứ 10, số người chết vì nguyên nhân khác (1.836) còn nhiều hơn số người có biến cố tim mạch (1.628).
Xem mã R
hinh_tich_luy() +gia_dinh()
Hình 1.2: Tỷ lệ tích lũy của biến cố tim mạch và của tử vong do nguyên nhân khác trong 10 năm theo dõi, tính trên toàn bộ người lúc khám nền. Hai đường tăng gần như đều theo thời gian; tử vong do nguyên nhân khác, một nguy cơ cạnh tranh, tích lũy nhanh hơn một chút. Dữ liệu giả định.
Đoán trước khi đọc tiếp · mức vừa. Giả sử ta muốn biết nguy cơ biến cố tim mạch trong 10 năm nếu không ai chết vì nguyên nhân khác. Phép chia đơn giản, lấy số biến cố chia cho số người lúc đầu, vẫn giữ 1.836 người chết sớm trong mẫu số. Kết quả của phép chia ấy so với nguy cơ cần tìm thì sao?
Nếu câu hỏi là “nguy cơ biến cố tim mạch khi không ai chết vì nguyên nhân khác”, thì phép chia đơn giản \(A/N\) đánh giá thấp nguy cơ. Lý do dễ hiểu: những người chết sớm vẫn nằm trong mẫu số, dù đã chết thì họ không còn cơ hội góp vào tử số. Nhưng bỏ họ ra khỏi mẫu số cũng sai, vì như thế là làm như họ chưa từng có nguy cơ, trong khi họ đã đóng góp vài năm theo dõi không biến cố. Cách đúng là giữ phần thời gian theo dõi mà mỗi người thật sự đóng góp, và có hai cách làm như vậy: tính tỷ suất (Mục 1.4), hoặc ước lượng nguy cơ qua từng khoảng thời gian ngắn, như trong hộp “Đi sâu hơn” dưới đây.
Đi sâu hơn
Kaplan–Meier và nguy cơ cạnh tranh. Ý tưởng là chia thời gian theo dõi thành nhiều khoảng rất ngắn, mỗi khoảng kết thúc tại một thời điểm có biến cố, và trong mỗi khoảng chỉ tính trên những người còn được quan sát ngay trước thời điểm ấy. Nhân dồn xác suất “vượt qua” từng khoảng, ta được tỷ lệ sống sót (survival proportion), tức tỷ lệ chưa có biến cố đến thời điểm \(t\), còn phần bù là nguy cơ (Szklo và Nieto 2014, tr. 52–56; Lash và c.s. 2021, ch 4):
Các thời điểm có ít nhất một biến cố, tính đến \(t\)
\(d_i\)
“đê i”
Số biến cố tại thời điểm \(t_i\)
\(n_i\)
“en i”
Số người còn được quan sát ngay trước \(t_i\) (chưa có biến cố, chưa bị chặn)
\(\prod\)
“tích”
Nhân dồn qua mọi thời điểm \(t_i \le t\)
Đây là phương pháp Kaplan–Meier (Kaplan–Meier method); bảng sống (life table) cổ điển cũng làm đúng việc ấy, nhưng với các khoảng thời gian cố định. Nếu coi quan sát ở người chết vì nguyên nhân khác là bị chặn tại lúc chết, phương pháp này cho nguy cơ 10 năm là 8,5%, cao hơn tỷ lệ đơn giản 8,1%.
Hai con số trả lời hai câu hỏi khác nhau. Tỷ lệ đơn giản 8,1% là tỷ lệ người thật sự có biến cố tim mạch, trong một thế giới mà người ta vẫn còn chết vì những nguyên nhân khác. Con số Kaplan–Meier thì ước lượng nguy cơ trong một thế giới giả định không có tử vong cạnh tranh, và chỉ đúng nếu những người bị chặn có cùng tiên lượng với người còn lại. Khi nguy cơ cạnh tranh lớn, như ở người cao tuổi, khoảng cách giữa hai con số sẽ lớn dần (Lash và c.s. 2021, ch 4). Trường hợp chặn quan sát mang thông tin, tức người rời đi có tiên lượng khác người ở lại, xin dành cho Chương 9.
1.4 Tỷ suất: tốc độ xuất hiện ca mới
1.4.1 Người-thời gian
Thay vì đếm người, ta đếm thời gian: mỗi người góp vào mẫu số đúng khoảng thời gian họ có nguy cơ và còn được quan sát. Đơn vị này là người-thời gian (person-time), đo bằng năm thì gọi là người-năm (person-years). Khoảng thời gian từ lúc bắt đầu theo dõi đến khi một người gặp biến cố là thời gian đến biến cố (incidence time) của người đó.
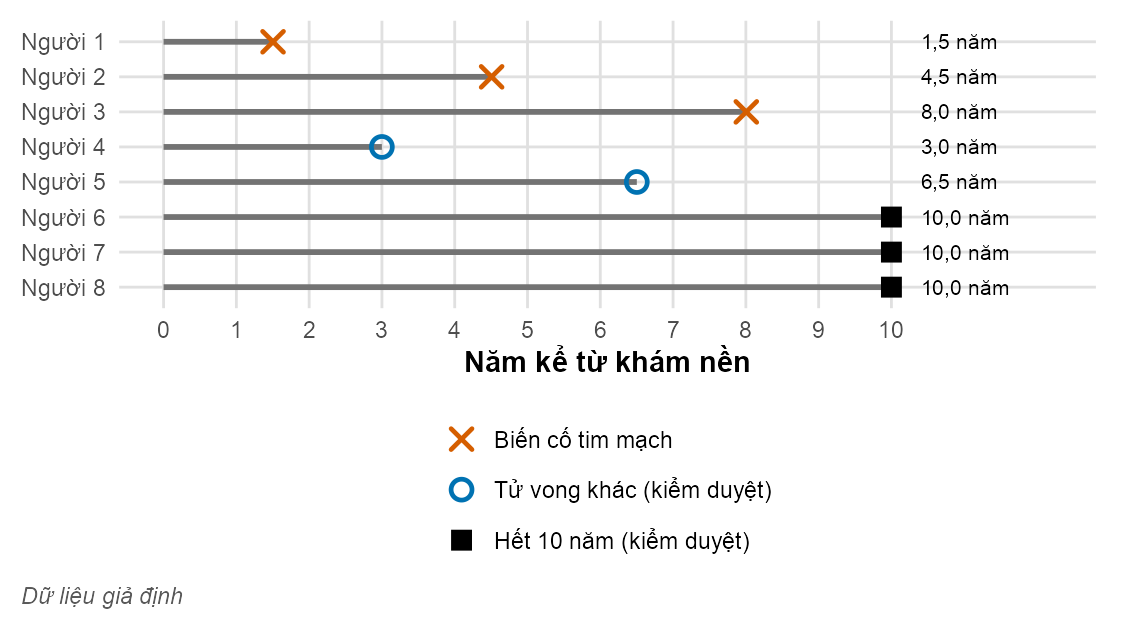
Hình 1.3 vẽ 8 người có thật trong đoàn hệ, mỗi đường là thời gian theo dõi của một người. Họ được chọn có chủ đích để có đủ mọi cách kết thúc theo dõi, chứ không phải chọn ngẫu nhiên. Người 1 gặp biến cố sau 1,5 năm và thôi đóng góp từ đó. Người 4 chết vì nguyên nhân khác sau 3,0 năm: quan sát ở người này bị chặn tại mốc ấy, nhưng người này vẫn đóng góp đủ 3,0 năm có nguy cơ. 3 người cuối được theo dõi trọn 10 năm mà không có biến cố.
Xem mã R
hinh_nguoi_thoi_gian() +gia_dinh()
Hình 1.3: Sơ đồ người-thời gian của 8 người trong đoàn hệ tim mạch. Mỗi người đóng góp thời gian từ lúc khám nền đến khi có biến cố, chết vì nguyên nhân khác hoặc hết theo dõi. Tổng cộng 53,5 người-năm và 3 biến cố. Dữ liệu giả định.
Tổng người-thời gian là tổng độ dài các đoạn thẳng:
Tổng người-thời gian có nguy cơ, ví dụ tính bằng người-năm
\(t_1, \dots, t_n\)
“tê một”, …, “tê en”
Thời gian có nguy cơ mà từng người đóng góp: đến biến cố, đến khi bị chặn, hoặc đến hết theo dõi
\(n\)
“en”
Số người được theo dõi
Với 8 người trong hình, \(T = 53{,}5\) người-năm; với cả đoàn hệ, \(T = 181.699\) người-năm. Con số này nhỏ hơn tích 20.000 người × 10 năm, vì những người có biến cố hoặc chết sớm đã thôi đóng góp trước hạn.
1.4.2 Tỷ suất mới mắc và đơn vị của nó
Tỷ suất mới mắc (incidence rate) là số ca mới chia cho tổng người-thời gian có nguy cơ; Szklo và Nieto gọi đó là mật độ mới mắc (incidence density) (Szklo và Nieto 2014, tr. 60):
Với đoàn hệ, \(I = 1.628 / 181.699\), tức 8,96 biến cố trên 1.000 người-năm. Người ta thường nhân với 1.000 hoặc 100.000 cho con số dễ đọc; phép nhân ấy chỉ đổi đơn vị chứ không đổi ý nghĩa.
Có ba tính chất phân biệt tỷ suất với nguy cơ (Lash và c.s. 2021, ch 4; Szklo và Nieto 2014, tr. 69). Thứ nhất, tỷ suất có đơn vị thời gian: 9,0 trên 1.000 người-năm cũng là 0,75 trên 1.000 người-tháng. Thứ hai, tỷ suất không bị chặn ở 1: một bệnh cấp tính lan rất nhanh có thể có tỷ suất lớn hơn 1 trên người-năm. Thứ ba, tỷ suất không phải là xác suất mà là một tốc độ: số ca xuất hiện trên mỗi đơn vị thời gian theo dõi.
Tách đoàn hệ theo nhóm tuổi (Bảng 1.3), ta thấy cả nguy cơ lẫn tỷ suất đều tăng mạnh theo tuổi: tỷ suất ở nhóm 65–74 gấp 5,1 lần nhóm 40–54. Hãy để ý cột người-năm: nhóm 65–74 có 4.502 người nhưng chỉ đóng góp 36.044 người-năm, trung bình 8,0 năm mỗi người, vì nhiều người gặp biến cố hoặc chết sớm.
Bảng 1.3: Biến cố tim mạch, người-năm, nguy cơ 10 năm và tỷ suất mới mắc theo nhóm tuổi lúc khám nền. Dữ liệu giả định.
Nhóm tuổi
Số người
Biến cố
Người-năm
Nguy cơ
Tỷ suất (trên 1.000 người-năm)
40–54
8.831
341
85.027
3,9%
4,0
55–64
6.667
552
60.628
8,3%
9,1
65–74
4.502
735
36.044
16,3%
20,4
Chung
20.000
1.628
181.699
8,1%
9,0
Hiểu lầm thường gặp
“Tỷ suất 9 trên 1.000 người-năm nghĩa là cứ 1.000 người thì 9 người sẽ mắc bệnh.” Không phải. Người-năm không phải là người: một nghìn người-năm có thể là một nghìn người theo dõi một năm, cũng có thể là một trăm người theo dõi mười năm. Muốn biết bao nhiêu phần trăm số người sẽ mắc, ta cần nguy cơ kèm khoảng thời gian; cách chuyển từ tỷ suất sang nguy cơ có ở Mục 1.5.
1.4.3 Quần thể mở và biến cố tái diễn
Phường D là một quần thể mở (open population): suốt thời gian quan sát, có người chuyển đến, người chuyển đi, người bước sang tuổi trưởng thành, người qua đời. Trong 5 năm, 910 người chuyển đến và 306 người bước sang tuổi trưởng thành, còn 1.036 người chuyển đi và 139 người qua đời. Tổng cộng 4.216 người từng được quan sát, nhưng số người cư trú vào ngày đầu mỗi năm luôn ở quanh mức 3.022. Quần thể mở nào có dòng vào cân bằng với dòng ra, và tỷ suất không đổi theo thời gian, thì được gọi là đang ở trạng thái ổn định (steady state) (Lash và c.s. 2021, ch 4).
Với quần thể mở, câu hỏi “bao nhiêu phần trăm số người mắc bệnh” không có câu trả lời gọn, vì mỗi người được quan sát trong một khoảng thời gian khác nhau. Tỷ suất thì vẫn tính được một cách tự nhiên, vì người-thời gian cộng được với nhau, bất kể ai vào ra lúc nào (Lash và c.s. 2021, ch 4).
Trầm cảm còn một đặc điểm nữa: một người có thể có nhiều đợt. Biến cố nào có thể xảy ra lần nữa sau khi người đó khỏi thì gọi là biến cố tái diễn (recurrent event). Trong 5 năm quan sát, có 612 đợt mới khởi phát ở 564 người, trong đó 46 người có từ hai đợt trở lên. Đợt “mới” là đợt bắt đầu sau khi người đó đã vào quan sát. Khỏi một đợt rồi, người đó trở lại quần thể có nguy cơ và có thể khởi phát đợt tiếp theo (Lash và c.s. 2021, ch 4).
Đoán trước khi đọc tiếp · mức vừa. Có những quãng người dân phường D đang trong một đợt trầm cảm. Nếu quên trừ các quãng ấy khỏi người-thời gian ở mẫu số, tỷ suất khởi phát đợt mới tính ra sẽ thế nào so với tỷ suất đúng?
Ta tính tỷ suất khởi phát đợt trầm cảm như sau. Tổng thời gian quan sát là 15.132 người-năm, trong đó 284 người-năm là thời gian người dân đang trong một đợt; lúc ấy họ không có nguy cơ khởi phát đợt mới, nên ta trừ phần này khỏi mẫu số. Còn lại 14.847 người-năm có nguy cơ. Tỷ suất là 612 / 14.847 = 41,2 đợt trên 1.000 người-năm có nguy cơ. Nếu quên trừ thời gian đang bệnh, ta được 40,4, thấp hơn một chút. Ở đây sai khác nhỏ vì thời gian bệnh chỉ chiếm khoảng 2% tổng thời gian; với một bệnh mạn tính phổ biến, sai khác sẽ lớn.
Hãy để ý: tử số đếm đợt chứ không đếm người. Nếu chỉ đếm 564 người có ít nhất một đợt thì ta đang trả lời một câu hỏi khác, về tốc độ xuất hiện đợt đầu tiên, và khi đó người-thời gian của mỗi người phải dừng ở đợt đầu. Cách nào cũng đúng, miễn là nói rõ mình đang đếm cái gì.
Chọn nguy cơ hay tỷ suất? Hai số đo trả lời hai câu hỏi khác nhau, nên chọn cái nào là do câu hỏi quyết định. Bác sĩ tư vấn cho bệnh nhân cần nguy cơ: “trong 10 năm tới, khả năng anh bị đột quỵ hay nhồi máu cơ tim là bao nhiêu?”. Nhà nghiên cứu so sánh các nhóm có thời gian theo dõi khác nhau, hay cán bộ giám sát theo dõi quần thể mở, thì cần tỷ suất. Nguy cơ dễ hiểu và gắn thẳng với quyết định của từng người, nhưng chỉ tính đơn giản được khi mọi người được theo dõi trọn khoảng thời gian. Tỷ suất dùng được với mọi kiểu theo dõi, nhưng khó diễn giải hơn vì không phải là xác suất (Lash và c.s. 2021, ch 4; Szklo và Nieto 2014, tr. 69).
Lưu ý: các sách trình bày khác nhau
“Incidence rate” là tỷ lệ hay tỷ suất?Gordis Epidemiology định nghĩa “incidence rate” là số ca mới trong một khoảng thời gian chia cho số người có nguy cơ, nhân với 1.000, và coi đó là một số đo nguy cơ. Còn khi mỗi người được theo dõi một khoảng thời gian khác nhau, sách vẫn gọi phân số có mẫu số là người-thời gian là “incidence rate”, còn gọi là “incidence density” (Celentano và Szklo 2019, tr. 44–46). Thế là cùng một tên có thể chỉ hai số đo khác nhau. Modern Epidemiology chỉ dùng chữ “rate” khi mẫu số là người-thời gian; số ca mới chia cho số người lúc đầu là “incidence proportion”, tức nguy cơ (Lash và c.s. 2021, ch 4). Szklo và Nieto cũng tách “cumulative incidence” (dựa trên số người) khỏi “incidence rate” hay “incidence density” (dựa trên người-thời gian), và nhấn mạnh hai loại chỉ so sánh được khi cùng đơn vị thời gian (Szklo và Nieto 2014, tr. 49, 60, 69).
Khác biệt này làm chính con số bạn tính ra thay đổi: cùng dữ liệu đoàn hệ, “incidence rate” theo nghĩa của Gordis là 8,1% trong 10 năm, còn theo nghĩa của Modern Epidemiology là 9,0 trên 1.000 người-năm. Chương này theo Modern Epidemiology, cuốn sách dẫn đầu về định nghĩa: tỷ suất chỉ dùng khi mẫu số là người-thời gian; phân số có mẫu số là số người gọi là tỷ lệ mới mắc hay nguy cơ. Gặp báo cáo nào viết “tỷ suất” hay “rate”, hãy kiểm tra mẫu số trước khi đem con số ấy so với bất kỳ con số nào khác.
1.5 Từ tỷ suất đến nguy cơ
Tỷ suất giống vận tốc, còn nguy cơ giống quãng đường đã đi. Biết vận tốc và thời gian, ta muốn suy ra quãng đường, tức là nhân tỷ suất với thời gian. Phép nhân này gần đúng khi bệnh hiếm. Nhưng có một chỗ khác: người đã thành ca bệnh thì “dừng chạy”, vì họ rời khỏi quần thể có nguy cơ. Khi nhiều người đã dừng thì số người còn có thể mắc ít đi, nên nguy cơ tăng chậm hơn tích tỷ suất × thời gian.
\[
\begin{gathered}
R \approx I \, \Delta t \quad \text{khi } I\,\Delta t \text{ nhỏ} \\[4pt]
R = 1 - e^{-I \, \Delta t} \quad \text{khi } I \text{ không đổi, không có nguy cơ cạnh tranh}
\end{gathered}
\tag{1.5}\]
Tỷ suất mới mắc, giả định không đổi trong suốt khoảng thời gian
\(\Delta t\)
“đen-ta tê”
Độ dài khoảng thời gian, cùng đơn vị với \(I\) (năm nếu \(I\) tính trên người-năm)
\(e\)
“e”
Cơ số của lôgarit tự nhiên, khoảng \(2{,}718\); \(e^{-x}\) còn viết là \(\exp(-x)\)
Công thức bên trái là phép xấp xỉ quen thuộc, còn công thức bên phải là công thức mũ, đúng khi tỷ suất không đổi theo thời gian và không ai bị “rút” khỏi quần thể vì một biến cố cạnh tranh. Khi \(I\,\Delta t\) nhỏ hơn khoảng 0,1, hai công thức gần như trùng nhau; khi \(I\,\Delta t\) lớn, phép xấp xỉ sẽ phóng đại nguy cơ.
Đoán trước khi đọc tiếp · mức khó. Ở nam 65–74 tuổi có THA trong đoàn hệ, tỷ suất nhân với 10 năm cho 0,43. Trong 10 năm, tỷ lệ người của nhóm này thật sự có biến cố tim mạch gần với con số nào nhất?
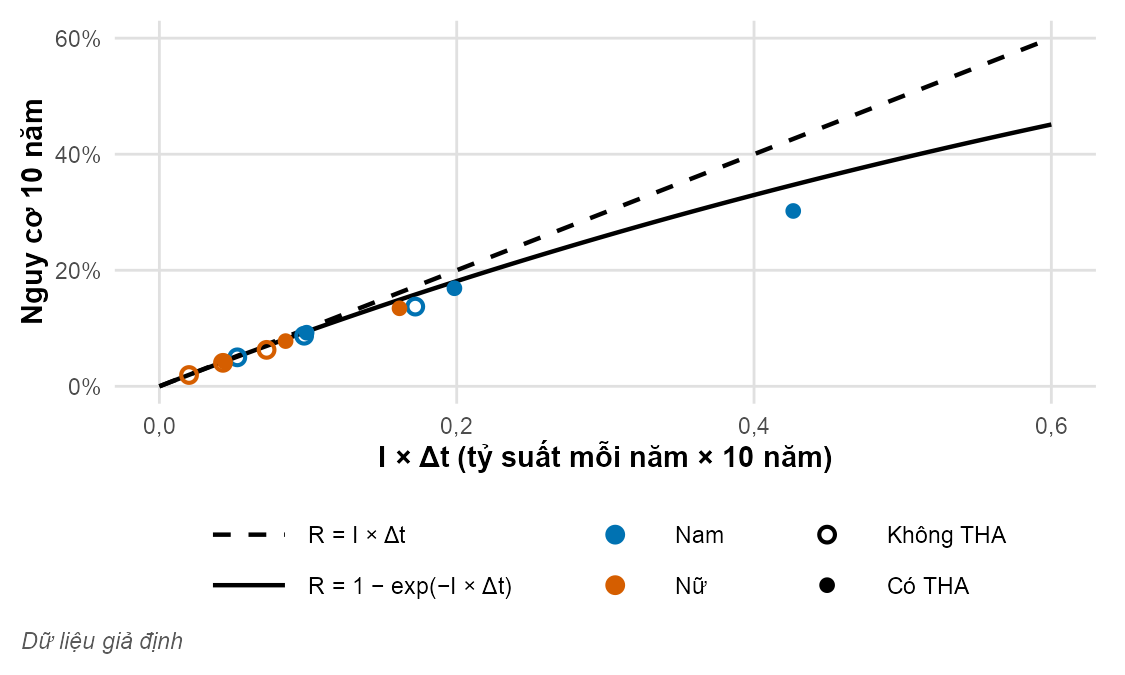
Đoàn hệ cho thấy cả hai trường hợp (Hình 1.4). Ở nữ 40–54 tuổi không THA, tỷ suất là 2,0 trên 1.000 người-năm; nhân với 10 năm được \(I\,\Delta t = 0{,}020\), gần như trùng với nguy cơ quan sát 0,019. Ở nam 65–74 tuổi có THA, tỷ suất là 42,6 trên 1.000 người-năm, nên \(I\,\Delta t = 0{,}426\). Tin vào phép nhân, ta sẽ nói 43% người trong nhóm này có biến cố; công thức mũ cho 34,7%, còn thực tế chỉ 30,2% có biến cố.
Xem mã R
hinh_nguy_co_ty_suat() +gia_dinh()
Hình 1.4: Nguy cơ 10 năm quan sát được so với tích tỷ suất × thời gian, ở 12 tầng tuổi × giới × tăng huyết áp. Đường đứt là phép xấp xỉ R = I × Δt, đường liền là công thức mũ. Khi I × Δt nhỏ, các đường và các điểm trùng nhau; khi I × Δt lớn, phép xấp xỉ phóng đại nguy cơ. Dữ liệu giả định.
Khoảng cách từ 43% xuống 34,7% là hiệu ứng “dừng chạy”: người đã có biến cố đầu tiên không thể có biến cố đầu tiên lần nữa. Khoảng cách tiếp theo, từ 34,7% xuống 30,2%, là do nguy cơ cạnh tranh: trong 1.198 người của tầng này, 253 người chết vì nguyên nhân khác trước khi có biến cố tim mạch, điều mà công thức mũ không tính đến.
Bài học thực hành: muốn chuyển tỷ suất thành nguy cơ thì dùng công thức mũ, và nhớ rằng công thức ấy chỉ đúng khi tỷ suất gần như không đổi và nguy cơ cạnh tranh nhỏ. Quan hệ này sẽ trở lại ở Chương 3, khi ta so sánh tỷ số nguy cơ với tỷ số tỷ suất.
Đi sâu hơn
Công thức mũ khi tỷ suất thay đổi theo thời gian. Tỷ suất thay đổi theo thời gian thì ta coi nó là một hàm \(h(t)\), gọi là nguy cơ tức thời (hazard): tốc độ xuất hiện biến cố ngay tại thời điểm \(t\) ở những người chưa có biến cố. Nếu không có nguy cơ cạnh tranh, nguy cơ đến thời điểm \(t\) là (Lash và c.s. 2021, ch 4):
Tỷ suất (coi như không đổi) và độ dài của khoảng thời gian thứ \(m\)
Vế phải là dạng dùng được với dữ liệu: chia thời gian thành các khoảng, mỗi khoảng mang tỷ suất của chính nó, cộng các tích \(I_m\,\Delta t_m\) rồi đưa vào hàm mũ. Khi chỉ có một khoảng, ta trở lại công thức 1.5.
Công thức này mô tả một thế giới không có nguy cơ cạnh tranh, giống như phương pháp Kaplan–Meier khi coi tử vong do nguyên nhân khác là điểm chặn quan sát. Hai cách cho kết quả gần nhau: ở nam 65–74 tuổi có THA, Kaplan–Meier cho 34,3%, công thức mũ cho 34,7%. Muốn ước lượng tỷ lệ người thật sự có biến cố khi có nguy cơ cạnh tranh thì cần những phương pháp riêng, nằm ngoài phạm vi cuốn sách (Lash và c.s. 2021, ch 4).
1.6 Hiện mắc, mới mắc và thời gian mắc
Hãy hình dung một bồn tắm: nước chảy vào qua vòi là các ca mới mắc, nước thoát ra qua lỗ thoát là những người khỏi bệnh hoặc qua đời, còn mực nước trong bồn là nhóm hiện mắc. Nếu vòi và lỗ thoát giữ nguyên tốc độ đủ lâu, mực nước sẽ đứng yên ở một mức cân bằng. Mức ấy cao khi nước chảy vào nhanh, hoặc khi nước thoát ra chậm, tức là khi người bệnh mắc bệnh lâu (Lash và c.s. 2021, ch 4).
Odds hiện mắc: số người đang mắc chia cho số người không mắc
\(I\)
“i hoa”
Tỷ suất mới mắc ở những người chưa mắc (tính trên người-thời gian có nguy cơ)
\(\bar d\)
“đê gạch”
Thời gian mắc bệnh trung bình, từ khởi phát đến khỏi hoặc tử vong
Vế trái là odds (tỷ số giữa số người đang mắc và số người không mắc; định nghĩa chung ở Mục 1.7) của hiện mắc. \(I\) và \(\bar d\) phải cùng đơn vị thời gian: nếu \(I\) tính trên người-năm thì \(\bar d\) tính bằng năm. Công thức này đòi hỏi quần thể ở trạng thái ổn định: tỷ suất mới mắc, thời gian mắc bệnh và quy mô quần thể không đổi theo thời gian, và dòng người vào ra không làm lệch nhóm hiện mắc.
Phường D cho phép kiểm tra công thức này, vì dữ liệu của phường được dựng ở trạng thái ổn định: tỷ suất khởi phát và thời gian mắc bệnh không đổi suốt thời gian quan sát. Ta đã có \(I = 41{,}2\) đợt trên 1.000 người-năm có nguy cơ, tức 0,0412 đợt mỗi người-năm. Thời gian mắc bệnh trung bình (mean duration) ước lượng từ dữ liệu là \(\bar d = 0{,}46\) năm: 284 người-năm trong đợt chia cho 613 lần khỏi bệnh. Vậy \(I \times \bar d = 0{,}0191\), tức odds hiện mắc dự đoán; đổi ra tỷ lệ thì \(P = 0{,}0191 / (1 + 0{,}0191) = 0{,}0188\), tức khoảng 1,9%. Còn tỷ lệ hiện mắc quan sát ngày 01/01/2023 là 1,9%.
Xem mã R
hinh_hien_mac_mo() +gia_dinh()
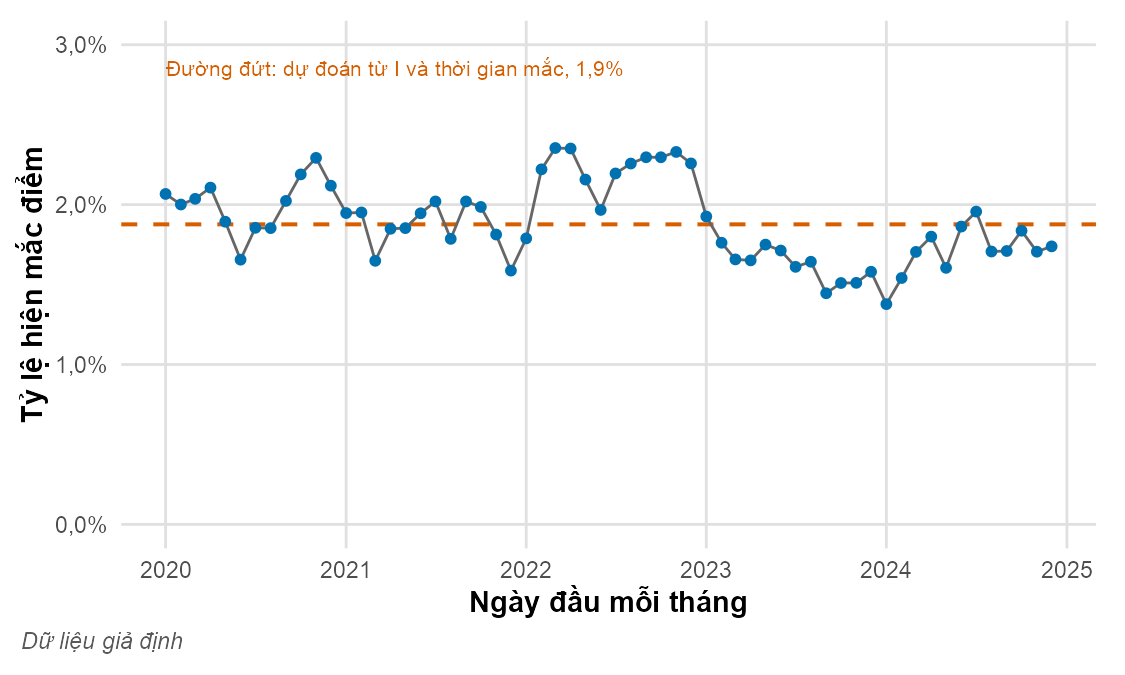
Hình 1.5: Tỷ lệ hiện mắc điểm của trầm cảm vào ngày đầu mỗi tháng ở phường D, so với mức dự đoán từ tỷ suất mới mắc và thời gian mắc bệnh trung bình (đường đứt, 1,9%). Hiện mắc dao động quanh mức dự đoán. Dữ liệu giả định.
Theo Hình 1.5, hiện mắc ngày đầu mỗi tháng dao động từ 1,4% đến 2,4%, quanh mức dự đoán, và trung bình của 60 lần đo là 1,9%. Mỗi lần đo chỉ dựa trên khoảng 57 ca nên dao động ngẫu nhiên là chuyện bình thường. Ở mức hiện mắc thấp như vậy, odds và tỷ lệ gần như bằng nhau, nên dạng đơn giản \(P \approx I \times \bar d\) cũng cho con số gần đúng như thế. Gordis Epidemiology chỉ trình bày dạng đơn giản này, kèm điều kiện hiện mắc không quá cao (Celentano và Szklo 2019, tr. 59); khi hiện mắc lớn thì phải dùng dạng odds.
Công thức này giải thích vì sao trực giác về hiện mắc dễ sai. Giả sử có một thuốc mới giúp người bệnh mạn tính sống lâu hơn nhưng không chữa khỏi: tỷ suất mới mắc không đổi, nhưng \(\bar d\) tăng nên hiện mắc tăng, và lúc ấy con số hiện mắc cao hơn lại là tin tốt. Ngược lại, một bệnh cấp tính gây tử vong nhanh có thể có tỷ suất mới mắc cao mà hiện mắc rất thấp, vì người bệnh rời nhóm hiện mắc gần như ngay lập tức. Hệ quả của điều này cho các nghiên cứu chỉ chọn ca hiện mắc sẽ bàn ở Chương 9, còn hệ quả cho sàng lọc xin dành cho Chương 11.
1.7 Đo tử vong và một số số đo đặc biệt
1.7.1 Tỷ suất tử vong thô và đặc hiệu
Tỷ suất tử vong (mortality rate) là tỷ suất mới mắc mà “ca” là ca tử vong. Thống kê dân số thường không có người-thời gian của từng người, nên ta lấy dân số giữa năm làm số xấp xỉ cho số người-năm của năm ấy (Celentano và Szklo 2019, tr. 68; Szklo và Nieto 2014, tr. 58–59):
Số ca tử vong (do mọi nguyên nhân, hoặc một nguyên nhân) trong năm
\(N\)
“en hoa”
Dân số giữa năm; mỗi người sống trọn năm đóng góp một người-năm, nên \(N\) xấp xỉ người-thời gian của năm đó
Tính cho cả quần thể thì có tỷ suất thô (crude rate), còn tính riêng cho một nhóm tuổi, một giới hay một nguyên nhân tử vong thì có tỷ suất đặc hiệu (specific rate): tỷ suất đặc hiệu theo tuổi, theo giới, theo nguyên nhân. Chẳng hạn, năm 2024, tỷ suất tử vong do mọi nguyên nhân của nam giới Bạch Hải là 10,1, của nữ giới là 9,4 trên 1.000 người-năm.
Đoán trước khi đọc tiếp · mức khó. Năm 2024, tỷ suất tử vong thô của Bạch Hải cao hơn của Lục Vân. Nếu so riêng từng nhóm tuổi, bạn đoán sẽ thấy gì?
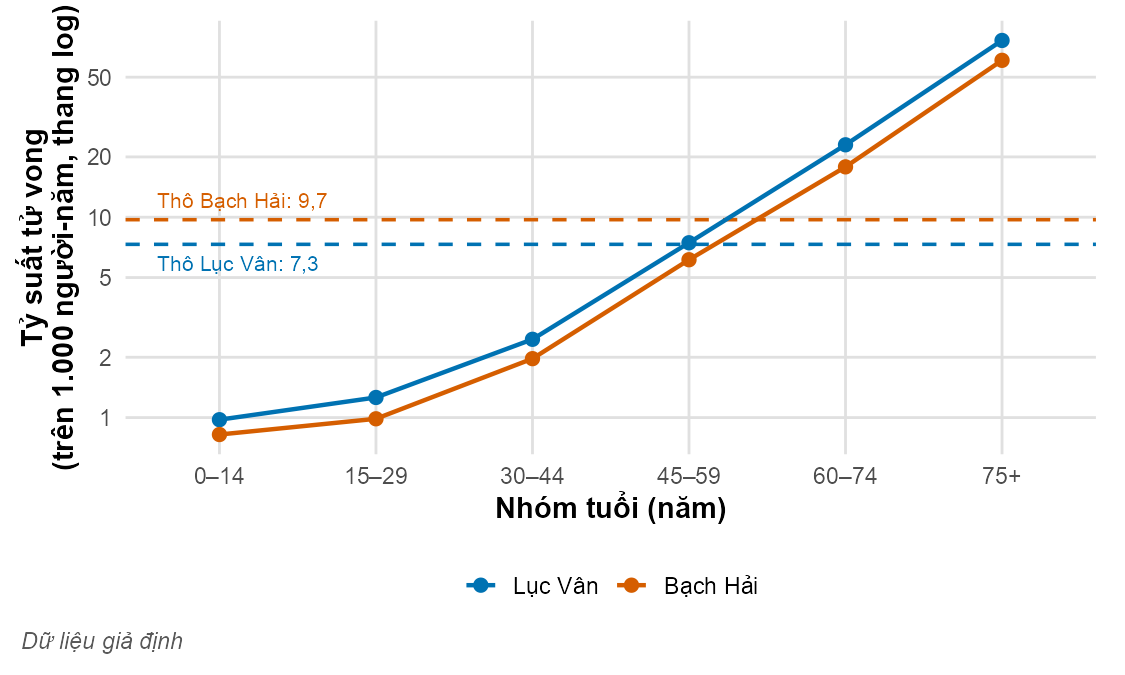
Giờ đem so hai tỉnh Lục Vân và Bạch Hải năm 2024, trong dữ liệu giả định (hypothetical data). Bạch Hải có 11.663 ca tử vong trên 1.200.000 dân, tỷ suất thô 9,7 trên 1.000 người-năm; Lục Vân có 5.858 ca trên 800.000 dân, tỷ suất thô 7,3. Nhìn vậy, Bạch Hải có vẻ tệ hơn. Nhưng xem tỷ suất đặc hiệu theo tuổi (Hình 1.6) thì ở mọi nhóm tuổi, tỷ suất của Lục Vân đều cao hơn: tỷ số Bạch Hải/Lục Vân chỉ từ 0,78 đến 0,84.
Chi tiết bộ dữ liệu
Tử vong ở hai tỉnh (hai_tinh, xem thêm Mục C.3.1).
Nội dung. Năm 2024, cho mỗi tỉnh, theo giới và nhóm tuổi: dân số giữa năm, số ca tử vong do mọi nguyên nhân, và số ca tử vong do bệnh hô hấp mạn tính và ung thư phổi.
Nguồn số tử vong. Hệ thống đăng ký hộ tịch; bộ dữ liệu coi hệ thống này ghi nhận đầy đủ mọi ca.
Mẫu số. Dân số giữa năm được dùng thẳng làm số người-năm của năm 2024.
Phần dùng ở chương khác. Số ca đái tháo đường típ 2 mới chẩn đoán, lấy từ sổ đăng ký, dùng ở Chương 2 và Chương 8. Bộ dữ liệu coi sổ ghi đủ mọi ca, và hai tỉnh ghi theo cùng một cách.
Xem mã R
hinh_tu_vong_tuoi() +gia_dinh()
Hình 1.6: Tỷ suất tử vong đặc hiệu theo tuổi ở hai tỉnh năm 2024 (thang log); hai đường ngang đứt là tỷ suất thô. Ở mọi nhóm tuổi, Lục Vân cao hơn Bạch Hải, nhưng tỷ suất thô của Bạch Hải lại cao hơn. Dữ liệu giả định.
Làm sao một tỉnh có thể tốt hơn ở mọi lứa tuổi mà tỷ suất thô vẫn cao hơn? Câu đố này là điểm xuất phát của Chương 2, và lời giải cũng nằm ở đó. Ở đây chỉ cần nhớ: tỷ suất thô là con số có thật, nhưng đem hai tỷ suất thô so với nhau có thể dẫn đến kết luận ngược với tỷ suất đặc hiệu.
1.7.2 Tỷ lệ tử vong trong số ca bệnh
Tỷ lệ tử vong trong số ca bệnh (case fatality) trả lời một câu hỏi khác hẳn: trong số người đã mắc bệnh, bao nhiêu phần chết vì bệnh trong một khoảng thời gian xác định (Celentano và Szklo 2019, tr. 68–69)?
\[
\begin{array}{c}\text{tỷ lệ tử vong}\\ \text{trong số ca bệnh}\end{array} = \dfrac{\begin{array}{c}\text{số ca bệnh tử vong do bệnh}\\ \text{trong thời gian xác định}\end{array}}{\text{số ca bệnh}}
\tag{1.8}\]
Số người bệnh chết vì chính bệnh đó trong một khoảng thời gian nêu rõ, ví dụ trong 28 ngày
Mẫu số
Số ca bệnh, không phải toàn bộ quần thể
Mẫu số là số ca bệnh, nên đây là tỷ lệ đo độ nặng của bệnh chứ không phải tỷ suất trong quần thể. Trong đoàn hệ, 433 trong 1.628 biến cố tim mạch gây tử vong trong 28 ngày: tỷ lệ tử vong trong số ca bệnh là 26,6%. Con số này tăng theo tuổi, từ 17% ở nhóm 40–54 lên 33% ở nhóm 65–74. Tiếng Anh thường gọi là “case fatality rate”, nhưng mẫu số của nó không có người-thời gian (Lash và c.s. 2021, ch 4).
1.7.3 Tỷ lệ tấn công
Trong một vụ dịch nguồn điểm (point-source outbreak, xem Chương 12), mọi người cùng chịu một phơi nhiễm (exposure), ví dụ ăn cùng một bữa, trong một thời gian ngắn và đã biết, rồi được theo dõi qua thời gian ủ bệnh. Tỷ lệ người mắc trong số người phơi nhiễm gọi là tỷ lệ tấn công (attack rate) (Celentano và Szklo 2019, tr. 32, 50–51). Đó là nguy cơ trong một khoảng thời gian ngắn, ngầm hiểu là thời gian của vụ dịch. Ở tiệc cưới xã E, 151 trong 310 khách được phỏng vấn đạt định nghĩa ca bệnh: tỷ lệ tấn công chung là 48,7%. Mẫu số ở đây là số khách được phỏng vấn, chứ không phải mọi khách dự tiệc. Cũng như “case fatality rate”, “attack rate” là một tỷ lệ dù tên tiếng Anh có chữ “rate”. Tỷ lệ tấn công theo từng món ăn, công cụ chính để tìm ra món gây bệnh, sẽ được trình bày ở Chương 12.
1.7.4 Tỷ lệ tử vong theo nguyên nhân
Tỷ lệ tử vong theo nguyên nhân (proportionate mortality) là số ca tử vong do một nguyên nhân chia cho tổng số ca tử vong (Celentano và Szklo 2019, tr. 69–71). Mẫu số là người chết chứ không phải người sống, nên con số này cho biết một nguyên nhân chiếm bao nhiêu phần trong các ca tử vong, chứ không cho biết nguy cơ chết vì nguyên nhân đó.
Năm 2024, hai nhóm tuổi cao nhất của Lục Vân cho thấy rõ cái bẫy này. Bệnh hô hấp mạn tính và ung thư phổi chiếm 7,3% số ca tử vong ở nhóm 60–74 và 6,7% ở nhóm 75+. Nhìn tỷ lệ ấy, người ta dễ nghĩ bệnh hô hấp “ít nguy hiểm hơn” ở người già nhất. Nhưng tỷ suất tử vong do hô hấp ở hai nhóm là 168 và 512 trên 100.000 người-năm: tỷ suất tử vong do bệnh hô hấp ở người từ 75 tuổi cao gấp 3,0 lần. Tỷ lệ theo nguyên nhân thấp hơn chỉ vì các nguyên nhân khác còn tăng nhanh hơn.
1.7.5 Odds
Số đo cuối cùng của chương sẽ được dùng nhiều ở các chương sau. Odds (tiếng Anh giữ nguyên; một số tài liệu gọi là “số chênh”) của một biến cố là xác suất biến cố ấy xảy ra chia cho xác suất nó không xảy ra (Szklo và Nieto 2014, tr. 73; Lash và c.s. 2021, ch 4):
Odds của biến cố trong khoảng thời gian đang xét; từ 0 đến vô cùng
\(R\)
“R”
Nguy cơ của biến cố trong cùng khoảng thời gian
\(1 - R\)
“một trừ R”
Xác suất không có biến cố
Đoán trước khi đọc tiếp · mức dễ. Nguy cơ 10 năm của cả đoàn hệ là 0,081. Odds tương ứng sẽ thế nào?
Odds chỉ gần bằng nguy cơ khi nguy cơ nhỏ. Nguy cơ 10 năm của cả đoàn hệ là 0,081, odds là 0,089: gần như bằng nhau. Ở nam 65–74 tuổi có THA, nguy cơ là 0,30 nhưng odds là 0,43: chênh nhau rõ rệt. Odds luôn lớn hơn nguy cơ; khi nguy cơ lớn, khoảng cách trở nên đáng kể, và khi nguy cơ vượt quá một nửa thì odds vượt quá 1. Điều này sẽ quan trọng khi so sánh hai odds ở Chương 3.
Cuối cùng là một số đo gánh nặng đáng biết tên: số năm sống tiềm năng bị mất (years of potential life lost, YPLL). Thay vì coi mọi ca tử vong như nhau, YPLL cộng số năm còn thiếu so với một mốc tuổi chọn trước, nên một ca tử vong ở người trẻ nặng hơn nhiều so với một ca ở người rất già. YPLL làm nổi bật tai nạn, bạo lực và các bệnh gây tử vong sớm, những nguyên nhân vốn ít nổi bật trong tỷ suất tử vong thô (Celentano và Szklo 2019, tr. 71).
1.8 Giới hạn: khi con số tần suất đánh lừa
Số đo nào trong chương này cũng là một phân số, nên cũng thừa hưởng mọi sai sót của tử số, của mẫu số và của khoảng thời gian.
Tử số phụ thuộc vào việc tìm ca. Ở tiệc cưới xã E, số ca xác định tùy vào việc ai được lấy mẫu phân. Ở mức quần thể cũng vậy: tỉnh nào có hệ thống chẩn đoán tốt hơn thì sẽ “có” nhiều ca hơn. Thấy tỷ lệ hiện mắc tăng sau một đợt sàng lọc, trước hết hãy hỏi xem cách tìm ca có thay đổi không (Celentano và Szklo 2019, tr. 55–58).
Mẫu số thường là một ước lượng. Dân số giữa năm chỉ xấp xỉ người-năm, mà bản thân dân số cũng là một con số ước tính. Dữ liệu hai_tinh dùng thẳng dân số giữa năm làm người-năm, và đó là một cách giản lược. Ở nơi có nhiều người di cư, mẫu số có thể sai đáng kể.
Một con số chung che giấu khác biệt bên trong. Tỷ suất của cả đoàn hệ là 9,0 trên 1.000 người-năm, nhưng tỷ suất ở nhóm 65–74 gấp 5,1 lần nhóm 40–54. Tỷ suất trung bình trên 10 năm cũng che đi mọi thay đổi của tốc độ theo thời gian, trong khi người trong đoàn hệ mỗi năm một già đi. Tỷ suất thô của hai tỉnh là trường hợp cực đoan nhất của chuyện này.
Các công thức liên hệ cần giả định. Công thức mũ cần tỷ suất không đổi và không có nguy cơ cạnh tranh, còn công thức hiện mắc–mới mắc–thời gian mắc cần trạng thái ổn định. Dữ liệu phường D được dựng cho gần trạng thái ổn định; ngoài đời thực, một đợt dịch, một lần đổi tiêu chuẩn chẩn đoán hay một làn sóng di cư đều phá vỡ giả định ấy. Ngay cả \(\bar d\) ở phường D cũng là một ước lượng, vì nhiều đợt chưa kết thúc thì người bệnh đã rời khỏi tầm quan sát.
Số đo tần suất mô tả, không giải thích. Biết nhóm có THA có tỷ suất cao hơn thì vẫn chưa biết THA gây ra bao nhiêu biến cố. Muốn biết điều đó, ta cần những phép so sánh có kiểm soát, là nội dung của Chương 3 và các chương sau.
Hiểu lầm thường gặp
“Tỷ lệ hiện mắc cao hơn nghĩa là bệnh xuất hiện nhiều hơn.” Không nhất thiết. Hiện mắc tăng khi tỷ suất mới mắc tăng, nhưng cũng tăng khi người bệnh sống lâu hơn với bệnh (công thức 1.6). Một thuốc kéo dài sự sống mà không chữa khỏi bệnh sẽ làm hiện mắc tăng, dù không có thêm ca mới nào.
“Nguy cơ 8% là một con số đầy đủ.” Không. Nguy cơ luôn cần khoảng thời gian: trong đoàn hệ, nguy cơ 1 năm là 0,9%, nguy cơ 10 năm là 8,1%.
“Mọi con số có chữ ‘rate’ đều là tỷ suất.” Không. “Attack rate” và “case fatality rate” là tỷ lệ, vì mẫu số là số người chứ không phải người-thời gian. Ngược lại, có sách lại gọi nguy cơ là “incidence rate”. Vậy nên luôn xem mẫu số.
“Có thể nhân tỷ suất với thời gian để ra nguy cơ.” Chỉ khi tích \(I\,\Delta t\) nhỏ. Với nam 65–74 tuổi có THA, phép nhân cho 43%, trong khi công thức mũ cho 35% và thực tế chỉ 30%.
“Tỷ lệ tử vong theo nguyên nhân tăng tức là nguy cơ tử vong do nguyên nhân đó tăng.” Không. Đó là phần của nguyên nhân ấy trong tổng số ca tử vong, nên con số này tăng khi các nguyên nhân khác giảm, và có thể giảm trong khi nguy cơ tăng, như bệnh hô hấp ở người cao tuổi Lục Vân.
“Người bị chặn quan sát có thể bỏ ra khỏi mẫu số.” Không. Bỏ họ đi là làm như thể họ chưa từng có nguy cơ, trong khi họ đã đóng góp thời gian theo dõi không biến cố. Hãy giữ phần người-thời gian mà họ đóng góp cho đến lúc bị chặn.
Tự kiểm tra
Ngày 01/01/2023, trong 3.012 người đang cư trú ở phường D có 58 người đang trong một đợt trầm cảm. Phân số 58/3.012 là số đo gì?
Đây là bức ảnh chụp tại một ngày: tử số là mọi người đang mắc, dù cũ hay mới, còn mẫu số là mọi người có mặt ngày đó. Vậy đó là tỷ lệ hiện mắc điểm, 1,9%. Con số này không cho biết tốc độ khởi phát đợt mới; muốn biết thì cần tỷ suất mới mắc, 41,2 trên 1.000 người-năm có nguy cơ.
Một nhóm 200 người, lúc đầu chưa ai mắc bệnh, được theo dõi 5 năm, không ai dừng theo dõi giữa chừng. Có 10 người mắc bệnh, tất cả vào cuối năm thứ 4. Tính tỷ suất mới mắc trên 1.000 người-năm, lấy một chữ số thập phân.
190 người không mắc đóng góp 5 năm mỗi người; 10 người mắc đóng góp 4 năm mỗi người. \(T = 190 \times 5 + 10 \times 4 = 990\) người-năm, nên \(I = 10 / 990\), tức 10,1 trên 1.000 người-năm. Nguy cơ 5 năm là 10/200 = 5%.
Đúng hay sai: “Tỷ suất biến cố tim mạch của đoàn hệ là 9,0 trên 1.000 người-năm, nghĩa là cứ 1.000 người thì có 9,0 người có biến cố.”
Sai. Mẫu số là người-năm chứ không phải người. Muốn biết tỷ lệ người có biến cố, cần nguy cơ kèm khoảng thời gian: 8,1% trong 10 năm.
Một bệnh có tỷ suất mới mắc không đổi 50 trên 1.000 người-năm, không có nguy cơ cạnh tranh. Nguy cơ trong 10 năm là bao nhiêu phần trăm (một chữ số thập phân)?
\(I\,\Delta t = 0{,}05 \times 10 = 0{,}5\), lớn quá nên không dùng phép xấp xỉ được (phép xấp xỉ sẽ cho 50%). Công thức mũ cho \(R = 1 - e^{-0{,}5} = 0{,}393\), tức 39,3%.
Hai phòng khám có cùng tỷ suất mới mắc của một bệnh mạn tính, cả hai ở trạng thái ổn định và hiện mắc thấp. Bệnh nhân của phòng khám A sống với bệnh lâu gấp đôi bệnh nhân của phòng khám B. So sánh tỷ lệ hiện mắc của hai nơi.
Theo công thức 1.6, khi hiện mắc thấp, \(P \approx I \times \bar d\). Cùng \(I\) mà \(\bar d\) gấp đôi thì \(P\) xấp xỉ gấp đôi. Phương án thứ nhất là một hiểu lầm phổ biến: thật ra hiện mắc phụ thuộc cả tốc độ mắc mới lẫn thời gian mắc bệnh.
Một báo cáo viết: “Tai nạn giao thông chiếm phần lớn số ca tử vong ở nam giới trẻ.” Câu này cho biết điều gì?
Đây là tỷ lệ tử vong theo nguyên nhân: mẫu số là người chết. Ở người trẻ, ít ai chết vì bệnh mạn tính, nên tai nạn chiếm tỷ trọng lớn ngay cả khi nguy cơ chết vì tai nạn không cao. Muốn so sánh nguy cơ, cần tỷ suất tử vong do tai nạn theo nhóm.
Ở nam 65–74 tuổi có THA trong đoàn hệ, nguy cơ biến cố tim mạch 10 năm (làm tròn) là 0,30. Odds tương ứng là bao nhiêu (hai chữ số thập phân)?
\(\text{odds} = R/(1-R) = 0{,}30 / 0{,}70 = 0{,}43\). Odds lớn hơn hẳn nguy cơ vì nguy cơ không nhỏ; còn với nguy cơ chung của đoàn hệ, 0,081, odds chỉ là 0,089.
Một chiến dịch sàng lọc đái tháo đường ở một xã phát hiện rất nhiều ca trong năm đầu, rồi ít hơn hẳn ở các năm sau, dù tỷ suất mới mắc trong xã không đổi. Năm đầu, chiến dịch chủ yếu đang đo điều gì? Giải thích bằng một hoặc hai câu.
Năm đầu, chiến dịch “vét” cả nhóm hiện mắc tích tụ từ trước nhưng chưa được chẩn đoán, nên số ca chủ yếu phản ánh tỷ lệ hiện mắc. Từ năm thứ hai, nhóm này đã được tìm ra, nên số ca mới phát hiện gần với số ca mới mắc trong năm, tức là phản ánh tỷ suất mới mắc.
Thực hành R
Phần này hướng dẫn làm lại các phép tính của chương bằng R, với vài dòng mã bạn có thể chép về dùng. Mã vẽ các hình của chương nằm trong R/ch01.R. Các tệp dữ liệu tải trực tiếp được, ví dụ https://youcan-e64.pages.dev/nckh/data/doan_he_tim_mach.csv; đổi tên tệp ở cuối địa chỉ là tải được quan_the_mo.csv, quan_the_mo_dot.csv và hai_tinh.csv.
Hiện mắc tăng huyết áp
Đọc dữ liệu đoàn hệ rồi tính tỷ lệ hiện mắc THA, chung và theo nhóm tuổi × giới. Hãy kiểm tra xem có đúng 20.000 dòng và tỷ lệ chung là 0,300 không. R in số thập phân bằng dấu chấm.
Xem mã R
tm <-read_csv(dth_path("data/doan_he_tim_mach.csv"), show_col_types =FALSE)nrow(tm) # số người lúc khám nền
# A tibble: 6 × 5
  nhom_tuoi gioi  so_nguoi so_tha ty_le
  <chr>     <chr>    <int>  <dbl> <dbl>
1 40-54     nam       4192    606 0.145
2 40-54     nu        4639    683 0.147
3 55-64     nam       3200   1089 0.340
4 55-64     nu        3467   1168 0.337
5 65-74     nam       2210   1198 0.542
6 65-74     nu        2292   1257 0.548
Nguy cơ và tỷ suất theo nhóm tuổi
Cột thoi_gian là thời gian có nguy cơ của từng người, nên cộng cả cột lại là được người-thời gian \(T\). Mỗi dòng kết quả phải khớp với Bảng 1.3.
Xem mã R
tm |>group_by(nhom_tuoi) |>summarise(so_nguoi =n(),bien_co =sum(bien_co_tm),nguoi_nam =sum(thoi_gian), # tổng người-thời gian có nguy cơnguy_co = bien_co / so_nguoi, # nguy cơ 10 năm (tỷ lệ đơn giản)ty_suat_1000 = bien_co / nguoi_nam *1000) # trên 1.000 người-năm
Với mỗi tầng tuổi × giới, đem nguy cơ quan sát so với \(I\,\Delta t\) và \(1 - e^{-I\,\Delta t}\), rồi tìm tầng mà phép xấp xỉ sai nhiều nhất.
Xem mã R
tm |>group_by(nhom_tuoi, gioi) |>summarise(R_quan_sat =mean(bien_co_tm),IdT =sum(bien_co_tm) /sum(thoi_gian) *10, # tỷ suất mỗi năm × 10 năm.groups ="drop") |>mutate(R_cong_thuc_mu =1-exp(-IdT))
# A tibble: 6 × 5
  nhom_tuoi gioi  R_quan_sat    IdT R_cong_thuc_mu
  <chr>     <chr>      <dbl>  <dbl>          <dbl>
1 40-54     nam       0.0561 0.0590         0.0573
2 40-54     nu        0.0228 0.0234         0.0232
3 55-64     nam       0.115  0.131          0.122
4 55-64     nu        0.0531 0.0567         0.0551
5 65-74     nam       0.227  0.302          0.261
6 65-74     nu        0.102  0.120          0.113
Ở nam 65–74 tuổi, phép xấp xỉ cho 0,302, công thức mũ cho 0,261, còn nguy cơ quan sát chỉ là 0,227 vì tử vong cạnh tranh.
Quần thể mở phường D
Bước này tính người-thời gian có nguy cơ, tỷ suất khởi phát đợt trầm cảm và thời gian mắc bệnh trung bình. Chỗ khó duy nhất là cắt mỗi đợt cho khớp với khoảng thời gian người đó thật sự được quan sát.
Xem mã R
nguoi <-read_csv(dth_path("data/quan_the_mo.csv"), show_col_types =FALSE)dot <-read_csv(dth_path("data/quan_the_mo_dot.csv"), show_col_types =FALSE) |>left_join(select(nguoi, id, ngay_vao, ngay_ra), by ="id") |>mutate(tu =pmax(ngay_bat_dau, ngay_vao), # phần đợt nằm trong thời gian quan sátden =pmin(coalesce(ngay_ket_thuc, ngay_ra), ngay_ra),nam_trong_dot =as.numeric(den - tu) /365.25)T_tong <-sum(as.numeric(nguoi$ngay_ra - nguoi$ngay_vao)) /365.25# người-năm quan sátT_dot <-sum(dot$nam_trong_dot) # người-năm đang trong đợtso_dot_moi <-sum(dot$ngay_bat_dau >= dot$ngay_vao) # đợt khởi phát khi đang được quan sátI_dot <- so_dot_moi / (T_tong - T_dot) # mỗi người-năm có nguy cơd_tb <- T_dot /sum(!is.na(dot$ngay_ket_thuc)) # thời gian mắc trung bình (năm)c(ty_suat_1000 = I_dot *1000, d_tb = d_tb, I_x_d = I_dot * d_tb)
            P odds_quan_sat du_doan_I_x_d
   0.01925631    0.01963439    0.01912455
Kết quả khớp với chương: tỷ suất 41,2 trên 1.000 người-năm có nguy cơ, \(\bar d\) = 0,46 năm, odds dự đoán 0,0191 và odds quan sát 0,0196 (hiện mắc quan sát 0,0193). Hãy thử đổi ngay sang ngày đầu của các năm khác để thấy hiện mắc điểm dao động ngẫu nhiên thế nào.
Tỷ suất tử vong thô và đặc hiệu của hai tỉnh
Mã dưới đây tính tỷ suất thô của mỗi tỉnh, rồi đặt tỷ suất đặc hiệu theo tuổi của hai tỉnh cạnh nhau. Hàm hinh_tu_vong_tuoi() trong R/ch01.R dùng đúng các con số này để vẽ Hình 1.6.
Số đo tần suất nào cũng là một phân số, nên hãy luôn hỏi: tử số đếm ai, mẫu số gồm ai, và trong bao lâu. Tỷ lệ, tỷ số và tỷ suất là ba loại phân số khác nhau.
Tỷ lệ hiện mắc là bức ảnh chụp tại một thời điểm: tốt cho lập kế hoạch nhưng kém khi tìm nguyên nhân. Ở đoàn hệ Bạch Hải, 30,0% người bị THA lúc khám nền.
Nguy cơ là xác suất mắc trong một khoảng thời gian nêu rõ; tỷ suất là tốc độ xuất hiện ca mới trên người-thời gian. Đoàn hệ có nguy cơ 10 năm 8,1% và tỷ suất 9,0 trên 1.000 người-năm.
Quan sát bị chặn và nguy cơ cạnh tranh làm phép chia đơn giản \(A/N\) khó diễn giải; người-thời gian giữ đúng phần đóng góp của mỗi người.
\(R \approx I\,\Delta t\) chỉ đúng khi tích nhỏ; công thức mũ đúng hơn khi tỷ suất không đổi và không có nguy cơ cạnh tranh. Ở trạng thái ổn định, odds hiện mắc bằng \(I \times \bar d\).
“Attack rate” và “case fatality rate” là tỷ lệ; tỷ lệ tử vong theo nguyên nhân không đo nguy cơ; tỷ suất thô của hai quần thể khác cơ cấu tuổi có thể đánh lừa, như ở Chương 2.
Đọc thêm.
Gordis Epidemiology trình bày các số đo bệnh tật và tử vong cho người đọc lâm sàng, với nhiều ví dụ về tử số và mẫu số (Celentano và Szklo 2019, tr. 41–89).
Szklo và Nieto trình bày nguy cơ, tỷ suất, phương pháp Kaplan–Meier và quan hệ hiện mắc–mới mắc rất chặt chẽ (Szklo và Nieto 2014, tr. 47–73).
Modern Epidemiology là nguồn chuẩn cho định nghĩa: quần thể đóng và mở, người-thời gian, công thức mũ, nguy cơ cạnh tranh và trạng thái ổn định (Lash và c.s. 2021, ch 4).
Celentano, David D., và Moyses Szklo. 2019. Gordis Epidemiology. 6th ab. Philadelphia, PA: Elsevier.
Lash, Timothy L., Tyler J. VanderWeele, Sebastien Haneuse, và Kenneth J. Rothman. 2021. Modern Epidemiology. 4th ab. Philadelphia, PA: Wolters Kluwer.
Szklo, Moyses, và F. Javier Nieto. 2014. Epidemiology: Beyond the Basics. 3rd ab. Burlington, MA: Jones & Bartlett Learning.