Xem mã R
hinh_nen() + gia_dinh()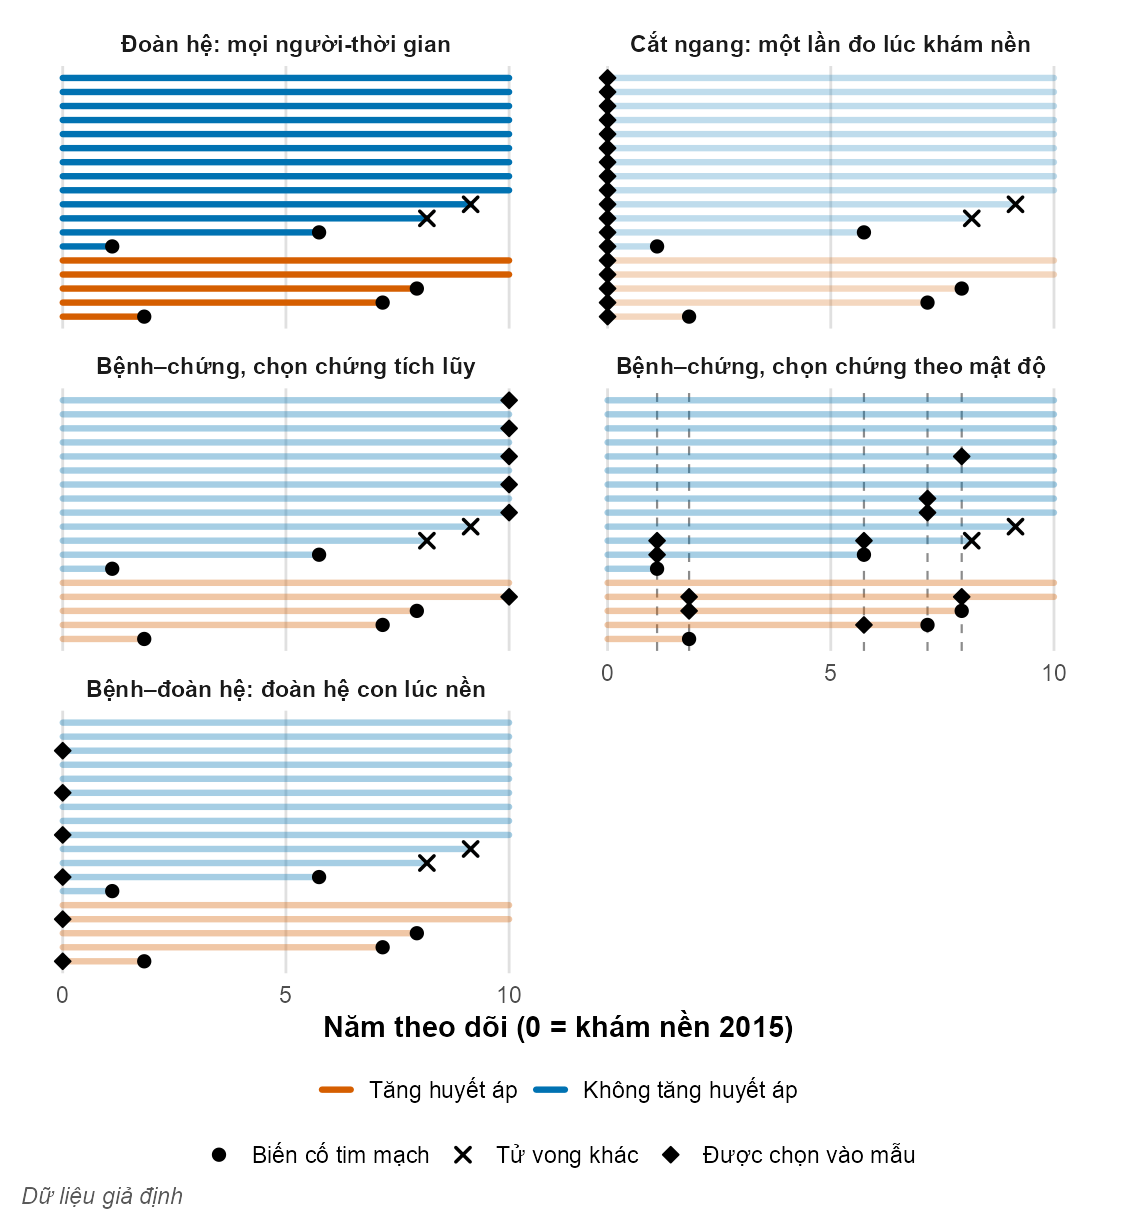
Muốn biết tăng huyết áp có làm tăng biến cố tim mạch hay không, ta có thể khám 20.000 người ở tỉnh Bạch Hải rồi theo dõi họ suốt 10 năm; trong dữ liệu giả định của sách, đó chính là việc của đoàn hệ tim mạch Bạch Hải. Nhưng còn một cách khác, rẻ hơn rất nhiều: chỉ nhìn kỹ 1.628 người đã có biến cố, cùng một nhóm so sánh được chọn khéo. Cách thứ hai chỉ cần số hồ sơ bằng 41% số người của đoàn hệ, vậy mà có thể cho câu trả lời gần như y hệt. Vì sao?
Câu hỏi của chương: mỗi thiết kế nghiên cứu lấy mẫu phần nào của thực tế, và vì thế đo được đại lượng nào? Học xong chương này, bạn có thể:
Chương này dùng lại các khái niệm nguy cơ, tỷ suất, người-thời gian và tỷ lệ hiện mắc ở Chương 1, cùng các số đo kết hợp ở Chương 3, nên sẽ không nhắc lại định nghĩa.
Mọi số liệu trong chương này đều là dữ liệu giả định, mô phỏng từ mô hình có hạt giống ngẫu nhiên cố định, và không phản ánh địa phương hay cơ sở y tế có thật nào. Chương này dùng đoàn hệ doan_he_tim_mach (Mục C.3.7), bốn mẫu bệnh–chứng rút từ chính đoàn hệ ấy (bc_tich_luy, bc_mat_do, ca_benh_doan_he, bc_benh_vien; Mục C.3.11), thử nghiệm thu_nghiem_sms (Mục C.3.15) và hai bộ sinh_thai_xa, sinh_thai_ca_nhan (Mục C.3.20).
Nghiên cứu nào về nguyên nhân bệnh cũng bắt đầu từ một câu hỏi đặt cho một quần thể cụ thể, trong một khoảng thời gian cụ thể. Với câu hỏi về tăng huyết áp (THA), quần thể ấy là đoàn hệ tim mạch Bạch Hải (Chương 1, chi tiết ở Mục C.3.7). Đoàn hệ gồm 20.000 người 40–74 tuổi, chọn ngẫu nhiên từ dân cư của tỉnh nên đại diện cho người lứa tuổi ấy ở Bạch Hải. Năm 2015, họ được khám lần đầu, gọi là khám nền, để biết ai có THA; sau đó họ được theo dõi đến năm 2025, không ai bỏ dở giữa chừng. Cộng số năm theo dõi của từng người lại thì được 181.699 người-năm (person-years). Trong chừng ấy thời gian có 1.628 biến cố tim mạch, tức lần đầu một người bị đột quỵ, nhồi máu cơ tim hoặc tử vong do tim mạch.
Toàn bộ người-thời gian (person-time) ấy là nền nghiên cứu (study base), tức phần thực tế đã sinh ra các ca bệnh. Quần thể đóng góp chỗ người-thời gian đó là quần thể nguồn (source population). Nghiên cứu lý tưởng sẽ quan sát toàn bộ nền nghiên cứu. Thiết kế nghiên cứu (study design) là cách ta chọn quan sát phần nào của nền ấy, và đo gì trên phần được chọn (Lash và c.s. 2021, ch 6 và 8).
Hình 4.1 vẽ một nhóm nhỏ người trong đoàn hệ. Mỗi đường là một người, kéo dài từ lúc khám nền đến khi có biến cố, tử vong vì nguyên nhân khác, hoặc hết 10 năm. Mỗi ô là một thiết kế, tức một cách cắt lát riêng trên cùng một nền. Đoàn hệ dùng mọi đường, thiết kế cắt ngang chỉ nhìn một lát dọc ở thời điểm khám nền, còn ba kiểu bệnh–chứng đều lấy mọi ca bệnh nhưng chọn người so sánh ở những chỗ khác nhau trên các đường. Phần sau của chương sẽ cho thấy cắt ở chỗ nào thì quyết định ta thu được con số nào.
hinh_nen() + gia_dinh()Hai câu hỏi đầu tiên đã đủ xếp loại phần lớn các thiết kế. Câu hỏi thứ nhất: nghiên cứu chỉ mô tả bệnh phân bố ra sao theo con người, nơi chốn, thời gian, hay có so sánh các nhóm để kiểm định một giả thuyết? Câu hỏi này tách nghiên cứu mô tả (descriptive study) khỏi nghiên cứu phân tích (analytic study) (Szklo và Nieto 2014, tr. 3). Báo cáo ca bệnh (case report) hay loạt ca bệnh (case series) thuộc nhóm mô tả: chúng gợi ý giả thuyết nhưng không có nhóm so sánh (Celentano và Szklo 2019, tr. 149).
Câu hỏi thứ hai: ai quyết định người nào phơi nhiễm (exposure)? Trong nghiên cứu thực nghiệm (experimental study), nhà nghiên cứu phân bổ phơi nhiễm; trong nghiên cứu quan sát (observational study), nhà nghiên cứu chỉ ghi nhận phơi nhiễm đúng như thực tế đã diễn ra (Lash và c.s. 2021, ch 6). Không ai có thể phân bổ THA cho người khác, nên mọi nghiên cứu về THA trong chương này đều là nghiên cứu quan sát. Còn một chương trình nhắn tin nhắc uống thuốc thì phân bổ được, như trong thử nghiệm SMS.
Các thiết kế không xếp thành bậc thang từ “kém” đến “tốt”: mỗi thiết kế hợp với một loại câu hỏi, một mức kinh phí và những ràng buộc đạo đức riêng. Bảng 4.1 tóm tắt các thiết kế theo đơn vị quan sát, cách lấy mẫu nền nghiên cứu và số đo tính được.
| Thiết kế | Đơn vị | Lấy mẫu nền nghiên cứu thế nào | Số đo tính được (xem Chương 3) |
|---|---|---|---|
| Sinh thái | Nhóm (xã, tỉnh) | Tóm tắt phơi nhiễm và bệnh của từng nhóm | Tương quan, hồi quy cấp nhóm |
| Cắt ngang | Người | Một lát tại một thời điểm | Tỷ lệ hiện mắc, PR, POR |
| Đoàn hệ | Người | Toàn bộ người-thời gian sau khi đo phơi nhiễm | Nguy cơ, tỷ suất, RR, IRR, RD |
| Thử nghiệm ngẫu nhiên | Người (hoặc nhóm) | Như đoàn hệ, nhưng phơi nhiễm do phân bổ ngẫu nhiên | Như đoàn hệ |
| Bệnh–chứng | Người | Mọi ca bệnh và một mẫu của nền | OR; ý nghĩa tùy cách chọn chứng |
Trong nghiên cứu sinh thái (ecological study), đơn vị phân tích là một nhóm người: một xã, một tỉnh, một quốc gia. Phơi nhiễm và kết cục (outcome) chỉ có ở dạng con số tóm tắt cho cả nhóm, như tỷ lệ hộ có nước sạch hay tỷ suất tử vong của tỉnh. Ta biết có bao nhiêu người phơi nhiễm, bao nhiêu người mắc bệnh, nhưng không biết người mắc bệnh có chính là người phơi nhiễm hay không (Celentano và Szklo 2019, tr. 150–154; Lash và c.s. 2021, ch 30).
Bộ dữ liệu sinh_thai_xa gồm 30 xã giả định của tỉnh Lục Vân, khảo sát năm 2024. Ở mỗi xã, 1.000 người trưởng thành được hỏi có điện thoại thông minh hay không, và đã được chẩn đoán đái tháo đường (ĐTĐ) hay chưa. Tỷ lệ có điện thoại thông minh dao động từ 6% đến 94%, còn tỷ lệ ĐTĐ từ 1,6% đến 12,1%. Hai tỷ lệ gần như nằm trên một đường thẳng: xã nào nhiều điện thoại thì cũng nhiều ĐTĐ (Hình 4.2, trái). Hệ số tương quan, tức con số cho biết các điểm bám sát một đường thẳng đến đâu, là 0,98. Kéo dài đường thẳng ấy (đường hồi quy) ra hai đầu thì một xã ai cũng có điện thoại thông minh sẽ có tỷ lệ ĐTĐ gấp 9,6 lần một xã không ai có.
Khảo sát điện thoại thông minh và ĐTĐ ở Lục Vân (sinh_thai_xa và sinh_thai_ca_nhan).
Ở mỗi xã, người được hỏi là một mẫu ngẫu nhiên người trưởng thành của xã, và dữ liệu giả định coi như ai cũng trả lời đúng. Bộ sinh_thai_ca_nhan là dữ liệu từng người của chính các cuộc khảo sát ấy, gồm 30.000 người; bộ sinh_thai_xa chỉ giữ lại hai tỷ lệ tóm tắt của mỗi xã. Mô tả đầy đủ ở Mục C.3.20 và Mục C.3.21.
Đoán trước khi đọc tiếp · mức khó. Trong cùng một xã, người có điện thoại thông minh có tỷ lệ ĐTĐ ra sao so với người không có?
hinh_sinh_thai() + gia_dinh()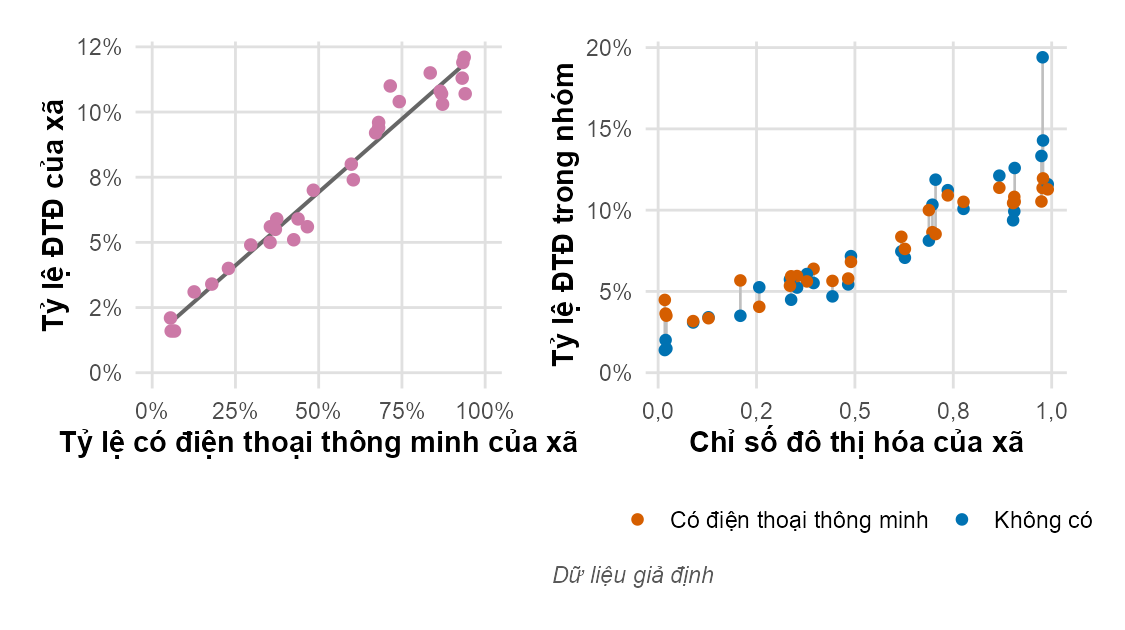
Câu trả lời nằm ở hình bên phải: trong cùng một xã, hai nhóm có tỷ lệ ĐTĐ gần như bằng nhau. Tỷ số hiện mắc (prevalence ratio, PR) là tỷ lệ ĐTĐ ở người có điện thoại chia cho tỷ lệ ấy ở người không có. So sánh hai nhóm trong từng xã rồi gộp 30 xã lại, tức phân tích phân tầng theo xã, thì PR là 1,00 (KTC 95%: 0,91–1,10). Thứ tạo ra tương quan giữa các xã là mức đô thị hóa. Trong dữ liệu giả định, mỗi xã có một chỉ số đô thị hóa, và chính chỉ số ấy quyết định cả hai tỷ lệ: xã càng đô thị thì càng nhiều điện thoại và càng nhiều ĐTĐ. Từ dữ liệu cấp xã mà kết luận “người dùng điện thoại thông minh dễ mắc ĐTĐ” là rơi vào ngụy biện sinh thái (ecological fallacy): gán cho cá nhân một mối liên quan chỉ đúng ở cấp nhóm (Celentano và Szklo 2019, tr. 153).
Ngay cả dữ liệu cá nhân cũng dễ đánh lừa nếu bỏ qua xã: gộp cả 30.000 người lại mà không phân tầng thì PR thô là 1,70 (KTC 95%: 1,56–1,85). Ở đây, xã là một yếu tố gây nhiễu, tức yếu tố gắn với cả phơi nhiễm lẫn bệnh nên làm méo phép so sánh; cơ chế này xin dành cho Chương 7.
Nghiên cứu sinh thái không vô dụng. Đó là thiết kế đúng khi câu hỏi thuộc về nhóm: một chính sách áp cho cả tỉnh như thuế thuốc lá, hay một phơi nhiễm chỉ tồn tại ở cấp cộng đồng như mật độ quán rượu. Thiết kế này lại rẻ, dùng được số liệu có sẵn, và thường là nơi một giả thuyết khởi đầu. Sai chỉ ở chỗ đem kết luận cấp nhóm biến thành kết luận về từng người.
Nghiên cứu cắt ngang (cross-sectional study) đo phơi nhiễm và bệnh trên từng người, tại cùng một thời điểm. Tách riêng ra, lần khám nền năm 2015 của đoàn hệ Bạch Hải chính là một nghiên cứu cắt ngang. Lần khám ấy cho tỷ lệ hiện mắc (prevalence) chứ không cho nguy cơ: 30,0% người có THA, 12,3% người có phì đại thất trái trên điện tim (Celentano và Szklo 2019, tr. 154–157).
Trong lần khám ấy, 29,5% người THA có phì đại thất trái, so với 4,9% người không THA; tỷ số hiện mắc là 6,06 (KTC 95%: 5,57–6,58). Mối liên quan rất mạnh, nhưng lát cắt không cho biết cái nào có trước. THA lâu năm làm dày thất trái, nhưng chỉ với một lần đo thì ta không loại trừ được chiều ngược lại hay một nguyên nhân chung. Trình tự thời gian (temporality) mù mờ như vậy là giới hạn cố hữu của thiết kế cắt ngang.
Giới hạn thứ hai nằm ở chính tỷ lệ hiện mắc. Như Chương 1 đã chỉ ra, tỷ lệ hiện mắc tùy vào cả tỷ suất mới mắc lẫn thời gian mắc bệnh, nên yếu tố nào giúp người bệnh sống lâu hơn với bệnh cũng làm tăng tỷ lệ hiện mắc, dù không làm tăng số ca mới. Vì thế, nghiên cứu cắt ngang về bệnh mạn tính dễ nhầm “yếu tố kéo dài bệnh” với “yếu tố gây bệnh”.
Nghiên cứu đoàn hệ (còn gọi là nghiên cứu thuần tập; cohort study) xác định phơi nhiễm của từng người trước, rồi theo dõi họ theo thời gian để đếm các kết cục mới (Lash và c.s. 2021, ch 7; Celentano và Szklo 2019, tr. 178–181).
Trình tự ấy là điểm mạnh lớn nhất của thiết kế: THA được đo năm 2015, trước mọi biến cố được đếm, nên không còn câu hỏi “cái nào có trước”. Đoàn hệ còn theo dõi được nhiều kết cục cùng lúc: chính 20.000 người ấy cho biết cả biến cố tim mạch, tử vong vì nguyên nhân khác, lẫn bất kỳ bệnh nào khác được ghi nhận.
Đoàn hệ Bạch Hải là quần thể đóng (closed population): mọi người vào cùng lúc, sau đó không thêm ai. Quần thể mở (open population) thì khác, người vào và ra liên tục, nên ta tính người-thời gian thay vì đếm người (xem Chương 1).
Các sách thường chia đoàn hệ thành đoàn hệ tiến cứu (prospective cohort) và đoàn hệ hồi cứu (retrospective cohort). Ranh giới không nằm ở chiều của dữ liệu, mà ở thời điểm nhà nghiên cứu bắt đầu so với lúc các kết cục xảy ra (Hình 4.3). Nhóm nghiên cứu khám người dân năm 2015 rồi chờ biến cố xảy ra thì đó là đoàn hệ tiến cứu. Còn nếu năm 2026, một nhóm khác tìm lại hồ sơ khám năm 2015 và tra cứu biến cố đến năm 2025, thì đó là đoàn hệ hồi cứu. Cả hai cùng một cấu trúc: phơi nhiễm được ghi nhận trước, kết cục được đếm sau; chỉ khác là nhà nghiên cứu đến muộn. Điều thật sự quyết định chất lượng không phải cái nhãn tiến cứu hay hồi cứu, mà là phơi nhiễm có được ghi nhận trước khi kết cục xảy ra hay không (Lash và c.s. 2021, ch 6).
# lint: no-gia-dinh
hinh_tien_hoi_cuu()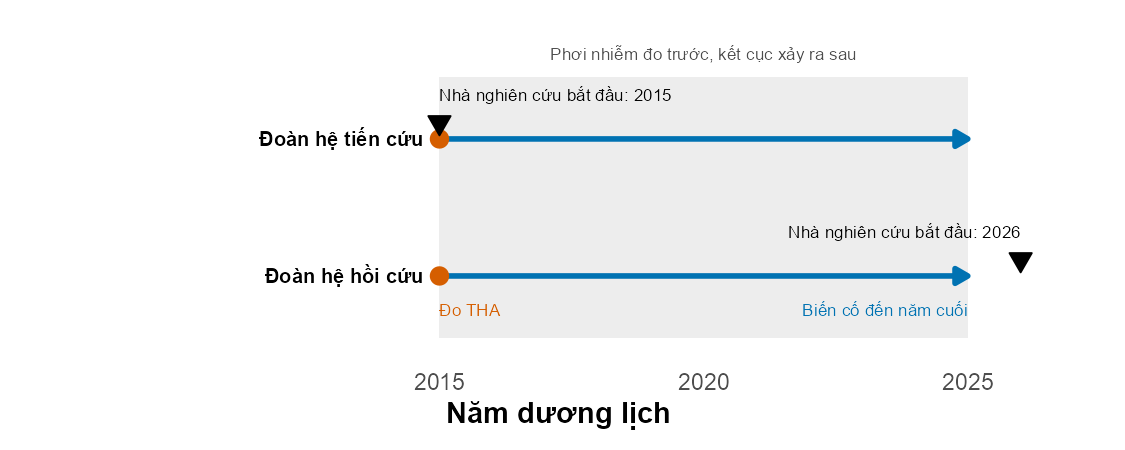
Có mẫu số đầy đủ nên đoàn hệ cho được mọi số đo ở Chương 1 và Chương 3. Hình 4.4 là lưu đồ của đoàn hệ Bạch Hải. Trong 6.001 người THA có 891 biến cố, tức nguy cơ (risk) 10 năm là 14,8%; trong 13.999 người không THA có 737 biến cố, nguy cơ 5,3%. Tỷ số nguy cơ (risk ratio, RR) thô là 2,82 (KTC 95%: 2,57–3,09); tỷ số tỷ suất (rate ratio, IRR) thô là 3,08. Người chết vì nguyên nhân khác trước khi có biến cố vẫn nằm trong mẫu số của nguy cơ, như một người không có biến cố; người-thời gian của họ thì dừng ở lúc chết.
hinh_luu_do() + gia_dinh()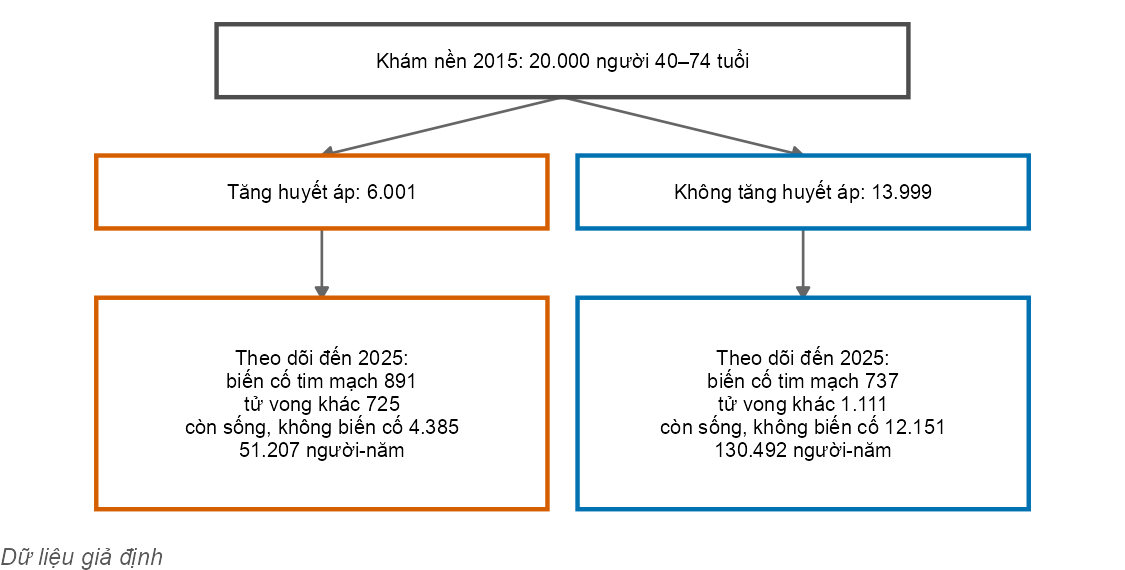
Đoán trước khi đọc tiếp · mức dễ. Trong đoàn hệ, người THA lớn tuổi hơn người không THA, mà tuổi càng cao thì nguy cơ biến cố tim mạch càng lớn. Nếu so sánh THA với không THA trong từng nhóm tuổi rồi mới gộp lại, RR thô 2,82 sẽ thay đổi thế nào?
Người THA lớn tuổi hơn, mà bản thân tuổi đã làm tăng nguy cơ. Vì thế ta hiệu chỉnh theo tuổi: chia đoàn hệ thành 3 nhóm tuổi lúc khám nền (40–54, 55–64 và 65–74 tuổi), so sánh trong từng nhóm rồi gộp lại. Khi ấy RR giảm còn 2,05 (KTC 95%: 1,85–2,26), IRR còn 2,16; Chương 7 sẽ giải thích vì sao. Ba con số hiệu chỉnh ấy, gồm hai con số trên và tỷ số chênh nguy cơ (risk odds ratio) 2,24, sẽ là “đáp án” mà các thiết kế bệnh–chứng ở Mục 4.6 phải tìm lại.
Cái giá của đoàn hệ là quy mô: để có 1.628 biến cố, ta phải khám 20.000 người và theo dõi họ 10 năm. Với bệnh hiếm, hoặc bệnh có thời gian ủ bệnh dài, đoàn hệ trở nên quá tốn kém. Người rời nghiên cứu giữa chừng, tức mất theo dõi (loss to follow-up), cũng là một nguồn sai lệch (xem Chương 9).
Một cái bẫy khi phân loại phơi nhiễm theo thời gian. Giả sử một nghiên cứu muốn biết thuốc hạ mỡ máu có giảm biến cố tim mạch hay không, và có người bắt đầu dùng thuốc ở năm thứ 3 sau khám nền. Nếu xếp người ấy vào nhóm “dùng thuốc” ngay từ khám nền thì 3 năm đầu được tính cho nhóm dùng thuốc. Thế nhưng trong 3 năm ấy, người này không thể có biến cố mà vẫn được xếp vào nhóm dùng thuốc, vì ai có biến cố trước khi kịp bắt đầu dùng thuốc đều bị xếp vào nhóm không dùng. Khoảng thời gian ấy là người-thời gian bất tử (immortal person-time) (Lash và c.s. 2021, ch 7).
Hậu quả là mẫu số của nhóm dùng thuốc phình ra mà tử số không đổi. Thử tính nhẩm: giả sử thuốc không có tác dụng gì, tỷ suất biến cố không đổi theo thời gian, mọi người dùng thuốc đều bắt đầu ở năm thứ 3, và ai cũng được theo dõi 10 năm. Nếu tính sai từ khám nền, nhóm dùng thuốc có thêm 3 năm không có biến cố trên mỗi 10 năm, nên IRR bị kéo xuống khoảng 0,70: một “tác dụng bảo vệ” hoàn toàn giả tạo. Muốn sửa thì phải phân loại người-thời gian theo phơi nhiễm tại từng thời điểm: trước khi bắt đầu dùng thuốc, người ấy đóng góp người-thời gian cho nhóm không dùng (Hình 4.5).
# lint: no-gia-dinh
hinh_bat_tu()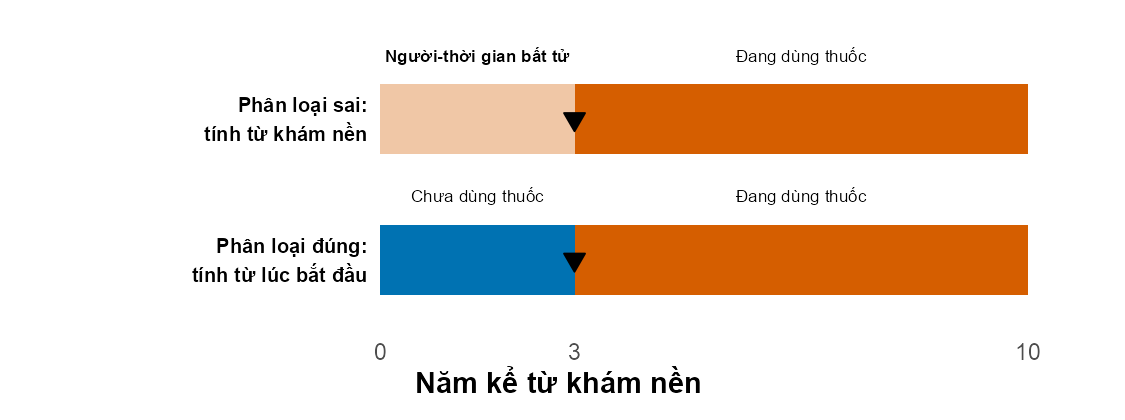
Thử nghiệm ngẫu nhiên có đối chứng (randomized controlled trial, RCT) cũng là một đoàn hệ, chỉ khác ở chỗ ai phơi nhiễm là do nhà nghiên cứu quyết định, bằng một cơ chế ngẫu nhiên. Năm 2023, 12 trạm y tế xã của tỉnh Lục Vân tuyển 600 người THA chưa kiểm soát vào thử nghiệm SMS, tức những người đang được trạm quản lý mà huyết áp vẫn cao. Họ được chia ngẫu nhiên vào hai nhánh, tức hai nhóm của thử nghiệm: nhánh can thiệp nhận tin nhắn nhắc uống thuốc và mỗi tháng một cuộc gọi của nhân viên y tế xã, nhánh chứng nhận chăm sóc thường quy. Kết cục chính là huyết áp tâm thu dưới 140 mmHg sau 12 tháng.
Thử nghiệm SMS kiểm soát huyết áp (thu_nghiem_sms).
Các trạm tuyển người trong 6 tháng. “Chưa kiểm soát” nghĩa là lần đo lúc tuyển cho huyết áp tâm thu từ 145 mmHg trở lên. Kết cục chính dựa trên một lần đo huyết áp ở tháng thứ 12. Dữ liệu giả định coi như ai mất theo dõi là do may rủi, không liên quan đến nhánh hay huyết áp. Mô tả đầy đủ ở Mục C.3.15.
Vì sao phải ngẫu nhiên? Trong nghiên cứu quan sát, người tự chọn can thiệp, hay được bác sĩ chọn cho, thường khác người không được chọn: lo cho sức khỏe hơn, bệnh nhẹ hơn hoặc nặng hơn. Ngẫu nhiên hóa (randomization) cắt đứt mọi liên hệ giữa đặc điểm của người bệnh và nhóm mà họ được phân vào, nhờ đó hai nhánh kỳ vọng giống nhau về mọi yếu tố, đo được cũng như không đo được (Lash và c.s. 2021, ch 6; Celentano và Szklo 2019, tr. 201–205). Chương 6 gọi tính chất này là tính hoán đổi được (exchangeability), và ngẫu nhiên hóa tạo ra nó ngay từ khâu thiết kế.
Thử nghiệm SMS ngẫu nhiên hóa theo khối 4 người, phân tầng theo trạm: cứ mỗi khối 4 người liên tiếp ở một trạm thì đúng 2 người vào mỗi nhánh. Nhờ vậy, hai nhánh giữ được cân bằng về số người ở từng trạm, kể cả khi thử nghiệm dừng sớm.
Đoán trước khi đọc tiếp · mức vừa. Lúc tuyển, tỷ lệ nam giới ở hai nhánh thử nghiệm SMS lệch nhau 7,3 điểm phần trăm. Điều đó nói lên gì?
Bảng 4.2 so sánh hai nhánh lúc tuyển. Dòng cuối là huyết áp “thường ngày” thật của từng người, một cột chỉ dữ liệu giả định mới có, dùng để dạy, vì ngoài đời không ai đo được con số này. Ở cột ấy, hai nhánh vẫn gần như bằng nhau, đúng như ngẫu nhiên hóa hứa hẹn với cả yếu tố không đo được. Còn tỷ lệ nam giới thì lệch nhau 7,3 điểm phần trăm; đó là chênh lệch do may rủi, chứ không phải ngẫu nhiên hóa thất bại.
knitr::kable(bang_can_bang(), align = "lrr")| Đặc điểm lúc tuyển | Can thiệp SMS | Chăm sóc thường quy |
|---|---|---|
| Số người | 300 | 300 |
| Tuổi, trung bình (SD) | 60,2 (10,2) | 59,3 (9,2) |
| Nam giới (%) | 49,0% | 41,7% |
| HA tâm thu đo lúc tuyển, mmHg, trung bình (SD) | 151,1 (5,9) | 150,4 (5,2) |
| HA tâm thu thường ngày thật*, mmHg, trung bình (SD) | 142,1 (7,4) | 141,8 (7,0) |
“Đã ngẫu nhiên hóa thì hai nhóm giống hệt nhau.” Không. Ngẫu nhiên hóa chỉ bảo đảm hai nhóm giống nhau về kỳ vọng, tức tính trung bình qua mọi lần chia có thể có. Trong một lần chia cụ thể, chênh lệch do may rủi vẫn xảy ra, nhất là khi cỡ mẫu nhỏ, như tỷ lệ nam giới ở Bảng 4.2. Vì thế không cần kiểm định giá trị p cho bảng cân bằng: theo định nghĩa, mọi chênh lệch ở đó đều do may rủi. Điều đáng hỏi là chênh lệch ấy có đủ lớn để ảnh hưởng đến kết quả hay không.
Hai biện pháp này hay bị gộp làm một, nhưng mỗi biện pháp bảo vệ một giai đoạn riêng.
Che giấu trình tự phân bổ (allocation concealment) bảo vệ giai đoạn trước và trong lúc phân bổ: người tuyển bệnh nhân không được biết người kế tiếp sẽ vào nhánh nào, cho đến khi người ấy đã chính thức được nhận vào. Biết trước, người tuyển có thể vô tình mời người “hợp” với can thiệp vào đúng lúc, và thế là hai nhánh không còn so sánh được. Danh sách ngẫu nhiên dù hoàn hảo đến đâu cũng mất tác dụng nếu bị ai đó nhìn thấy (Lash và c.s. 2021, ch 35; Celentano và Szklo 2019, tr. 201–203).
Làm mù (blinding) bảo vệ giai đoạn sau phân bổ: người tham gia, người điều trị và người đánh giá kết cục đều không biết ai thuộc nhánh nào, nên chuyện biết nhánh không chi phối được hành vi, cách chăm sóc hay cách đo kết cục. Trong thử nghiệm thuốc, nhánh chứng thường nhận giả dược (placebo) để làm mù (Celentano và Szklo 2019, tr. 207). Thử nghiệm SMS thì không thể làm mù người tham gia, vì ai cũng biết mình có nhận tin nhắn hay không; nhưng vẫn làm mù được người đo huyết áp ở tháng thứ 12.
“Thử nghiệm đã làm mù thì không cần che giấu trình tự phân bổ.” Không. Làm mù bảo vệ khâu đo lường sau khi đã phân bổ, chứ không ngăn được chuyện chọn ai vào thử nghiệm dựa trên nhánh sắp tới. Ngược lại, nhiều thử nghiệm không thể làm mù, như thử nghiệm SMS, nhưng thử nghiệm nào cũng phải che giấu được trình tự phân bổ.
Sau ngẫu nhiên hóa, mọi chuyện không còn ngẫu nhiên nữa. Ở nhánh can thiệp, 223 trong 300 người tuân thủ (adherence) chương trình, tức là có nhận tin nhắn và nghe máy ở phần lớn các cuộc gọi hằng tháng; số còn lại không tuân thủ (noncompliance). Trước tháng thứ 12, có 25 người ở nhánh can thiệp và 21 người ở nhánh chứng mất theo dõi (Hình 4.6).
hinh_consort() + gia_dinh()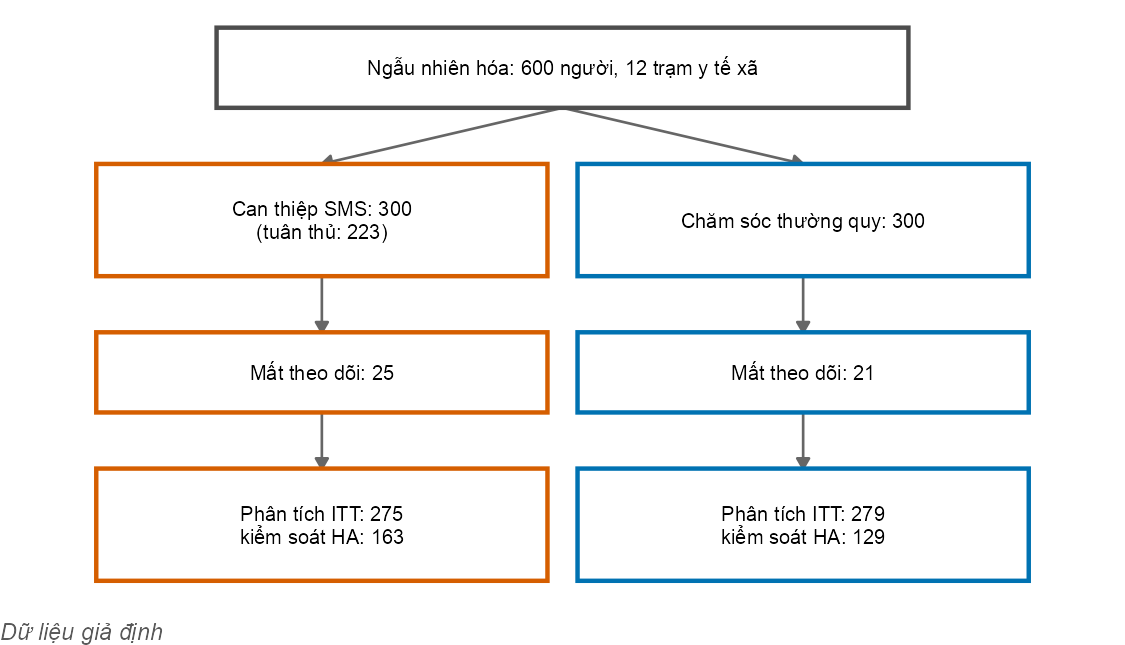
Phân tích theo ý định điều trị (intention-to-treat analysis, ITT) so sánh mọi người theo nhánh mà họ được phân bổ, bất kể họ có thực hiện can thiệp hay không (Celentano và Szklo 2019, tr. 210–211); chỉ cách so sánh này mới giữ nguyên lợi ích của ngẫu nhiên hóa. Trong số người được theo dõi đủ, 59,3% người ở nhánh can thiệp kiểm soát được huyết áp, so với 46,2% ở nhánh chứng. Hiệu nguy cơ (risk difference, RD) là 0,13 (KTC 95%: 0,05–0,21); cứ khoảng 8 người được phân vào chương trình thì có thêm một người kiểm soát được huyết áp (số người cần điều trị, xem Chương 3). Phép tính này chỉ dùng những người có kết quả ở tháng thứ 12; còn người mất theo dõi thì xử lý thế nào là chủ đề của Chương 9.
Đoán trước khi đọc tiếp · mức vừa. Nếu bỏ những người không tuân thủ ở nhánh can thiệp rồi mới so với nhánh chứng, RD tăng từ 0,13 lên 0,18. Con số nào nên là kết quả chính của thử nghiệm?
Phân tích theo đề cương (per-protocol analysis) chỉ giữ những người làm đúng đề cương, ở đây là người tuân thủ trong nhánh can thiệp. Trong nhóm này, tỷ lệ kiểm soát là 63,8%, cho RD 0,18, lớn hơn ITT. Nhưng con số đẹp hơn không có nghĩa là đúng hơn: người tuân thủ thường khác người không tuân thủ theo nhiều cách liên quan đến huyết áp, nên bỏ người không tuân thủ đi cũng là bỏ luôn ngẫu nhiên hóa. Vì sao phân tích này dễ sai lệch, Chương 9 sẽ giải thích.
Ngoài thiết kế hai nhánh song song, còn ba biến thể thường gặp (Celentano và Szklo 2019, tr. 208–211). Trong thiết kế bắt chéo (crossover design), mỗi người lần lượt nhận cả hai can thiệp theo thứ tự ngẫu nhiên, giữa hai lần cách nhau một giai đoạn thải trừ; mỗi người là chứng của chính mình, nhưng thiết kế chỉ hợp với bệnh ổn định và với tác dụng không kéo dài. Thiết kế giai thừa (factorial design) phân bổ ngẫu nhiên vào cả bốn tổ hợp để đánh giá hai can thiệp cùng lúc, nên một thử nghiệm trả lời được hai câu hỏi. Sau cùng, có khi phải phân bổ ngẫu nhiên cả một nhóm, chẳng hạn cả một trạm y tế xã, vì can thiệp áp cho cả cộng đồng; khi ấy người cùng nhóm giống nhau hơn người khác nhóm, và phân tích phải tính đến điều đó.
Quay lại câu hỏi mở đầu. Đoàn hệ tốn kém vì phải biết phơi nhiễm và người-thời gian của mọi người. Nhưng hãy nhìn kỹ một tỷ số tỷ suất: tử số cần số ca bệnh ở hai nhóm, còn mẫu số chỉ cần tỷ lệ giữa người-thời gian của nhóm phơi nhiễm và nhóm không phơi nhiễm, chứ không cần độ lớn tuyệt đối. Mà tỷ lệ ấy thì ước lượng được từ một mẫu.
Nghiên cứu bệnh–chứng (case-control study) chỉ gói gọn trong ý ấy: lấy mọi ca bệnh phát sinh trong nền nghiên cứu, rồi chọn một mẫu của chính nền nghiên cứu đó; mẫu này là nhóm chứng (controls). Nhiệm vụ duy nhất của nhóm chứng là ước lượng phân bố phơi nhiễm trong mẫu số của quần thể nguồn (Lash và c.s. 2021, ch 8). Nhóm chứng không phải “người khỏe mạnh”, cũng không cần giống ca bệnh về mọi mặt; họ chỉ cần được chọn từ cùng nền nghiên cứu, và được chọn độc lập với phơi nhiễm.
Giả sử ta chọn nhóm chứng sao cho mỗi người-năm của nền nghiên cứu đều có cùng xác suất \(f\) được đại diện. Khi đó số chứng THA xấp xỉ \(f\) nhân số người-năm THA, số chứng không THA xấp xỉ \(f\) nhân số người-năm không THA, và tỷ số chênh (odds ratio, OR) của bảng bệnh–chứng trở thành:
\[ \text{OR} = \frac{a/c}{b/d} = \frac{a/c}{f\,T_1/(f\,T_0)} = \frac{a/T_1}{c/T_0} = \frac{I_1}{I_0} = \text{IRR} \tag{4.1}\]
Các ký hiệu trong công thức 4.1:
| Ký hiệu | Đọc là | Ý nghĩa |
|---|---|---|
| \(a\), \(c\) | “a”, “c” | Số ca bệnh có phơi nhiễm, không phơi nhiễm (mọi ca của nền nghiên cứu) |
| \(b\), \(d\) | “b”, “d” | Số chứng có phơi nhiễm, không phơi nhiễm |
| \(f\) | “ép” | Phân số lấy mẫu: tỷ lệ người-thời gian của nền được chọn làm chứng; giống nhau ở hai nhóm phơi nhiễm |
| \(T_1\), \(T_0\) | “tê một”, “tê không” | Người-thời gian có nguy cơ của nhóm phơi nhiễm, không phơi nhiễm trong nền nghiên cứu |
| \(I_1\), \(I_0\) | “i một”, “i không” | Tỷ suất mới mắc ở nhóm phơi nhiễm, không phơi nhiễm |
| \(\text{OR}\), \(\text{IRR}\) | “ô R”, “i R R” | Tỷ số chênh của bảng bệnh–chứng; tỷ số tỷ suất |
Phân số \(f\) có mặt ở cả tử lẫn mẫu của tỷ số \(b/d\) nên triệt tiêu. Ta không cần biết \(f\), cũng không cần biết \(T_1\) và \(T_0\), mà chỉ cần nhóm chứng phản ánh đúng tỷ lệ \(T_1/T_0\). Modern Epidemiology gọi \(b\) và \(d\) là giả tần số (pseudofrequencies): chúng không phải mẫu số thật, nhưng tỷ số giữa chúng bằng tỷ số giữa các mẫu số thật (Lash và c.s. 2021, ch 8). Với đoàn hệ Bạch Hải và \(f = 0{,}1\), nhóm chứng chỉ cần khoảng 18.170 người, mỗi người đại diện cho 10 người-năm của nền, thay vì phải theo dõi đủ 181.699 người-năm.
Nhóm chứng đại diện cho mẫu số khác thì OR sẽ ước lượng đại lượng khác. Bảng 4.3 tính thử điều đó trên toàn đoàn hệ, chưa hiệu chỉnh theo tuổi: vẫn chừng ấy 891 và 737 ca bệnh, nhưng đặt lên ba mẫu số khác nhau thì cho ba con số khác nhau.
bang <- bind_rows(
  tibble(`Nhóm` = "Ca bệnh (biến cố tim mạch)", `THA` = so(A1, 0), `Không THA` = so(A0, 0),
         `Odds phơi nhiễm` = so(A1 / A0, 3), `OR` = "", `OR này chính là` = ""),
  tibble(`Nhóm` = gia_tan_so$mau_so, `THA` = so(gia_tan_so$tha, 0), `Không THA` = so(gia_tan_so$khong, 0),
         `Odds phơi nhiễm` = so(gia_tan_so$odds, 3), `OR` = so(gia_tan_so$or, 2),
         `OR này chính là` = gia_tan_so$dai_luong))
knitr::kable(bang, align = "lrrrrl")| Nhóm | THA | Không THA | Odds phơi nhiễm | OR | OR này chính là |
|---|---|---|---|---|---|
| Ca bệnh (biến cố tim mạch) | 891 | 737 | 1,209 | ||
| Người-năm có nguy cơ (T) | 51.207 | 130.492 | 0,392 | 3,08 | Tỷ số tỷ suất thô (IRR) |
| Người lúc khám nền (N) | 6.001 | 13.999 | 0,429 | 2,82 | Tỷ số nguy cơ thô (RR) |
| Người không có biến cố (N − A) | 5.110 | 13.262 | 0,385 | 3,14 | Tỷ số chênh nguy cơ thô |
Đoán trước khi đọc tiếp · mức vừa. Một phơi nhiễm không làm tăng số người mắc bệnh, nhưng khiến người đã mắc tử vong sớm hơn. Nếu nhóm ca bệnh là những người đang sống với bệnh vào lúc nghiên cứu, phơi nhiễm ấy sẽ trông ra sao?
Ca bệnh phải là mọi ca phát sinh trong nền nghiên cứu, hoặc một mẫu đại diện của mọi ca ấy, theo một định nghĩa ca bệnh (case definition) rõ ràng và áp dụng như nhau cho mọi người (Lash và c.s. 2021, ch 8; Celentano và Szklo 2019, tr. 157–160). Nên dùng ca mới mắc thay vì ca hiện mắc, vì ca hiện mắc là những người đã mắc và còn sống với bệnh: phơi nhiễm nào làm người bệnh chết sớm sẽ ít xuất hiện trong nhóm này, và nghiên cứu sẽ nhầm “yếu tố gây tử vong” thành “yếu tố bảo vệ”.
Khó hơn là câu hỏi ca bệnh đến từ nền nghiên cứu nào. Với đoàn hệ Bạch Hải thì câu trả lời đã rõ: các ca là mọi biến cố trong 20.000 người được theo dõi. Nghiên cứu lấy ca từ một bệnh viện thì khó hơn, vì quần thể nguồn khi ấy là những người sẽ đến bệnh viện đó nếu mắc bệnh, một quần thể khó xác định. Và nhóm chứng phải đến từ chính quần thể ấy.
Với dữ liệu giả định, ta làm được một phép thử mà nghiên cứu thật không làm được. Bộ bc_tich_luy gồm cả 1.628 ca bệnh của đoàn hệ và 4 chứng cho mỗi ca, tổng cộng 8.140 hồ sơ. Nhà nghiên cứu chỉ có chừng ấy hồ sơ, bằng 41% số người của đoàn hệ, liệu có tìm lại được câu trả lời của đoàn hệ không? Mục tiếp theo sẽ trả lời.
Bệnh–chứng, chứng tích lũy (bc_tich_luy).
Chứng của bc_tich_luy được rút ngẫu nhiên từ những người còn sống và chưa có biến cố khi hết 10 năm, nên người đã chết vì nguyên nhân khác không có mặt trong nhóm chứng. Ca bệnh được phỏng vấn sau khi có biến cố, chứng được phỏng vấn khi hết 10 năm. THA của mỗi người vẫn lấy từ hồ sơ khám nền, như trong đoàn hệ. Ba mẫu còn lại của chương (bc_mat_do, ca_benh_doan_he và bc_benh_vien) cũng rút từ chính đoàn hệ này và dùng chung các ca bệnh. Mô tả đầy đủ ở Mục C.3.11.
Cách cổ điển nhất là đợi đến cuối thời gian nghiên cứu, rồi chọn chứng từ những người chưa có biến cố; đó là chọn chứng tích lũy (cumulative sampling). Khi ấy nhóm chứng đại diện cho mẫu số “người không có biến cố”, nên OR ước lượng tỷ số chênh nguy cơ: odds có biến cố ở nhóm phơi nhiễm chia cho odds ở nhóm không phơi nhiễm (Lash và c.s. 2021, ch 8; Szklo và Nieto 2014, tr. 98).
Tỷ số chênh nguy cơ chỉ gần RR khi biến cố hiếm, vì lý do đã gặp ở Chương 3: nguy cơ nhỏ thì số người không bệnh gần bằng tổng số người, nên odds gần bằng nguy cơ. Trong đoàn hệ Bạch Hải, 8,1% người có biến cố trong 10 năm theo dõi, không quá hiếm; tỷ số chênh nguy cơ hiệu chỉnh theo tuổi của toàn đoàn hệ là 2,24, lớn hơn RR 2,05. Còn với bc_tich_luy, OR hiệu chỉnh theo tuổi là 2,25 (KTC 95%: 1,99–2,54), rất gần tỷ số chênh nguy cơ của đoàn hệ, đúng như lý thuyết dự đoán.
Cách thứ hai bám sát người-thời gian: mỗi khi một ca bệnh xuất hiện, ta chọn chứng từ những người còn đang có nguy cơ ngay tại thời điểm ấy. Những người này hợp thành tập nguy cơ (risk set) của ca, và lấy mẫu như vậy gọi là chọn chứng theo mật độ (density sampling). Người được theo dõi càng lâu thì càng nằm trong nhiều tập nguy cơ, nên xác suất được chọn tỷ lệ với người-thời gian của họ. Vì thế nhóm chứng đại diện cho mẫu số người-thời gian, và theo công thức 4.1, OR ước lượng IRR mà không cần bất kỳ giả định bệnh hiếm nào (Lash và c.s. 2021, ch 8; Szklo và Nieto 2014, tr. 98–99).
Có một hệ quả làm nhiều người ngạc nhiên: người được chọn làm chứng vào năm thứ hai vẫn có thể có biến cố vào năm thứ bảy và trở thành ca. Đó không phải lỗi. Vào năm thứ hai, người ấy đang có nguy cơ, đúng như mọi người trong mẫu số của tỷ suất, nên được giữ trong nghiên cứu ở cả hai vai. Trong bc_mat_do, 475 lượt chứng là người về sau trở thành ca, và 1.469 lượt chứng là người đã được chọn làm chứng cho một ca khác. Bộ dữ liệu này cũng ghép chứng với ca theo nhóm tuổi và giới; phân tích theo từng bộ ghép thì OR là 2,19 (KTC 95%: 1,95–2,47), so với IRR hiệu chỉnh theo tuổi 2,16 của đoàn hệ.
Đoán trước khi đọc tiếp · mức vừa. Giả sử ngay lúc khám nền, ta rút ngẫu nhiên một mẫu từ mọi người trong đoàn hệ, chưa biết ai sẽ có biến cố, rồi đem các ca bệnh so với mẫu ấy. OR khi đó ước lượng đại lượng nào?
Cách thứ ba chọn chứng ngay từ lúc bắt đầu: rút một mẫu ngẫu nhiên của toàn bộ đoàn hệ lúc khám nền, không cần biết ai sẽ có biến cố, và gọi mẫu này là đoàn hệ con (subcohort). Ca bệnh là mọi biến cố trong cả đoàn hệ. Đó là nghiên cứu bệnh–đoàn hệ (case-cohort study). Đoàn hệ con đại diện cho mẫu số “mọi người lúc bắt đầu”, nên OR giữa ca bệnh và đoàn hệ con ước lượng RR, cũng không cần giả định bệnh hiếm (Lash và c.s. 2021, ch 8; Szklo và Nieto 2014, tr. 96–97).
Đoàn hệ con trong ca_benh_doan_he có 2.000 người, tức 10% đoàn hệ. Trong số đó, 159 người về sau có biến cố nên có mặt ở cả nhóm ca lẫn nhóm so sánh, và điều đó hoàn toàn hợp lệ. OR hiệu chỉnh theo tuổi là 1,98 (KTC 95%: 1,70–2,29), so với RR 2,05 của đoàn hệ. Ưu điểm thực tế lớn nhất của thiết kế là một đoàn hệ con dùng được cho nhiều kết cục: chính 2.000 người ấy có thể đem so với các ca đột quỵ, ca sa sút trí tuệ hay ca ung thư, vì đoàn hệ con được chọn độc lập với mọi kết cục.
Nghiên cứu bệnh–chứng làm ngay bên trong một đoàn hệ đã có danh sách đầy đủ thì gọi là nghiên cứu bệnh–chứng lồng ghép (nested case-control study), và thường dùng cách chọn chứng theo mật độ, như bc_mat_do (Celentano và Szklo 2019, tr. 187–189; Lash và c.s. 2021, ch 8). Lợi ích nằm ở chi phí đo phơi nhiễm. Giả sử đoàn hệ Bạch Hải có lưu mẫu máu lúc khám nền, và ta muốn đo một dấu ấn sinh học đắt tiền: đo cho 20.000 người thì quá tốn, còn đo cho 1.628 ca và 6.512 chứng thì khả thi mà vẫn trả lời được câu hỏi.
Bảng 4.4 đặt ba thiết kế cạnh nhau: cả ba dùng chung các ca bệnh, chỉ khác nhau ở chỗ chọn chứng.
bang <- dich_bang |>
  transmute(`Cách chọn chứng` = thiet_ke, `Bộ dữ liệu` = paste0("`", bo_du_lieu, "`"),
            `Số chứng` = so(so_chung, 0), `Đại lượng ước lượng` = dai_luong,
            `Đích (toàn đoàn hệ)` = so(dich, 2), `Ước lượng (KTC 95%)` = ktc(uoc, lo, hi),
            `Trung vị lấy mẫu lại` = so(trung_vi[thiet_ke], 2))
knitr::kable(bang, align = "llrlrrr")| Cách chọn chứng | Bộ dữ liệu | Số chứng | Đại lượng ước lượng | Đích (toàn đoàn hệ) | Ước lượng (KTC 95%) | Trung vị lấy mẫu lại |
|---|---|---|---|---|---|---|
| Chọn chứng tích lũy | bc_tich_luy |
6.512 | Tỷ số chênh nguy cơ | 2,24 | 2,25 (KTC 95%: 1,99–2,54) | 2,24 |
| Chọn chứng theo mật độ | bc_mat_do |
6.512 | Tỷ số tỷ suất (IRR) | 2,16 | 2,19 (KTC 95%: 1,95–2,47) | 2,18 |
| Bệnh–đoàn hệ | ca_benh_doan_he |
2.000 | Tỷ số nguy cơ (RR) | 2,05 | 1,98 (KTC 95%: 1,70–2,29) | 2,02 |
Ba giá trị đích rất gần nhau: 2,05, 2,16 và 2,24; đích lớn nhất chỉ hơn đích nhỏ nhất 9%. Khoảng tin cậy của mỗi ước lượng lại rộng hơn khoảng cách ấy, nên chỉ một mẫu thì không đủ để phân biệt chúng. Muốn thấy mỗi thiết kế nhắm vào đâu, ta làm một việc mà chỉ dữ liệu giả định mới cho phép: lấy mẫu lại 1.000 lần từ đoàn hệ theo cả ba cách, mỗi lần dùng mọi ca bệnh và một nhóm chứng mới (Hình 4.7). Phân bố nào cũng nằm quanh đích của chính nó: chọn chứng tích lũy quanh tỷ số chênh nguy cơ, chọn chứng theo mật độ quanh IRR, bệnh–đoàn hệ quanh RR.
hinh_mau_lap(lap) + gia_dinh()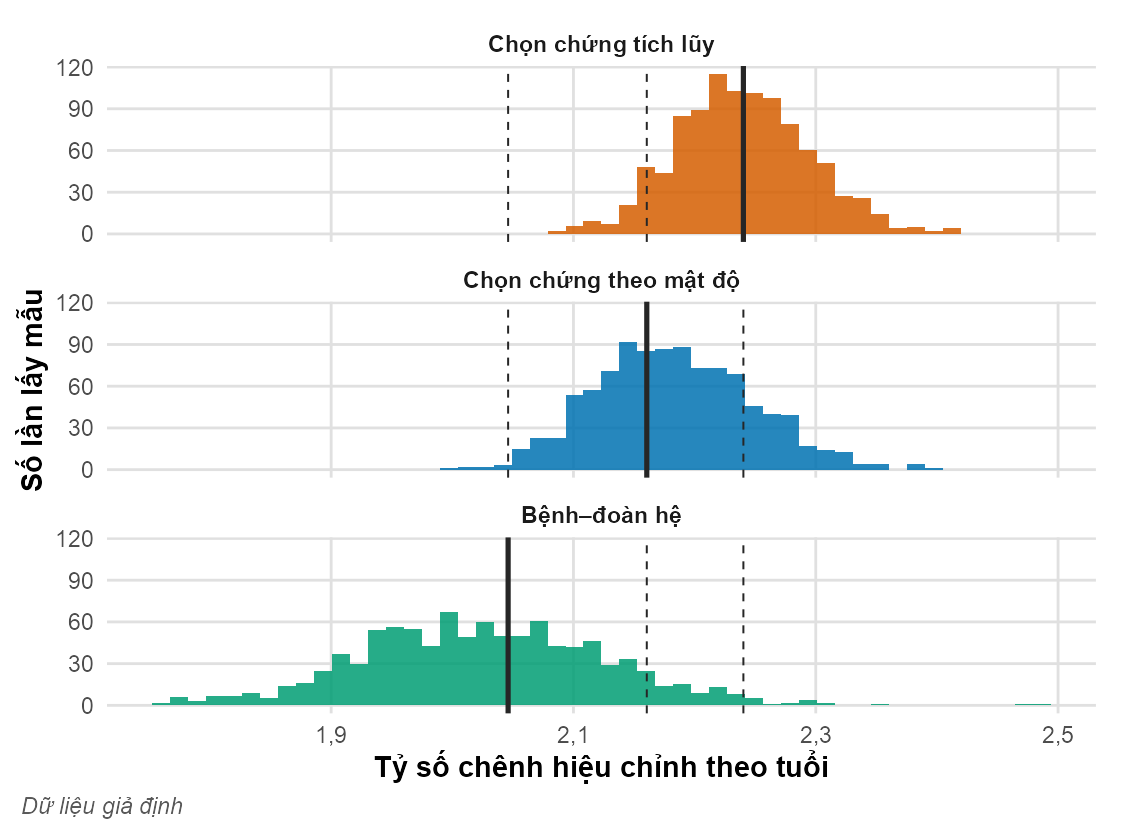
Phân bố của bệnh–đoàn hệ rộng hơn hai phân bố kia vì đoàn hệ con chỉ có 2.000 người, so với 6.512 chứng ở hai thiết kế còn lại. Đó là cái giá phải trả cho một nhóm so sánh dùng được cho nhiều kết cục.
Giả định bệnh hiếm trong nghiên cứu bệnh–chứng. Gordis Epidemiology nêu ba điều kiện để OR của một nghiên cứu bệnh–chứng xấp xỉ tốt RR: ca bệnh đại diện cho mọi ca, nhóm chứng đại diện cho những người không mắc bệnh trong quần thể nguồn, và bệnh không phổ biến (Celentano và Szklo 2019, tr. 248–249). Modern Epidemiology thì xuất phát từ cách chọn chứng: chọn theo mật độ thì OR ước lượng tỷ số tỷ suất, chọn theo kiểu bệnh–đoàn hệ thì OR ước lượng tỷ số nguy cơ, chọn tích lũy thì OR ước lượng tỷ số chênh nguy cơ; điều kiện bệnh hiếm chỉ cần cho cách cuối, khi ta muốn đọc OR như RR (Lash và c.s. 2021, ch 8). Szklo và Nieto cũng chỉ ra rằng không cần giả định này khi nhóm chứng là mẫu của toàn bộ quần thể, và chọn theo tập nguy cơ thì cho tỷ số tỷ suất (Szklo và Nieto 2014, tr. 96–99).
Khác biệt này dẫn người đọc đến những kết luận khác nhau: theo cách trình bày thứ nhất, mọi OR của bệnh phổ biến đều đáng ngờ; theo cách thứ hai, OR của một nghiên cứu chọn chứng theo mật độ không cần bệnh hiếm. Điều kiện thứ hai của Gordis (nhóm chứng là người không mắc bệnh) thực chất mô tả cách chọn chứng tích lũy, nên ở đúng trường hợp đó, hai cách trình bày không mâu thuẫn. Chương này theo Modern Epidemiology, cuốn sách dẫn đầu về lý thuyết thiết kế nghiên cứu, và Bảng 4.4 kiểm chứng điều đó trên dữ liệu.
Ghép cặp (matching) là chọn nhóm chứng sao cho phân bố của một vài yếu tố, thường là tuổi và giới, giống với nhóm ca bệnh. Có hai cách ghép (Celentano và Szklo 2019, tr. 167–169). Ghép theo nhóm (frequency matching) chỉ cần tỷ lệ từng nhóm tuổi trong nhóm chứng giống nhóm ca, còn ghép cặp cá thể (individual matching) chọn cho mỗi ca một hoặc vài chứng có cùng giá trị của yếu tố ghép. bc_mat_do ghép cá thể: mỗi bộ ghép gồm một ca và 4 chứng cùng nhóm tuổi, cùng giới, được chọn đúng lúc ca xuất hiện.
Đoán trước khi đọc tiếp · mức khó. Ca và chứng trong bc_mat_do đã cùng nhóm tuổi, cùng giới. Khi phân tích, có thể bỏ qua các bộ ghép mà tính OR thô từ toàn bộ bảng không?
Trong nghiên cứu bệnh–chứng, ghép cặp không tự loại bỏ nhiễu (confounding), mà ngược lại, cố ý làm cho nhóm chứng giống ca bệnh về yếu tố ghép. Yếu tố ghép mà liên quan đến phơi nhiễm, như tuổi liên quan đến THA, thì phân bố phơi nhiễm của nhóm chứng sẽ giống ca bệnh hơn so với quần thể nguồn. Modern Epidemiology gọi đây là sai lệch chọn lựa (selection bias) do chính ta cố ý tạo ra, chỉ gỡ bỏ được khi phân tích có tính đến yếu tố ghép (Lash và c.s. 2021, ch 6 và 8).
Dữ liệu cho thấy rất rõ điều đó: phân tích bc_mat_do theo bộ ghép cho OR 2,19 (KTC 95%: 1,95–2,47), phân tầng theo tuổi và giới cho 2,21. Còn nếu bỏ qua ghép cặp mà tính OR thô từ toàn bộ bảng, kết quả chỉ còn 2,01 (KTC 95%: 1,80–2,24), bị kéo về phía 1. Kỹ thuật phân tích phân tầng xin dành cho Chương 7; ở đây chỉ cần nhớ rằng thiết kế có ghép cặp đòi hỏi phân tích có tính đến yếu tố ghép.
Ghép cặp còn có hai cái giá nữa. Thứ nhất, ta không thể nghiên cứu tác động của chính yếu tố đã ghép: trong bc_mat_do, ca và chứng có cùng phân bố tuổi là do thiết kế. Thứ hai, ghép theo một yếu tố không phải yếu tố gây nhiễu là ghép cặp quá mức (overmatching). Yếu tố ấy mà chỉ liên quan đến phơi nhiễm thì ghép cặp làm giảm hiệu quả thống kê mà chẳng được gì; còn nếu yếu tố ấy nằm trên đường từ phơi nhiễm đến bệnh thì ghép cặp gây sai lệch mà phân tích không sửa được (Lash và c.s. 2021, ch 6).
Khi tìm ca bệnh ở bệnh viện, cách dễ nhất là lấy chứng từ những bệnh nhân nằm viện vì bệnh khác. Nhóm chứng bệnh viện (hospital controls) dễ tiếp cận, hợp tác tốt, và nhớ lại tiền sử theo cách giống ca bệnh. Nhóm chứng cộng đồng (population controls) thì lấy từ dân cư chung của quần thể nguồn, khó tuyển hơn nhưng đại diện tốt hơn (Celentano và Szklo 2019, tr. 161–163; Lash và c.s. 2021, ch 8).
Cái khó của nhóm chứng bệnh viện nằm ở lý do nhập viện: nhiều bệnh khiến người ta nhập viện, như bệnh thận, ĐTĐ hay bệnh mắt, cũng liên quan đến THA. Bộ bc_benh_vien mô phỏng đúng tình huống ấy. Ca bệnh vẫn là 1.628 ca của đoàn hệ, còn nhóm chứng là 6.455 người đang nằm Bệnh viện Đa khoa tỉnh Bạch Hải vì một bệnh khác. Tỷ lệ THA trong nhóm chứng này là 37,1%, so với 26,4% trong nhóm chứng cộng đồng của bc_tich_luy (Hình 4.8).
Bệnh–chứng, chứng bệnh viện (bc_benh_vien).
Chứng của bc_benh_vien cũng là người trong đoàn hệ: còn sống, chưa có biến cố khi hết 10 năm, và đang nằm viện vào lúc ấy vì một bệnh khác. Họ được phỏng vấn ngay lúc nằm viện, còn ca bệnh được phỏng vấn sau khi có biến cố. Mô tả đầy đủ ở Mục C.3.14.
hinh_benh_vien() + gia_dinh()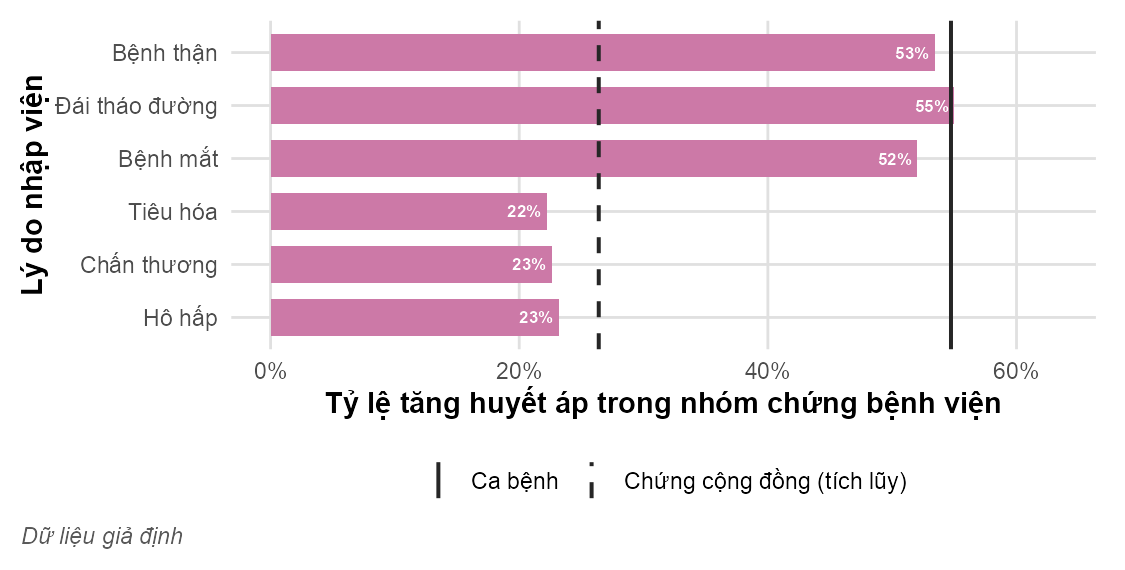
Nhóm chứng bệnh viện có nhiều người THA hơn quần thể nguồn, nên odds phơi nhiễm ở nhóm chứng bị thổi phồng và OR bị kéo về phía 1: OR hiệu chỉnh theo tuổi chỉ còn 1,38 (KTC 95%: 1,22–1,55), so với 2,25 khi dùng chứng cộng đồng. Đây là một dạng sai lệch chọn lựa; Chương 9 sẽ phân tích cơ chế này và cách sửa.
Khi ca bệnh tự làm chứng cho chính mình. Với phơi nhiễm ngắn hạn và kết cục cấp tính, như gắng sức nặng và nhồi máu cơ tim, có một thiết kế chỉ cần đến ca bệnh: với mỗi ca, ta đem phơi nhiễm trong khoảng ngay trước biến cố so với phơi nhiễm của chính người ấy ở những khoảng trước nữa, khi không có biến cố. Tiếng Anh gọi thiết kế này là case-crossover (Celentano và Szklo 2019, tr. 172; Lash và c.s. 2021, ch 8). Mỗi người so với chính mình nên mọi đặc điểm ổn định như gen, giới hay thói quen lâu năm đều tự động được kiểm soát. Thiết kế chỉ hợp khi phơi nhiễm thay đổi theo thời gian và tác động của nó đến nhanh, mất nhanh; với một phơi nhiễm bền vững như THA thì không dùng được.
Thiết kế quyết định ta có thể ước lượng đại lượng nào, chứ không bảo đảm ước lượng ấy đúng. Thiết kế nào trong chương này cũng có thể sai theo bốn cách, mà phần còn lại của sách sẽ lần lượt bàn đến.
Đoán trước khi đọc tiếp · mức dễ. Bệnh–đoàn hệ cho OR hiệu chỉnh theo tuổi 1,98, trong khi đích của thiết kế ấy là RR 2,05. Khoảng cách này chủ yếu do đâu?
Ngẫu nhiên hóa loại bỏ nhiễu lúc phân bổ (về kỳ vọng), nhưng không giúp tránh được mất theo dõi, không tuân thủ hay đo lường sai. Và thiết kế nào, kể cả thử nghiệm tốt nhất, cũng chỉ trả lời câu hỏi cho quần thể nguồn của chính nó.
“Đoàn hệ hồi cứu là đoàn hệ hỏi ngược về quá khứ, giống bệnh–chứng.” Không. Đoàn hệ hồi cứu vẫn đi từ phơi nhiễm đã ghi nhận trong hồ sơ cũ tới kết cục, theo đúng trình tự thời gian; chỉ khác là nhà nghiên cứu đến muộn. Còn nghiên cứu bệnh–chứng thì bắt đầu từ kết cục.
“Nhóm chứng phải là người khỏe mạnh.” Không. Nhóm chứng đại diện cho phân bố phơi nhiễm trong mẫu số của quần thể nguồn, nên họ có thể mắc bệnh khác, miễn là bệnh đó không liên quan đến phơi nhiễm; chọn theo mật độ thì họ còn có thể về sau trở thành ca, như 475 lượt chứng trong bc_mat_do.
“OR trong nghiên cứu bệnh–chứng chỉ đúng khi bệnh hiếm.” Chỉ đúng với chọn chứng tích lũy, và chỉ khi muốn đọc OR như RR. Chọn chứng theo mật độ cho IRR, bệnh–đoàn hệ cho RR, cả hai đều không cần bệnh hiếm (Bảng 4.4).
“Đã ghép cặp thì đã kiểm soát nhiễu, phân tích thô là được.” Không. Ghép cặp trong nghiên cứu bệnh–chứng tạo ra một sai lệch chọn lựa có chủ đích, chỉ gỡ bỏ được khi phân tích có tính đến yếu tố ghép. Bỏ qua ghép cặp thì OR của bc_mat_do giảm từ 2,19 xuống 2,01.
“Thiết kế bệnh–đoàn hệ là bệnh–chứng với chứng là người không bệnh.” Không. Đoàn hệ con là mẫu ngẫu nhiên của mọi người lúc bắt đầu, kể cả những người về sau thành ca; chính vì thế OR ước lượng RR.
“Nghiên cứu sinh thái luôn vô dụng.” Không. Đó là thiết kế đúng cho câu hỏi cấp nhóm và phơi nhiễm cấp cộng đồng, và chỉ sai khi bị dùng để kết luận về từng cá nhân.
Phơi nhiễm (lượng muối) được ghi nhận trước, kết cục (tử vong do đột quỵ) được đếm sau, trên từng người: đó là cấu trúc đoàn hệ. Nhà nghiên cứu lại bắt đầu sau khi mọi kết cục đã xảy ra, nên đây là đoàn hệ hồi cứu.
Đây là chọn chứng tích lũy: nhóm chứng đại diện cho những người không có biến cố, nên OR ước lượng tỷ số chênh nguy cơ; con số này chỉ gần tỷ số nguy cơ khi đột quỵ hiếm trong thời gian theo dõi.
Sai. Năm 2018, người ấy đang có nguy cơ, nên thuộc tập nguy cơ và là chứng hợp lệ; đến năm 2021 thì người ấy trở thành ca. Phải giữ họ ở cả hai vai thì nhóm chứng mới đại diện đúng cho người-thời gian của nền nghiên cứu.
ca_benh_doan_he, nhóm ca có 891 người THA và 737 người không THA; đoàn hệ con có 603 người THA và 1.397 người không THA. Tính OR thô (hai chữ số thập phân). \(\text{OR} = (a/c)/(b/d)\) = (891/737) / (603/1.397) ≈ 2,80. Đoàn hệ con là mẫu của mọi người lúc khám nền, nên con số này ước lượng RR thô của đoàn hệ, 2,82; vì chưa hiệu chỉnh theo tuổi, nó vẫn còn bị nhiễu.
Với khối 4 người, đã biết ba vị trí đầu thì chắc chắn đoán được vị trí cuối. Trình tự phân bổ không còn được che giấu, nên người tuyển có thể chọn ai được mời vào lúc ấy. Vì thế nhiều thử nghiệm dùng kích thước khối thay đổi ngẫu nhiên, và giữ kín kích thước ấy.
Được phép kết luận rằng ở cấp huyện, độ phủ nước máy đi kèm tỷ lệ tiêu chảy thấp hơn, và mối liên quan này đáng đem ra kiểm định. Không được kết luận rằng trẻ trong hộ dùng nước máy ít tiêu chảy hơn trẻ trong hộ không dùng: đó là ngụy biện sinh thái, vì huyện nhiều nước máy có thể khác cả về thu nhập, đô thị hóa hay y tế, giống như mức đô thị hóa trong ví dụ điện thoại thông minh.
Ghép cặp ép phân bố tuổi của nhóm chứng giống nhóm ca, nên so sánh tuổi giữa hai nhóm không còn mang thông tin về tác động của tuổi. Ghép cặp đem khả năng nghiên cứu yếu tố ghép đổi lấy hiệu quả kiểm soát yếu tố ấy.
Bệnh thận và THA đi cùng nhau, nên nhóm chứng có nhiều người THA hơn quần thể nguồn; odds phơi nhiễm ở nhóm chứng bị thổi phồng, và OR bị kéo về phía 1. Trong bc_benh_vien, nhóm chứng nhập viện vì bệnh thận có 53% người THA, so với 26% ở nhóm chứng cộng đồng.
Phần này hướng dẫn làm lại các phép tính của chương bằng R, với vài dòng mã bạn có thể chép về dùng. Hàm two_by_two(), mh_or() và mh_rr() nằm trong tệp R/epi.R của kho mã; dữ liệu, kết quả và hình của chương nằm trong R/ch04.R. Các tệp dữ liệu tải trực tiếp được, ví dụ https://youcan-e64.pages.dev/nckh/data/bc_tich_luy.csv.
Đọc bc_tich_luy, đếm bốn ô của bảng 2×2 trong từng nhóm tuổi, rồi tính OR thô và OR Mantel–Haenszel. Hãy kiểm tra để chắc bảng có 8.140 dòng. R in số thập phân bằng dấu chấm.
tl <- read_csv(dth_path("data/bc_tich_luy.csv"), show_col_types = FALSE)
nrow(tl)
[1] 8140dem <- function(d, dk) as.numeric(tapply(dk, d$nhom_tuoi, sum)) # đếm theo nhóm tuổi
a <- dem(tl, tl$ca_benh == 1 & tl$tha == 1); b <- dem(tl, tl$ca_benh == 0 & tl$tha == 1)
c <- dem(tl, tl$ca_benh == 1 & tl$tha == 0); d <- dem(tl, tl$ca_benh == 0 & tl$tha == 0)
two_by_two(sum(a), sum(b), sum(c), sum(d))[3, ] # OR thô measure estimate lower upper se
3 OR 3.370868 3.013492 3.770626 0.05718005mh_or(a, b, c, d)$estimate # OR hiệu chỉnh theo tuổi[1] 2.250941OR thô là 3,37; hiệu chỉnh theo tuổi thì còn 2,25, gần tỷ số chênh nguy cơ 2,24 của toàn đoàn hệ. Phần chênh giữa OR thô và OR hiệu chỉnh chính là nhiễu do tuổi.
Hàm nhỏ dưới đây tính OR hiệu chỉnh theo tuổi giữa một nhóm ca và một nhóm so sánh. Ta áp hàm này cho đoàn hệ con có sẵn trong ca_benh_doan_he, rồi tự rút từ đoàn hệ đầy đủ nhiều đoàn hệ con mới, mỗi đoàn hệ con 2.000 người. Lấy mẫu ngẫu nhiên thì cần một hạt giống để kết quả lặp lại được.
or_tuoi <- function(ca, so_sanh) {
  x <- c(rep(1, nrow(ca)), rep(0, nrow(so_sanh)))
  g <- rbind(ca[, c("tha", "nhom_tuoi")], so_sanh[, c("tha", "nhom_tuoi")])
  dk <- function(y, e) as.numeric(tapply(x == y & g$tha == e, g$nhom_tuoi, sum))
  mh_or(dk(1, 1), dk(0, 1), dk(1, 0), dk(0, 0))$estimate
}
cc <- read_csv(dth_path("data/ca_benh_doan_he.csv"), show_col_types = FALSE)
or_tuoi(filter(cc, ca_benh == 1), filter(cc, trong_doan_he_con == 1))
[1] 1.975783dh <- read_csv(dth_path("data/doan_he_tim_mach.csv"), show_col_types = FALSE)
ca_dh <- filter(dh, bien_co_tm == 1)
set.seed(2025) # hạt giống: để kết quả lặp lại được
lap_dhc <- replicate(200, or_tuoi(ca_dh, dh[sample(nrow(dh), 2000), ])) # 200 đoàn hệ con
quantile(lap_dhc, c(0.025, 0.5, 0.975)) 2.5% 50% 97.5%
1.849857 2.024287 2.239057 Trung vị của các OR là 2,02, sát RR hiệu chỉnh theo tuổi 2,05 của đoàn hệ; 95% số đoàn hệ con cho OR từ 1,85 đến 2,24.
Với mỗi ca, tập nguy cơ là những người cùng nhóm tuổi, cùng giới và còn được theo dõi lâu hơn ca đó. Ta rút 4 chứng từ tập nguy cơ của từng ca.
dh <- mutate(dh, tang = paste(nhom_tuoi, gioi))
set.seed(2025)
bo <- bind_rows(lapply(which(dh$bien_co_tm == 1), function(i) {
  tap <- which(dh$tang == dh$tang[i] & dh$thoi_gian > dh$thoi_gian[i])   # tập nguy cơ của ca i
  tibble(bo_ghep = i, ca_benh = c(1, 0, 0, 0, 0), tha = dh$tha[c(i, sample(tap, 4))])
}))
tom <- bo |> group_by(bo_ghep) |>
  summarise(ca_tha = tha[ca_benh == 1], chung_tha = sum(tha[ca_benh == 0]))
# OR Mantel–Haenszel cho các bộ 1 ca : 4 chứng
or_tu_chon <- sum((tom$ca_tha == 1) * (4 - tom$chung_tha)) / sum((tom$ca_tha == 0) * tom$chung_tha)
or_tu_chon
[1] 2.141383Tử số đếm các cặp “ca THA, chứng không THA” trong cùng bộ ghép; mẫu số đếm các cặp “ca không THA, chứng THA”. Kết quả 2,14 gần OR 2,19 của bc_mat_do và IRR 2,16 của đoàn hệ; phần chênh nhỏ còn lại là do may rủi khi chọn chứng.
Hồi quy tỷ lệ ĐTĐ theo tỷ lệ có điện thoại ở cấp xã, rồi so với PR tính trên từng người, phân tầng theo xã.
xa <- read_csv(dth_path("data/sinh_thai_xa.csv"), show_col_types = FALSE)
cn <- read_csv(dth_path("data/sinh_thai_ca_nhan.csv"), show_col_types = FALSE)
hq <- coef(lm(ty_le_dtd ~ ty_le_dien_thoai_tm, data = xa))
(hq[1] + hq[2]) / hq[1]                                # PR "sinh thái" ngoại suy
(Intercept)
9.626671 dx <- function(dk) as.numeric(tapply(dk, cn$ma_xa, sum))
a <- dx(cn$dtd == 1 & cn$dien_thoai_tm == 1); b <- dx(cn$dtd == 0 & cn$dien_thoai_tm == 1)
c <- dx(cn$dtd == 1 & cn$dien_thoai_tm == 0); d <- dx(cn$dtd == 0 & cn$dien_thoai_tm == 0)
mh_rr(a, b, c, d)$estimate # PR phân tầng theo xã[1] 0.9999973PR sinh thái ngoại suy là 9,6; PR cá nhân phân tầng theo xã là 1,00. Hai con số trả lời hai câu hỏi khác nhau, và chỉ con số thứ hai nói về từng người.
Tóm tắt đặc điểm lúc tuyển theo nhánh, rồi tính RD theo ý định điều trị trên những người có kết quả.
sms_th <- read_csv(dth_path("data/thu_nghiem_sms.csv"), show_col_types = FALSE)
sms_th |> group_by(nhom) |>
  summarise(n = n(), tuoi = mean(tuoi), nam = mean(gioi == "nam"), ha_0 = mean(ha_tam_thu_0))
# A tibble: 2 × 5
nhom n tuoi nam ha_0
<chr> <int> <dbl> <dbl> <dbl>
1 can_thiep 300 60.2 0.49 151.
2 chung 300 59.3 0.417 150.kq <- sms_th |> filter(mat_dau == 0) |> group_by(nhom) |>
summarise(co = sum(kiem_soat_ha), khong = sum(kiem_soat_ha == 0))
two_by_two(kq$co[kq$nhom == "can_thiep"], kq$khong[kq$nhom == "can_thiep"],
kq$co[kq$nhom == "chung"], kq$khong[kq$nhom == "chung"]) measure estimate lower upper se
1 RR 1.2819450 1.09237292 1.5044158 0.08164750
2 RD 0.1303617 0.04793116 0.2127922 0.04205716
3 OR 1.6922757 1.20869497 2.3693300 0.17170366Dòng RD cho 0,13 (KTC 95%: 0,05–0,21), giống ở Mục 4.4. Thay filter(mat_dau == 0) bằng filter(mat_dau == 0, nhom == "chung" | tuan_thu == 1) thì sẽ thấy phân tích theo đề cương cho RD 0,18.
Nhóm chứng đại diện cho mẫu số nào thì OR ước lượng đại lượng ấy.
| Cách chọn chứng | Chứng được chọn từ | OR ước lượng | Cần bệnh hiếm? |
|---|---|---|---|
| Tích lũy | Người chưa có biến cố, ở cuối kỳ | Tỷ số chênh nguy cơ | Chỉ khi muốn đọc như RR |
| Theo mật độ | Tập nguy cơ, ở thời điểm mỗi ca | Tỷ số tỷ suất (IRR) | Không |
| Bệnh–đoàn hệ | Mọi người, lúc bắt đầu | Tỷ số nguy cơ (RR) | Không |
Đọc thêm.