Một bệnh nhân vừa được chẩn đoán tăng huyết áp hỏi bác sĩ: “Như tôi thì nguy cơ bị tai biến, nhồi máu cơ tim cao hơn người khác bao nhiêu?” Câu hỏi nghe đơn giản, vậy mà có ít nhất ba cách trả lời trung thực, và ba cách ấy nghe rất khác nhau. Dựa vào đoàn hệ tim mạch giả định của sách, tức một nhóm người được theo dõi qua nhiều năm, bác sĩ có thể nói:
“Nguy cơ biến cố tim mạch trong 10 năm của anh gấp khoảng 2,8 lần người không tăng huyết áp.”
“Trong 10 năm, có thêm khoảng 96 ca biến cố trên 1.000 người tăng huyết áp, so với người không tăng huyết áp.”
“Khoảng 65% số biến cố ở người tăng huyết áp là phần vượt quá nguy cơ nền.”
Câu thứ nhất là một tỷ số, câu thứ hai là một hiệu, câu thứ ba là một phân số, nhưng cả ba đều tính từ cùng một bảng bốn ô. Chương này dạy bạn tính từng con số, đọc cho đúng, và chọn con số hợp với câu hỏi. Chương cũng cho thấy vì sao những con số thô, tức chưa hiệu chỉnh gì, lại phóng đại khi có nhiễu, nghĩa là khi một yếu tố khác như tuổi xen vào phép so sánh, và vì sao phân số quy thuộc của cả quần thể cần hiệu chỉnh theo một cách riêng.
Học xong chương này, bạn có thể:
lập bảng 2×2 và tính tỷ số nguy cơ, tỷ số tỷ suất, tỷ số chênh, tỷ số hiện mắc, hiệu nguy cơ và hiệu tỷ suất;
diễn giải mỗi số đo bằng một câu tiếng Việt chính xác, kể cả giá trị ứng với “không có kết hợp”;
giải thích khi nào tỷ số chênh xấp xỉ tỷ số nguy cơ và khi nào không;
chọn giữa thang tương đối và thang tuyệt đối cho một câu hỏi lâm sàng hay y tế công cộng;
tính và diễn giải phân số quy thuộc ở nhóm phơi nhiễm, phân số quy thuộc quần thể và số người cần điều trị, đồng thời nhận ra vì sao công thức Levin cho kết quả sai khi có nhiễu.
Dữ liệu giả định
Mọi số liệu trong chương này đều là dữ liệu giả định, mô phỏng từ mô hình có hạt giống ngẫu nhiên cố định, và không phản ánh địa phương hay cơ sở y tế có thật nào. Chương dùng ba bộ dữ liệu: doan_he_tim_mach (đoàn hệ tim mạch tỉnh Bạch Hải, Mục C.3.7), doan_he_tiem_nang (cùng đoàn hệ đó, kèm “sự thật” mà mô phỏng biết) và thu_nghiem_sms (thử nghiệm nhắc tái khám bằng tin nhắn ở tỉnh Lục Vân, Mục C.3.15).
3.1 So sánh hai nhóm: bảng 2×2
3.1.1 Đoàn hệ tim mạch Bạch Hải
Năm 2015, 20.000 người dân tỉnh Bạch Hải, tuổi từ 40 đến 74, được khám sức khỏe nền, tức lần khám lúc bắt đầu nghiên cứu, rồi được theo dõi trong 10 năm, đến năm 2025. Bạn đã gặp đoàn hệ này ở Chương 1; cách chọn người và cách ghi nhận biến cố có ở Mục C.3.7. Phơi nhiễm (exposure), tức yếu tố ta muốn xem có đi kèm bệnh hay không, ở đây là tăng huyết áp (THA) lúc khám nền. Kết cục (outcome), tức điều ta đếm, là biến cố tim mạch lớn đầu tiên trong thời gian theo dõi: đột quỵ, nhồi máu cơ tim hoặc tử vong do tim mạch. “Lớn” ở đây là nặng về lâm sàng, và ai gặp nhiều biến cố cũng chỉ được tính một lần.
Ở Chương 1, bạn đã tính nguy cơ (risk) và tỷ suất mới mắc (incidence rate) cho cả đoàn hệ. Chương này làm một việc mới là đặt hai nhóm cạnh nhau: người THA có nhiều biến cố hơn người không THA bao nhiêu? Câu trả lời nào cũng bắt đầu từ một bảng có bốn ô.
3.1.2 Bốn ô, hai hàng, hai cột
Bảng 2×2 (two-by-two table) đếm số người theo hai câu hỏi có–không: có phơi nhiễm không, và có kết cục không. Sách luôn xếp phơi nhiễm theo hàng, nhóm phơi nhiễm ở hàng trên, còn kết cục theo cột, cột “có bệnh” ở bên trái (Bảng 3.1). Bố cục này giữ nguyên trong cả cuốn sách (xem Mục B.5). Sách khác có thể xếp ngược lại, nên khi đọc những sách ấy, hãy kiểm tra hàng và cột trước khi áp công thức (Mục B.10).
Bảng 3.1: Bố cục của bảng 2×2 dùng trong cả cuốn sách.
Có bệnh (\(Y = 1\))
Không bệnh (\(Y = 0\))
Tổng
Phơi nhiễm (\(X = 1\))
\(a\)
\(b\)
\(n_1 = a + b\)
Không phơi nhiễm (\(X = 0\))
\(c\)
\(d\)
\(n_0 = c + d\)
Tổng
\(m_1 = a + c\)
\(m_0 = b + d\)
\(n\)
Đọc theo hàng thì mỗi hàng là một nhóm so sánh: \(a\) trong \(n_1\) người phơi nhiễm có bệnh, \(c\) trong \(n_0\) người không phơi nhiễm có bệnh. Đọc theo cột thì cột trái là toàn bộ \(m_1\) ca bệnh, chia theo tình trạng phơi nhiễm. Cách đọc nào cũng có ích; cách đọc theo cột sẽ còn trở lại ở Mục 3.3 và Mục 3.6.
Điền dữ liệu của đoàn hệ vào bảng này, ta được Bảng 3.2.
Bảng 3.2: Tăng huyết áp lúc nền và biến cố tim mạch trong 10 năm, đoàn hệ tim mạch Bạch Hải. Dữ liệu giả định.
Có biến cố
Không biến cố
Tổng
Nguy cơ 10 năm
Tăng huyết áp
891
5.110
6.001
14,8%
Không tăng huyết áp
737
13.262
13.999
5,3%
Tổng
1.628
18.372
20.000
8,1%
Trong 6.001 người THA có 891 người bị biến cố tim mạch; trong 13.999 người không THA, con số này là 737. Tỷ lệ THA trong đoàn hệ là 30,0%.
3.1.3 Khi theo dõi không đều: người-thời gian
Không phải ai cũng được theo dõi đủ 10 năm. Người bị biến cố tim mạch rời khỏi nhóm có nguy cơ ngay khi biến cố xảy ra, người tử vong vì nguyên nhân khác cũng vậy. Trong dữ liệu giả định, không ai mất theo dõi (loss to follow-up), tức không ai bỏ dở hay mất liên lạc giữa chừng, nên chỉ hai lý do ấy làm thời gian theo dõi ngắn lại. Ở Chương 1, ta đã xử lý chuyện này bằng người-thời gian (person-time), tức cộng số năm mà từng người thực sự được theo dõi. Thay cột “Không biến cố” bằng tổng người-năm theo dõi của mỗi nhóm, ta được dạng thứ hai của bảng 2×2 (Bảng 3.3).
Bảng 3.3: Số biến cố tim mạch, người-năm theo dõi và tỷ suất mới mắc theo tình trạng tăng huyết áp. Người-năm tính đến biến cố tim mạch, tử vong do nguyên nhân khác hoặc hết thời gian theo dõi. Dữ liệu giả định.
Số biến cố
Người-năm
Tỷ suất (trên 1.000 người-năm)
Tăng huyết áp
891
51.207
17,4
Không tăng huyết áp
737
130.492
5,6
Tổng
1.628
181.699
9,0
Các ô của dạng này là \(a\) và \(c\) (số ca) cùng \(T_1\) và \(T_0\) (người-thời gian của nhóm phơi nhiễm và không phơi nhiễm). Trung bình mỗi người THA đóng góp 8,53 năm theo dõi, mỗi người không THA đóng góp 9,32 năm. Phần chênh nhỏ ấy sẽ có ý nghĩa ở mục sau.
3.1.4 Kết hợp chưa phải là tác động
Mọi số đo trong chương này đều so sánh hai nhóm người có thật: những người đã THA và những người không THA. Những số đo như thế gọi là số đo kết hợp (measure of association). Còn một câu hỏi khác: nếu chính những người này không bị THA thì nguy cơ của họ sẽ là bao nhiêu? Đại lượng trả lời câu hỏi đó là số đo tác động (measure of effect), so sánh cùng một nhóm người trong hai tình huống, một có thật và một giả định (Lash và c.s. 2021, ch 5).
Hai loại số đo dùng chung công thức nên dễ lẫn. Chúng chỉ trùng nhau khi nhóm không phơi nhiễm cho biết đúng điều sẽ xảy ra với nhóm phơi nhiễm nếu nhóm này không phơi nhiễm. Điều kiện đó xin dành cho Chương 6, còn cách nhận ra và kiểm soát nhiễu (confounding) xin dành cho Chương 7. Trong chương này, ta dùng lời lẽ của sự kết hợp: “người THA có nguy cơ cao hơn”, chứ không nói “THA làm tăng nguy cơ”. Ngoại lệ duy nhất là phần cuối của Mục 3.6: ở đó ta cố ý đối chiếu với “sự thật” mà mô phỏng biết.
3.2 Tỷ số nguy cơ và tỷ số tỷ suất
3.2.1 Gấp bao nhiêu lần
Cách so sánh tự nhiên nhất là hỏi “gấp bao nhiêu lần”. Chia nguy cơ của nhóm phơi nhiễm cho nguy cơ của nhóm không phơi nhiễm, ta được tỷ số nguy cơ (risk ratio, RR). Nhiều sách gọi đại lượng này là nguy cơ tương đối (relative risk); sách này dùng tên tỷ số nguy cơ và dành riêng chữ viết tắt RR cho nó. Khi dữ liệu là người-thời gian, ta đem hai tỷ suất chia cho nhau và được tỷ số tỷ suất (rate ratio, IRR):
Số ca bệnh ở nhóm phơi nhiễm, nhóm không phơi nhiễm
\(n_1\), \(n_0\)
“en một”, “en không”
Số người ở nhóm phơi nhiễm, nhóm không phơi nhiễm lúc bắt đầu theo dõi
\(\text{IRR}\)
“i R R”
Tỷ số tỷ suất
\(I_1\), \(I_0\)
“i một”, “i không”
Tỷ suất mới mắc ở nhóm phơi nhiễm, nhóm không phơi nhiễm
\(T_1\), \(T_0\)
“tê một”, “tê không”
Người-thời gian của nhóm phơi nhiễm, nhóm không phơi nhiễm
Trong đoàn hệ tim mạch, \(R_1\) là nguy cơ 10 năm ở người THA, còn \(R_0\) là nguy cơ ở người không THA (Szklo và Nieto 2014, tr. 80; Celentano và Szklo 2019, tr. 242–244).
Đoán trước khi đọc tiếp · mức dễ. Giả sử người THA và người không THA có nguy cơ biến cố như nhau. Khi đó tỷ số nguy cơ bằng bao nhiêu?
Công thức này kéo theo ba tính chất chung của mọi tỷ số. Thứ nhất, hai nhóm có cùng nguy cơ thì tỷ số bằng 1. Giá trị ứng với “không có kết hợp” gọi là giá trị không (null value), và với mọi tỷ số, giá trị không đều là 1. Thứ hai, tỷ số chạy từ 0 đến vô cùng: dưới 1 khi nhóm phơi nhiễm có nguy cơ thấp hơn, trên 1 khi cao hơn. Thứ ba, tỷ số không có đơn vị, vì hai nguy cơ (hoặc hai tỷ suất) cùng đơn vị triệt tiêu nhau. Đo khác biệt bằng phép chia nên tỷ số nằm trên thang tương đối (relative scale) (Lash và c.s. 2021, ch 5).
3.2.2 Tỷ số nguy cơ trong đoàn hệ
Từ Bảng 3.2, \(R_1 = 891/6.001 = 0{,}1485\) và \(R_0 = 737/13.999 = 0{,}0526\), nên tỷ số nguy cơ là 2,82 (KTC 95%: 2,57–3,09). Khoảng tin cậy (confidence interval, KTC) đi kèm cho biết độ chính xác của ước lượng; khoảng này hẹp vì phép so sánh dựa trên 1.628 biến cố. Cách tính và ý nghĩa của KTC xin dành cho Chương 5.
Câu diễn giải mẫu, nên dùng gần như nguyên văn:
Trong dữ liệu giả định của đoàn hệ Bạch Hải, nguy cơ biến cố tim mạch trong 10 năm ở người tăng huyết áp bằng 2,82 lần nguy cơ ở người không tăng huyết áp.
Câu này có ba thành phần không được bỏ: nguy cơ (không phải “khả năng” chung chung), khoảng thời gian (10 năm), và nhóm so sánh (người không THA). Thiếu thời gian thì người nghe không biết đó là nguy cơ một năm hay cả đời; thiếu nhóm so sánh thì chữ “gấp” mất nghĩa.
Nói theo phần trăm thì phải cẩn thận. Tỷ số 2,82 nghĩa là nguy cơ cao hơn 182%, chứ không phải 282%, vì phần trăm tăng thêm là \((\text{RR} - 1) \times 100\%\). Lỗi này rất hay gặp trên báo chí, và cả trong bài báo khoa học.
3.2.3 Tỷ số tỷ suất, và vì sao nó xa 1 hơn
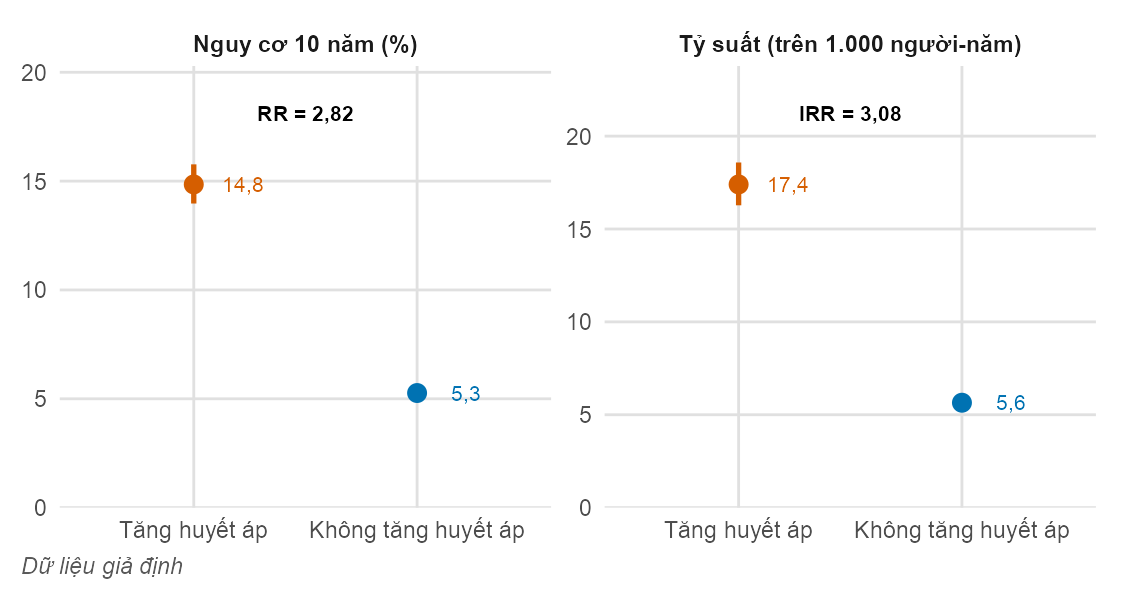
Từ Bảng 3.3, tỷ suất ở người THA là \(I_1 = 17{,}4\) trên 1.000 người-năm, ở người không THA là \(I_0 = 5{,}6\), nên tỷ số tỷ suất là 3,08 (KTC 95%: 2,79–3,40). Câu diễn giải: tỷ suất biến cố tim mạch ở người THA bằng 3,08 lần tỷ suất ở người không THA (Hình 3.1).
Xem mã R
hinh_nguy_co_ty_suat() +gia_dinh()
Hình 3.1: Nguy cơ biến cố tim mạch trong 10 năm (trái) và tỷ suất mới mắc (phải) theo tình trạng tăng huyết áp, kèm KTC 95%. Cùng một dữ liệu, tỷ số tỷ suất xa 1 hơn tỷ số nguy cơ. Dữ liệu giả định.
Hai tỷ số cùng đúng mà không bằng nhau: IRR 3,08, RR 2,82. Lý do nằm ở mẫu số: nguy cơ chia số ca cho số người lúc bắt đầu, còn tỷ suất chia cho người-thời gian. Người THA bị biến cố nhiều hơn, nên nhiều người trong số họ rời nhóm có nguy cơ sớm hơn. Họ cũng lớn tuổi hơn, nên nhiều người chết vì nguyên nhân khác trước khi kịp có biến cố tim mạch: 12,1% so với 7,9% trong 10 năm. Kết quả là mỗi người THA đóng góp ít người-năm hơn, trung bình 8,53 năm so với 9,32 năm. Mẫu số của \(I_1\) vì thế co lại nhiều hơn mẫu số của \(I_0\), và tỷ số tỷ suất bị đẩy xa 1 hơn tỷ số nguy cơ.
Ở Chương 1, bạn đã thấy nguy cơ chỉ xấp xỉ tỷ suất nhân với thời gian khi biến cố hiếm. Hệ quả đối với phép so sánh là khi kết cục hiếm ở cả hai nhóm thì RR và IRR gần như trùng nhau, còn khi kết cục phổ biến, như ở đây người THA có nguy cơ 15%, thì hai số đo tách ra (Lash và c.s. 2021, ch 5). Không con số nào “sai”: đó là hai số đo khác nhau, trả lời hai câu hỏi hơi khác nhau, và một bài báo phải nói rõ mình báo cáo số đo nào.
3.3 Tỷ số chênh
3.3.1 Odds và tỷ số chênh trong đoàn hệ
Odds của bệnh là nguy cơ chia cho phần còn lại, \(R/(1-R)\) (xem Chương 1). Trong bảng 2×2, odds của nhóm phơi nhiễm rút gọn thành \(a/b\): số người có bệnh chia cho số người không bệnh trong cùng hàng. Ở người THA, odds là 891/5.110 \(=\) 0,174; ở người không THA, 737/13.262 \(=\) 0,056.
Chia hai odds cho nhau, ta được tỷ số chênh (odds ratio, OR):
Odds của bệnh ở nhóm phơi nhiễm: số có bệnh chia số không bệnh
\(c/d\)
“c chia d”
Odds của bệnh ở nhóm không phơi nhiễm
\(ad/bc\)
“a đê chia b c”
Tích chéo: tích hai ô trên đường chéo chính chia tích hai ô còn lại
Như mọi tỷ số, OR có giá trị không bằng 1, chạy từ 0 đến vô cùng và không có đơn vị (Szklo và Nieto 2014, tr. 80–81; Celentano và Szklo 2019, tr. 245–248). Trong đoàn hệ tim mạch, OR là 3,14 (KTC 95%: 2,83–3,48).
3.3.2 Khi nào tỷ số chênh gần tỷ số nguy cơ
Tỷ số chênh 3,14 lớn hơn tỷ số nguy cơ 2,82, và khoảng cách ấy có quy luật. Viết odds theo nguy cơ rồi sắp xếp lại, ta được một đẳng thức chính xác:
Đoán trước khi đọc tiếp · mức vừa. Trong đoàn hệ này, phơi nhiễm đi kèm nguy cơ cao hơn và OR 3,14 lớn hơn RR 2,82. Giờ giả sử có một phơi nhiễm đi kèm nguy cơ thấp hơn, tức RR dưới 1. Khi đó OR nằm ở đâu so với RR?
Phân số cuối là hệ số sửa. Khi nhóm phơi nhiễm có nguy cơ cao hơn (\(R_1 > R_0\)), tử số lớn hơn mẫu số nên hệ số sửa lớn hơn 1, và OR xa 1 hơn RR. Khi phơi nhiễm đi kèm nguy cơ thấp hơn thì OR nhỏ hơn RR, tức là cũng xa 1 hơn. Vì vậy, đọc tỷ số chênh như một tỷ số nguy cơ thì ta luôn phóng đại độ mạnh của kết hợp (Szklo và Nieto 2014, tr. 82–83; Lash và c.s. 2021, ch 5).
Hệ số sửa gần 1 khi cả \(R_1\) lẫn \(R_0\) đều nhỏ. Giả định bệnh hiếm (rare-disease assumption) nói đúng điều đó: khi bệnh hiếm ở cả hai nhóm thì OR xấp xỉ RR. Tính trên cả đoàn hệ, hệ số sửa là \((1 - 0{,}053)/(1 - 0{,}148) = 1{,}113\), nên OR lớn hơn RR khoảng 11%.
3.3.3 Ví dụ: khi tỷ số chênh đánh lừa
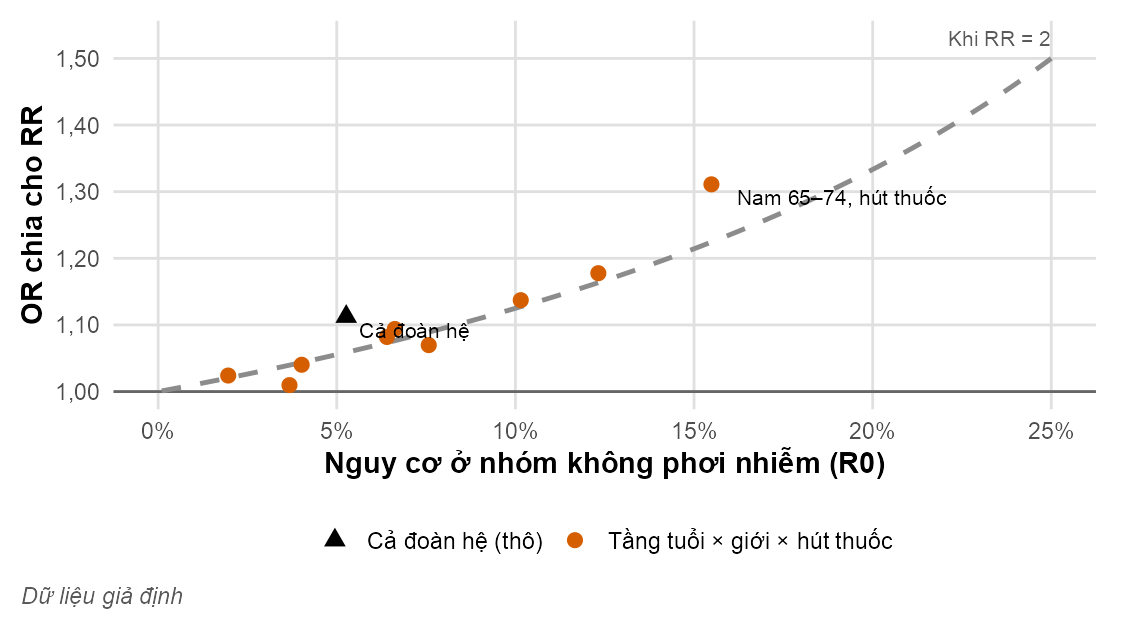
Mức 11% nghe có vẻ vô hại. Nhưng nguy cơ biến cố tim mạch không đều trong đoàn hệ: nguy cơ tăng theo tuổi, và cao hơn ở nam cũng như ở người hút thuốc. Ta chia đoàn hệ thành các tầng (stratum), mỗi tầng gồm những người cùng nhóm tuổi, cùng giới và cùng hút hoặc cùng không hút thuốc, rồi tính OR và RR trong từng tầng. Có 3 tầng nữ hút thuốc chỉ có dưới 100 người THA, quá ít để tính, nên ta bỏ qua; còn lại 9 tầng (Hình 3.2).
Xem mã R
hinh_or_rr() +gia_dinh()
Hình 3.2: Tỷ số giữa OR và RR theo nguy cơ của nhóm không phơi nhiễm. Mỗi điểm tròn là một tầng tuổi × giới × hút thuốc của đoàn hệ; tam giác là cả đoàn hệ. Đường đứt cho quan hệ chính xác khi RR = 2. Nguy cơ nền càng cao, OR càng xa RR. Dữ liệu giả định.
Ở nam 40–54 tuổi không hút thuốc, nguy cơ nền chỉ 3,7% nên OR gần như trùng RR. Ở nam 65–74 tuổi hút thuốc, người không THA đã có nguy cơ 15,5%, người THA có nguy cơ 35,5%. Trong tầng này, RR là 2,29 (KTC 95%: 1,80–2,92), còn OR là 3,01 (KTC 95%: 2,21–4,09). Nếu đọc OR như một tỷ số nguy cơ, ta sẽ nói người THA trong nhóm này có nguy cơ “gấp 3,0 lần”, trong khi thực ra nguy cơ chỉ gấp 2,3 lần.
Đây chính là những bệnh nhân bác sĩ tim mạch gặp hằng ngày: lớn tuổi, nhiều yếu tố nguy cơ. Ở những người như vậy, bệnh không hiếm, nên tỷ số chênh không còn là một xấp xỉ tốt của tỷ số nguy cơ.
Hiểu lầm thường gặp
“Mô hình hồi quy logistic cho OR lớn, vậy nguy cơ tăng đúng chừng ấy lần.” Hồi quy logistic là mô hình thống kê rất hay gặp trong bài báo, và kết quả của nó là OR; câu trên chỉ đúng khi kết cục hiếm ở cả hai nhóm. Tỷ số chênh là số đo kết hợp hợp lệ, nhưng thứ nó so sánh là odds chứ không phải nguy cơ. Khi kết cục phổ biến, hãy báo cáo nó đúng tên là tỷ số chênh, hoặc tính thẳng tỷ số nguy cơ nếu thiết kế cho phép.
3.3.4 Một tính chất đặc biệt: tỷ số chênh đối xứng
Tỷ số chênh có một tính chất mà tỷ số nguy cơ không có. Lần này ta đọc bảng 2×2 theo cột thay vì theo hàng. Trong số ca bệnh, odds phơi nhiễm là \(a/c\): số ca có THA chia số ca không THA; trong số người không bệnh, odds phơi nhiễm là \(b/d\). Chia hai odds này cho nhau, ta được:
Odds phơi nhiễm trong số người có bệnh (đọc theo cột trái)
\(b/d\)
“b chia d”
Odds phơi nhiễm trong số người không bệnh (đọc theo cột phải)
\(a/b\), \(c/d\)
“a chia b”, “c chia d”
Odds bệnh ở nhóm phơi nhiễm, nhóm không phơi nhiễm (đọc theo hàng)
Tỷ số chênh của phơi nhiễm, so giữa người có bệnh và người không bệnh, bằng đúng tỷ số chênh của bệnh, so giữa người phơi nhiễm và không phơi nhiễm, vì cả hai đều là tích chéo \(ad/bc\)(Szklo và Nieto 2014, tr. 91–92; Lash và c.s. 2021, ch 8). Trong đoàn hệ, odds THA trong số ca là 891/737 \(=\) 1,209, trong số người không biến cố là 5.110/13.262 \(=\) 0,385, và tỷ số của hai odds này lại chính là 3,14.
Vì sao tính chất này quan trọng? Vì có những nghiên cứu chỉ biết cột mà không biết hàng. Nghiên cứu bệnh–chứng (case-control study) chọn người theo tình trạng bệnh rồi mới hỏi về phơi nhiễm. Thiết kế này không có \(n_1\) và \(n_0\) thật nên không tính được nguy cơ, nhưng vẫn tính được odds phơi nhiễm trong mỗi cột, và nhờ tính đối xứng, tỷ số của hai odds ấy vẫn là một tỷ số chênh có nghĩa. Còn tỷ số đó ước lượng điều gì thì tùy cách chọn nhóm chứng, một câu hỏi xin dành cho Chương 4.
Lưu ý: các sách trình bày khác nhau
Tỷ số chênh trong nghiên cứu bệnh–chứng có cần giả định bệnh hiếm không?Gordis Epidemiology trình bày giả định bệnh hiếm như một trong các điều kiện để tỷ số chênh của nghiên cứu bệnh–chứng ước lượng tốt tỷ số nguy cơ (Celentano và Szklo 2019, tr. 248–249). Szklo và Nieto cho thấy không cần giả định này khi nhóm chứng là một mẫu của toàn bộ quần thể nguồn, còn khi nhóm chứng được chọn theo mật độ thì tỷ số chênh ước lượng tỷ số tỷ suất (Szklo và Nieto 2014, tr. 96–99). Modern Epidemiology đi từ lý thuyết thiết kế mà cũng đến cùng kết luận ấy: giả định bệnh hiếm chỉ cần khi nhóm chứng được chọn trong số những người đến cuối thời gian theo dõi vẫn chưa mắc bệnh (Lash và c.s. 2021, ch 8).
Khác biệt này làm thay đổi điều người đọc rút ra từ một nghiên cứu bệnh–chứng về một bệnh phổ biến. Sách theo Modern Epidemiology, cuốn sách dẫn đầu về lý thuyết thiết kế, và sẽ trình bày chi tiết ở Chương 4. Chương này chỉ khẳng định điều cả ba sách đều đồng ý: trong một đoàn hệ, tỷ số chênh xấp xỉ tỷ số nguy cơ khi bệnh hiếm ở cả hai nhóm.
3.4 Số đo trong nghiên cứu cắt ngang: tỷ số hiện mắc
Nghiên cứu cắt ngang (cross-sectional study) đo phơi nhiễm và bệnh tại cùng một thời điểm. Thiết kế này không đếm ca mới mà chỉ đếm người đang có bệnh, nên đo được tỷ lệ hiện mắc (prevalence) chứ không đo được nguy cơ. Để so sánh hai tỷ lệ hiện mắc, ta có hai lựa chọn quen thuộc: tỷ số hiện mắc (prevalence ratio, PR) và tỷ số chênh hiện mắc (prevalence odds ratio, POR):
Tỷ lệ hiện mắc ở nhóm phơi nhiễm, nhóm không phơi nhiễm
\(P/(1 - P)\)
“P chia một trừ P”
Odds hiện mắc
Hai số đo này là bản sao của RR và OR, chỉ khác ở chỗ thay nguy cơ bằng tỷ lệ hiện mắc (Szklo và Nieto 2014, tr. 90; Lash và c.s. 2021, ch 5). Quan hệ giữa hai số đo cũng giống như ở công thức 3.3: POR xa 1 hơn PR, và chỉ gần PR khi tỷ lệ hiện mắc thấp ở cả hai nhóm.
3.4.1 Ví dụ: phì đại thất trái lúc khám nền
Bản thân lần khám nền năm 2015 của đoàn hệ Bạch Hải đã là một nghiên cứu cắt ngang. Điện tim lúc ấy cho biết ai đang bị phì đại thất trái, một hậu quả của THA kéo dài. Ở người THA, tỷ lệ hiện mắc phì đại thất trái là \(P_1 = 0{,}295\); ở người không THA, \(P_0 = 0{,}049\).
Tỷ số hiện mắc là 6,06 (KTC 95%: 5,57–6,58), còn tỷ số chênh hiện mắc là 8,18 (KTC 95%: 7,44–8,99). Về mặt số học, cả hai con số đều đúng. Nhưng nếu đọc POR như một tỷ số hiện mắc, ta sẽ phóng đại khoảng cách giữa hai nhóm thêm 35%, bởi có tới 30% người THA đang bị phì đại thất trái: trong nhóm này, tình trạng ấy không hiếm.
3.4.2 Tỷ lệ hiện mắc trộn hai thứ
Ở Chương 1, bạn đã gặp quan hệ giữa odds hiện mắc, tỷ suất mới mắc và thời gian mắc bệnh trung bình. Hệ quả đối với phép so sánh là một khác biệt về tỷ lệ hiện mắc có thể do khác biệt về tỷ suất mới mắc, do khác biệt về thời gian người bệnh mang bệnh, hoặc do cả hai (Szklo và Nieto 2014, tr. 90; Lash và c.s. 2021, ch 5). Nếu người THA bị phì đại thất trái tử vong sớm hơn thì họ rời khỏi “bể hiện mắc” nhanh hơn, và PR sẽ thấp hơn tỷ số tỷ suất mới mắc tương ứng.
Nghiên cứu cắt ngang còn một giới hạn nữa: không cho biết phơi nhiễm hay bệnh có trước. Ở ví dụ này, nhờ kiến thức sinh lý bệnh mà ta biết THA dẫn đến phì đại thất trái chứ không phải ngược lại, nhưng với nhiều cặp phơi nhiễm–bệnh khác, ta không có được kiến thức ấy. Vai trò mắt xích trung gian của phì đại thất trái giữa THA và biến cố tim mạch sẽ trở lại ở Chương 7.
3.5 Hiệu nguy cơ và hiệu tỷ suất: thang tuyệt đối
3.5.1 Thêm bao nhiêu ca
Tỷ số trả lời câu hỏi “gấp bao nhiêu lần”, nhưng người lập kế hoạch y tế thường hỏi một câu khác: “thêm bao nhiêu ca?”. Muốn trả lời câu ấy, ta trừ thay vì chia. Hiệu nguy cơ (risk difference, RD) và hiệu tỷ suất (rate difference, IRD) là:
Hiệu nguy cơ, cùng đơn vị với nguy cơ (một tỷ lệ trong một khoảng thời gian)
\(R_1\), \(R_0\)
“R một”, “R không”
Nguy cơ ở nhóm phơi nhiễm, nhóm không phơi nhiễm
\(\text{IRD}\)
“i R D”
Hiệu tỷ suất, cùng đơn vị với tỷ suất (ca trên người-thời gian)
\(I_1\), \(I_0\)
“i một”, “i không”
Tỷ suất ở nhóm phơi nhiễm, nhóm không phơi nhiễm
Hiệu nằm trên thang tuyệt đối (absolute scale), có giá trị không là 0 chứ không phải 1. Hiệu có thể âm, khi nhóm phơi nhiễm có nguy cơ thấp hơn, và luôn mang đơn vị của số đo gốc. Vì vậy hiệu nguy cơ luôn phải kèm khoảng thời gian, còn hiệu tỷ suất luôn phải kèm đơn vị người-thời gian (Lash và c.s. 2021, ch 5; Szklo và Nieto 2014, tr. 84–85; Celentano và Szklo 2019, tr. 259–260).
Trong đoàn hệ tim mạch, hiệu nguy cơ là 0,0958, tức 96 (KTC 95%: 86–106) ca trên 1.000 người trong 10 năm. Câu diễn giải: trong 10 năm, người THA có thêm khoảng 96 ca biến cố tim mạch trên 1.000 người so với người không THA. Hiệu tỷ suất là 11,8 (KTC 95%: 10,5–13,0) ca trên 1.000 người-năm.
Cũng có thể viết hiệu nguy cơ theo điểm phần trăm: 9,6 điểm phần trăm. Nhưng đừng viết “9,6%” trơn, vì người đọc sẽ không biết đó là một hiệu hay một mức tăng tương đối.
3.5.2 Ví dụ: cùng tỷ số, khác hiệu
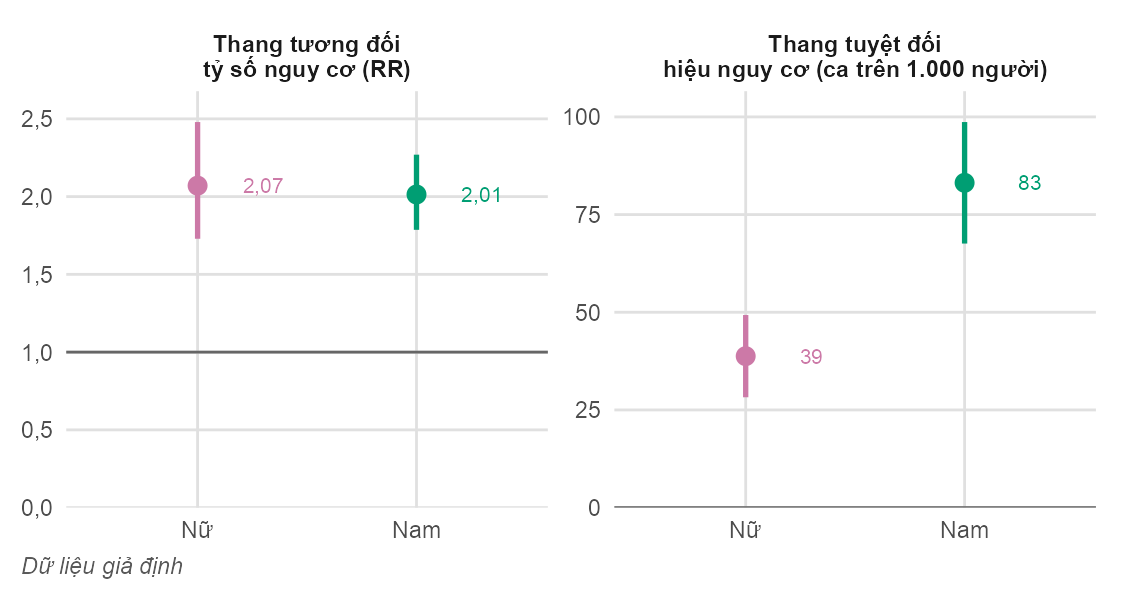
Giờ ta so sánh nữ với nam. Nam có nguy cơ nền cao hơn nữ, và cơ cấu tuổi của hai giới trong đoàn hệ cũng không hoàn toàn giống nhau. Để hai giới đứng trên cùng một cơ cấu tuổi, ta chuẩn hóa trực tiếp nguy cơ của từng nhóm theo cơ cấu tuổi của cả đoàn hệ, đúng như cách chuẩn hóa tỷ suất ở Mục 2.3. Đặt kết quả lên hai thang, ta có Hình 3.3.
Đoán trước khi đọc tiếp · mức khó. Sau khi chuẩn hóa theo tuổi, RR giữa người THA và người không THA gần như bằng nhau ở hai giới: 2,07 ở nữ, 2,01 ở nam. Nhưng nguy cơ nền của nam không THA là 8,2%, của nữ không THA chỉ 3,6%. Tính theo số ca thêm trên 1.000 người, người THA ở nam chênh với người không THA nhiều hay ít hơn ở nữ?
Xem mã R
hinh_thang_gioi() +gia_dinh()
Hình 3.3: Tỷ số nguy cơ (trái) và hiệu nguy cơ (phải) giữa người tăng huyết áp và không tăng huyết áp, theo giới, chuẩn hóa theo tuổi, kèm KTC 95%. Trên thang tương đối hai giới gần như bằng nhau; trên thang tuyệt đối, hiệu ở nam lớn hơn hẳn. Dữ liệu giả định.
Trên thang tương đối, hai giới gần như không khác nhau: RR chuẩn hóa theo tuổi là 2,07 (KTC 95%: 1,73–2,48) ở nữ và 2,01 (KTC 95%: 1,79–2,27) ở nam. Trên thang tuyệt đối thì khác biệt hiện ra rất rõ: hiệu nguy cơ là 39 ca trên 1.000 người ở nữ và 83 ca trên 1.000 người ở nam, gấp 2,1 lần.
Hai kết quả này không mâu thuẫn gì với nhau. Nguy cơ nền của nam không THA là 8,2%, của nữ là 3,6%, mà cùng một tỷ số nhân lên một nền cao hơn thì cho một hiệu lớn hơn. Ở đây trực giác dễ đánh lừa ta. Câu hỏi “kết hợp giữa THA và biến cố tim mạch có khác nhau giữa nam và nữ không?” có hai câu trả lời: “không” trên thang tương đối, “có” trên thang tuyệt đối; câu trả lời tùy vào thang đo. Chủ đề này có tên là thay đổi tác động (effect-measure modification), và sẽ được trình bày đầy đủ ở Chương 8.
Thang tương đối hợp với câu hỏi nguyên nhân: phơi nhiễm này kết hợp mạnh đến mức nào? Trong đoàn hệ này, tỷ số gần như giữ nguyên giữa hai giới dù nguy cơ nền khác nhau; nhưng không có quy luật nào bảo đảm tỷ số luôn ổn định hơn hiệu khi chuyển sang một quần thể khác (Chương 8).
Thang tuyệt đối hợp với câu hỏi quyết định: bao nhiêu ca sẽ tránh được, cần bao nhiêu giường bệnh, nên ưu tiên ai. Nói với bệnh nhân thì câu “thêm 96 ca trên 1.000 người trong 10 năm” dễ hình dung và ít gây hoảng hơn câu “gấp 2,8 lần”.
Tỷ số lớn trên một nền rất thấp có thể chỉ là vài ca, còn tỷ số khiêm tốn trên một nền cao có thể là rất nhiều ca. Vì thế báo cáo tốt nhất thường đưa cả ba thứ: nguy cơ của từng nhóm, tỷ số và hiệu.
Ghi nhớ
Tỷ số (RR, IRR, OR, PR): giá trị không là 1, không có đơn vị, trả lời “gấp bao nhiêu lần”. Hiệu (RD, IRD): giá trị không là 0, mang đơn vị và khoảng thời gian, trả lời “thêm bao nhiêu ca”. Luôn báo cáo nguy cơ của từng nhóm, để người đọc tự đi từ thang này sang thang kia.
3.6 Phân số quy thuộc
3.6.1 Ở nhóm phơi nhiễm
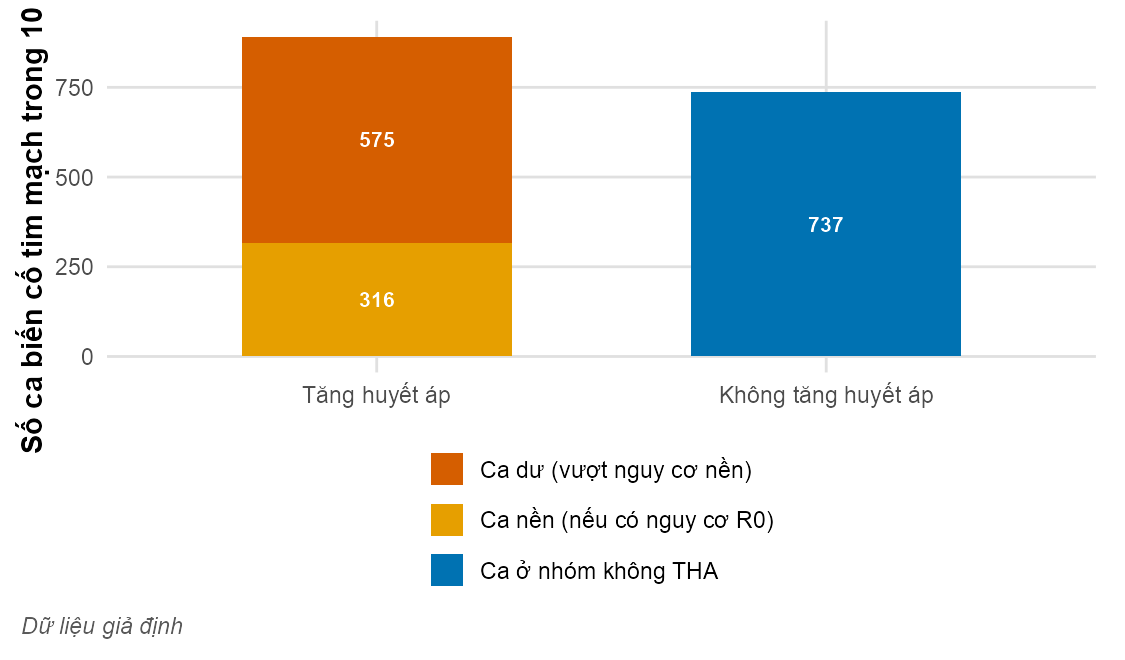
Hãy quay lại câu trả lời thứ ba của bác sĩ. Trong 6.001 người THA có 891 ca biến cố. Nếu những người này có nguy cơ như nhóm không THA, \(R_0 = 0{,}0526\), thì ta chỉ chờ đợi khoảng 316 ca; phần còn lại, 575 ca, là phần dư vượt quá nguy cơ nền (Hình 3.4).
Xem mã R
hinh_ca_du() +gia_dinh()
Hình 3.4: Số ca biến cố tim mạch trong đoàn hệ (số thô). Ở nhóm tăng huyết áp, phần dưới là số ca chờ đợi nếu nhóm này có nguy cơ của nhóm không tăng huyết áp; phần trên là ca dư. Phân số quy thuộc ở nhóm phơi nhiễm là ca dư chia cho mọi ca ở nhóm tăng huyết áp. Dữ liệu giả định.
Tỷ lệ ca dư trong số ca của nhóm phơi nhiễm là phân số quy thuộc ở nhóm phơi nhiễm (attributable fraction in the exposed, \(\text{AF}_e\)):
Tỷ số nguy cơ; vế phải có được khi chia cả tử và mẫu cho \(R_0\)
Đoán trước khi đọc tiếp · mức vừa. Trong Hình 3.4, ca dư chiếm 65% số ca biến cố ở người THA. Câu nào diễn giải đúng con số 65% ấy?
Vế phải cho thấy \(\text{AF}_e\) chỉ phụ thuộc vào tỷ số nguy cơ (Szklo và Nieto 2014, tr. 85–86; Celentano và Szklo 2019, tr. 260–261). Lấy RR thô 2,82, ta có \(\text{AF}_e = (2{,}82 - 1)/2{,}82 = 0{,}645\), đúng bằng 575/891. Câu diễn giải: 65% số ca biến cố ở người THA là phần vượt quá số ca ta chờ đợi nếu họ có nguy cơ của người không THA.
Câu diễn giải ấy được chọn chữ cẩn thận. Câu ấy nói về số ca dư của cả nhóm, chứ không nói về một người cụ thể; không nói “65% bệnh nhân THA bị biến cố do THA”, càng không nói “xác suất THA đã gây ra biến cố của ông này là 65%”. Hộp dưới đây giải thích vì sao.
Lưu ý: các sách trình bày khác nhau
Một chữ, hai nghĩa; hai phân số, một đo được.Gordis Epidemiology dùng chữ nguy cơ quy thuộc (attributable risk) cho cả lượng nguy cơ lẫn tỷ lệ nguy cơ quy cho phơi nhiễm, và phân biệt hai nghĩa qua công thức đi kèm (Celentano và Szklo 2019, tr. 259–260). Szklo và Nieto tách hai đại lượng: nguy cơ quy thuộc ở nhóm phơi nhiễm là một hiệu, còn phần trăm nguy cơ quy thuộc là hiệu đó chia cho nguy cơ của nhóm phơi nhiễm (Szklo và Nieto 2014, tr. 84–86). Modern Epidemiology còn đi xa hơn. Đại lượng tính được từ dữ liệu là phân số dư (excess fraction), tức phần ca vượt quá mức nền; đại lượng này khác với phân số căn nguyên (etiologic fraction), tức phần ca mà phơi nhiễm là một trong các nguyên nhân. Phân số căn nguyên có thể lớn hơn nhiều, vì phơi nhiễm có thể làm một số ca xảy ra sớm hơn thay vì tạo ra ca mới; và nếu không có thêm giả định mạnh về cơ chế sinh học thì không ước lượng được phân số này từ dữ liệu dịch tễ học (Lash và c.s. 2021, ch 5).
Khác biệt này làm đổi cách đọc kết quả, nhất là trong giám định y khoa hay bồi thường, những lúc người ta muốn biết xác suất phơi nhiễm đã gây bệnh cho một người. Sách theo Modern Epidemiology, cuốn sách dẫn đầu về định nghĩa: \(\text{AF}_e\) và PAF trong chương này là phân số dư, không được đọc như xác suất một ca cụ thể do phơi nhiễm gây ra. Sách tránh dùng “nguy cơ quy thuộc” làm thuật ngữ chính; khi gặp chữ này trong tài liệu khác, hãy xem công thức đi kèm là một hiệu hay một phân số. Bảng đối chiếu ký hiệu của các sách nằm ở Mục B.10.
3.6.2 Trong toàn quần thể
Người làm y tế công cộng hỏi một câu rộng hơn: trong mọi ca biến cố của quần thể, kể cả ca ở người không THA, bao nhiêu phần là phần dư gắn với THA? Câu trả lời là phân số quy thuộc quần thể (population attributable fraction, PAF), một đại lượng có một định nghĩa và hai công thức tính hay dùng:
\[
\text{PAF} = \frac{R - R_0}{R}
= \underbrace{\frac{p_X(\text{RR} - 1)}{1 + p_X(\text{RR} - 1)}}_{\text{công thức Levin}}
= \underbrace{p_{X \mid \text{ca}} \, \frac{\text{RR} - 1}{\text{RR}}}_{\text{dựa trên ca bệnh}}
\tag{3.7}\]
Nguy cơ của toàn quần thể (cả người phơi nhiễm và không phơi nhiễm)
\(R_0\)
“R không”
Nguy cơ ở nhóm không phơi nhiễm
\(p_X\)
“p ích”
Tỷ lệ phơi nhiễm trong quần thể, \(n_1/n\)
\(p_{X \mid \text{ca}}\)
“p ích trong số ca”
Tỷ lệ phơi nhiễm trong số ca bệnh, \(a/m_1\)
\(\text{RR}\)
“R R”
Tỷ số nguy cơ
Định nghĩa ở vế trái đọc giống \(\text{AF}_e\), chỉ thay nguy cơ của nhóm phơi nhiễm bằng nguy cơ của cả quần thể. Công thức thứ hai mang tên công thức Levin (Levin’s formula), dùng tỷ lệ phơi nhiễm trong quần thể và tỷ số nguy cơ (Szklo và Nieto 2014, tr. 87–89; Celentano và Szklo 2019, tr. 262, 268). Công thức thứ ba dùng tỷ lệ phơi nhiễm trong số ca bệnh và có một cách đọc rất tự nhiên: PAF bằng phần ca thuộc nhóm phơi nhiễm nhân với phần ca dư trong nhóm ấy, \(p_{X \mid \text{ca}} \times \text{AF}_e\)(Lash và c.s. 2021, ch 18).
Với số thô của đoàn hệ, \(R = 0{,}0814\) và \(R_0 = 0{,}0526\), nên PAF \(=\) 0,353, cũng chính là 575 ca dư chia cho 1.628 ca của cả đoàn hệ trong Hình 3.4. Công thức Levin, dùng \(p_X = 0{,}300\) và RR thô, cho đúng con số đó; công thức dựa trên ca bệnh, dùng \(p_{X \mid \text{ca}} = 0{,}547\), cũng vậy. Với số thô, ba cách viết thực ra là một, chỉ khác nhau ở phép biến đổi đại số.
PAF tùy vào hai thứ: kết hợp mạnh đến đâu (RR) và phơi nhiễm phổ biến đến đâu (\(p_X\)). Phơi nhiễm hiếm mà RR rất lớn vẫn có thể có PAF nhỏ, còn phơi nhiễm phổ biến mà RR vừa phải, như THA, lại có thể có PAF lớn. Vì thế số đo của nguyên nhân (RR) và số đo của gánh nặng (PAF) có thể xếp hạng các yếu tố nguy cơ rất khác nhau.
3.6.3 Ví dụ: khi có nhiễu, công thức Levin sai
Mọi con số ở trên đều là số thô, mà số thô ở đây bị tuổi gây nhiễu. Hai điều cùng đúng một lúc: THA phổ biến hơn ở người lớn tuổi (15% ở nhóm 40–54 tuổi, 55% ở nhóm 65–74 tuổi), và người lớn tuổi có nguy cơ biến cố cao hơn ngay cả khi không THA (3,4% so với 10,0%). Vì vậy người THA già hơn người không THA, và một phần khoảng cách thô giữa hai nhóm chỉ là khoảng cách tuổi. Đó chính là cơ chế bạn đã gặp ở hai tỉnh Lục Vân và Bạch Hải trong Chương 2.
Trong từng nhóm tuổi, RR chỉ dao động từ 1,94 đến 2,17. Gộp các nhóm tuổi bằng phương pháp Mantel–Haenszel, ta được RR hiệu chỉnh theo tuổi bằng 2,05 (KTC 95%: 1,85–2,26), thấp hơn hẳn RR thô 2,82. Cách tính ước lượng gộp này xin dành cho Chương 7; ở đây ta chỉ dùng kết quả.
Vì dữ liệu là mô phỏng, ta biết được điều mà nghiên cứu thật không bao giờ biết: số ca biến cố sẽ xảy ra trong chính đoàn hệ này nếu không ai bị THA. Theo bộ doan_he_tiem_nang, con số đó là 1.199, trong khi số ca thật sự xảy ra là 1.628, nên PAF “thật” của mô phỏng là 0,264. Ý nghĩa đầy đủ của những con số “nếu như” này xin dành cho Chương 6.
Đoán trước khi đọc tiếp · mức khó. RR hiệu chỉnh theo tuổi là 2,05, thấp hơn RR thô 2,82, còn PAF thật của mô phỏng là 0,264. Nếu thay RR thô bằng RR hiệu chỉnh trong công thức Levin, kết quả sẽ thế nào so với PAF thật?
Giờ ta thử cả bốn tổ hợp: hai công thức, mỗi công thức dùng RR thô hoặc RR hiệu chỉnh (Bảng 3.4).
Xem mã R
bang <- paf_bang |>transmute(`Công thức`= cong_thuc, `Tỷ số nguy cơ dùng`=paste0(rr_dung, " (", so(rr_gt, 2), ")"),`Tỷ lệ phơi nhiễm dùng`=ifelse(ty_le =="p_X", paste0("Trong quần thể (", so(p_X, 3), ")"),paste0("Trong số ca (", so(p_X_ca, 3), ")")),PAF =so(paf, 3), `Chênh so với giá trị thật`=so(paf - paf_that, 3))knitr::kable(bang, align ="lllrr")
Bảng 3.4: Bốn cách tính phân số quy thuộc quần thể của tăng huyết áp trong đoàn hệ, so với giá trị thật của mô phỏng. Dữ liệu giả định.
Công thức
Tỷ số nguy cơ dùng
Tỷ lệ phơi nhiễm dùng
PAF
Chênh so với giá trị thật
Levin
RR thô (2,82)
Trong quần thể (0,300)
0,353
0,090
Levin
RR hiệu chỉnh theo tuổi (2,05)
Trong quần thể (0,300)
0,239
−0,025
Dựa trên ca bệnh
RR thô (2,82)
Trong số ca (0,547)
0,353
0,090
Dựa trên ca bệnh
RR hiệu chỉnh theo tuổi (2,05)
Trong số ca (0,547)
0,280
0,016
Giá trị thật của mô phỏng là 0,264. Từ bảng, ta rút ra ba điều.
Thứ nhất, hai dòng dùng RR thô cho cùng một con số, 0,353, cao hơn hẳn sự thật. Đó là PAF thô, quy cho THA cả phần khoảng cách vốn do tuổi.
Thứ hai, phản xạ tự nhiên là “sửa” bằng cách đưa RR hiệu chỉnh vào công thức Levin, và kết quả là 0,239: lần này lại thấp hơn sự thật. Công thức Levin dựa trên đẳng thức \(R = p_X R_1 + (1 - p_X) R_0\) trong đó \(R_1 = \text{RR} \times R_0\), mà đẳng thức đó chỉ đúng với RR thô. Thay RR hiệu chỉnh vào là ta ngầm giả định người THA có nguy cơ nền như người không THA, trong khi thực tế họ già hơn và có nguy cơ nền cao hơn (Szklo và Nieto 2014, tr. 89–90; Celentano và Szklo 2019, tr. 262).
Thứ ba, công thức dựa trên ca bệnh dùng RR hiệu chỉnh cho 0,280, gần sự thật nhất. Lý do nằm ở cách đọc \(p_{X \mid \text{ca}} \times \text{AF}_e\). Tỷ lệ phơi nhiễm trong số ca là con số quan sát được, không bị nhiễu làm sai; còn \(\text{AF}_e\) chỉ cần một RR so sánh người THA với người không THA cùng tuổi, đúng thứ mà RR hiệu chỉnh cung cấp (Lash và c.s. 2021, ch 18). Phần chênh nhỏ còn lại so với sự thật là do sai số ngẫu nhiên của một mẫu hữu hạn (Chương 5).
Ghi nhớ
Khi có nhiễu, tính PAF bằng công thức dựa trên ca bệnh với RR đã hiệu chỉnh: \(\text{PAF} = p_{X \mid \text{ca}}(\text{RR} - 1)/\text{RR}\). Công thức Levin chỉ dùng cho số thô, khi không có nhiễu.
Bài học ấy cũng đúng với \(\text{AF}_e\). Với RR thô, \(\text{AF}_e\) là 0,645; với RR hiệu chỉnh, 0,511; còn giá trị thật của mô phỏng là 0,481. Câu trả lời thứ ba của bác sĩ ở đầu chương, 65%, phóng đại vì dùng số thô.
Đi sâu hơn
PAF trả lời một câu hỏi “nếu như”. PAF đọc như phần ca tránh được nếu loại bỏ phơi nhiễm khỏi quần thể mà không thay đổi gì khác. Với THA, “loại bỏ” không phải là một can thiệp duy nhất. Hạ huyết áp bằng thuốc, bằng giảm muối hay bằng giảm cân có thể đem lại những lợi ích khác nhau, và không can thiệp nào đưa được người THA về đúng tình trạng của người chưa từng THA, bởi người đã THA nhiều năm có thể đã có tổn thương mạch máu không hồi phục. Câu hỏi “can thiệp nào, cho ai” gắn với điều kiện nhất quán ở Chương 6.
Trên thực tế, chương trình y tế công cộng hiếm khi xóa hẳn một phơi nhiễm, mà thường chỉ giảm tỷ lệ phơi nhiễm, chẳng hạn đưa một phần người THA về huyết áp bình thường. Modern Epidemiology gọi phần ca tránh được trong kịch bản giảm một phần ấy là impact fraction; con số này nhỏ hơn PAF, và PAF là trường hợp riêng khi phơi nhiễm bị xóa hoàn toàn (Lash và c.s. 2021, ch 5). Cuối cùng, PAF của nhiều yếu tố nguy cơ không cộng lại thành 100%. Một ca có thể phải có đồng thời THA và hút thuốc mới xảy ra; loại bỏ một trong hai yếu tố đã đủ tránh được ca ấy, nên ca ấy được tính vào PAF của cả hai.
3.7 Từ thử nghiệm đến quyết định lâm sàng: số người cần điều trị
3.7.1 Một con số cho người thầy thuốc
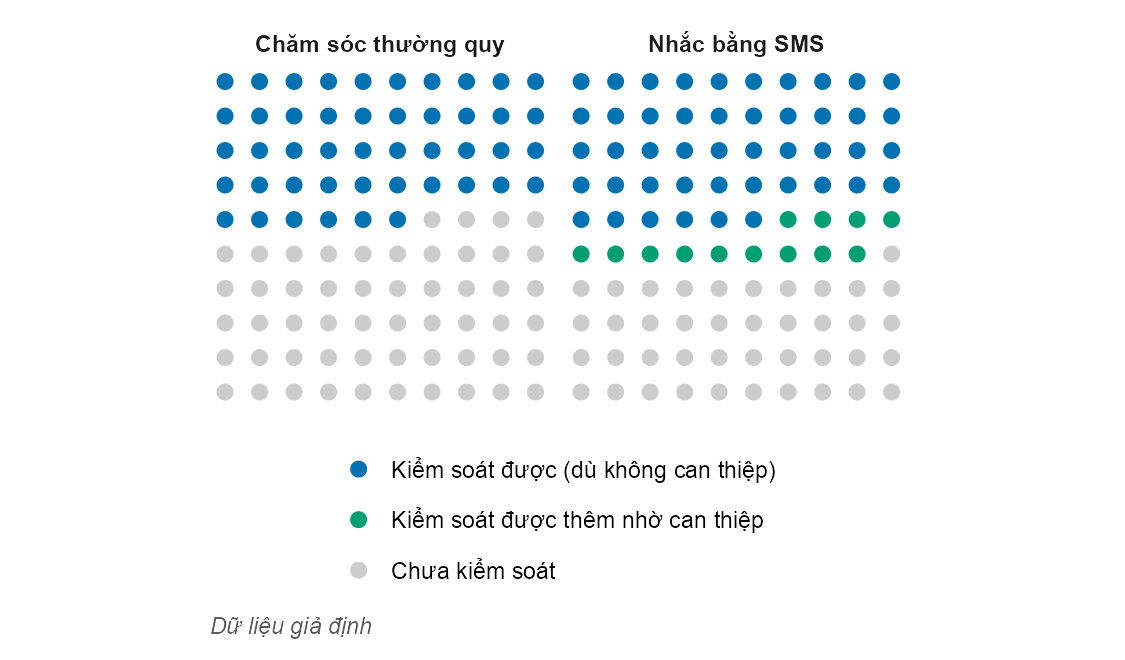
Năm 2023, ở tỉnh Lục Vân, một thử nghiệm ngẫu nhiên có đối chứng (randomized controlled trial, RCT) tuyển 600 người THA chưa kiểm soát, tức huyết áp vẫn cao dù đang được trạm y tế xã quản lý. Người tham gia được chia ngẫu nhiên, như bốc thăm, vào hai nhánh: 300 người được chăm sóc thường quy, 300 người còn lại được nhắc bằng tin nhắn SMS và được nhân viên y tế xã gọi điện hằng tháng. Kết cục chính là huyết áp tâm thu dưới 140 mmHg ở tháng thứ 12. Thiết kế thử nghiệm xin dành cho Mục 4.4, chi tiết bộ dữ liệu ở Mục C.3.15.
Có 46 người mất theo dõi trước tháng 12; trong dữ liệu giả định, ai mất theo dõi là do tình cờ, không liên quan đến nhánh hay huyết áp. Ở đây ta chỉ phân tích 554 người còn được theo dõi, còn chuyện mất theo dõi xin để dành cho Chương 9.
Tỷ lệ kiểm soát được huyết áp là 59,3% ở nhóm nhắc SMS và 46,2% ở nhóm chăm sóc thường quy. Tỷ số nguy cơ, ở đây là tỷ số của hai tỷ lệ kiểm soát, bằng 1,28 (KTC 95%: 1,09–1,50), còn hiệu nguy cơ là 0,130 (KTC 95%: 0,048–0,213).
Đoán trước khi đọc tiếp · mức dễ. Hiệu nguy cơ ấy nghĩa là cứ 100 người được nhắc SMS thì có thêm khoảng 13 người kiểm soát được huyết áp, so với chăm sóc thường quy. Vậy phải nhắc SMS cho khoảng bao nhiêu người thì có thêm một người kiểm soát được huyết áp?
Bác sĩ ở trạm y tế xã muốn một con số dễ dùng hơn: phải áp dụng can thiệp cho bao nhiêu người để có thêm một người kiểm soát được huyết áp? Con số ấy là số người cần điều trị (number needed to treat, NNT):
Số người cần điều trị để có thêm (hoặc tránh) một kết cục
\(\lvert \text{RD} \rvert\)
“giá trị tuyệt đối của R D”
Độ lớn của hiệu nguy cơ, bỏ dấu
\(R_1\), \(R_0\)
“R một”, “R không”
Tỷ lệ có kết cục ở nhóm can thiệp, nhóm chứng, trong cùng một khoảng thời gian
NNT là nghịch đảo của hiệu nguy cơ nên mang theo mọi điều kiện của hiệu nguy cơ: một kết cục cụ thể và một khoảng thời gian cụ thể (Lash và c.s. 2021, ch 35). Trong thử nghiệm SMS, \(\text{NNT} = 1/0{,}130 = 7{,}7\), làm tròn lên thành 8. Câu diễn giải: cần áp dụng can thiệp nhắc SMS cho khoảng 8 người THA chưa kiểm soát để có thêm một người kiểm soát được huyết áp sau 12 tháng (Hình 3.5).
Xem mã R
hinh_nnt() +gia_dinh()
Hình 3.5: Kết quả của thử nghiệm SMS, quy về 100 người mỗi nhánh. Chấm xanh dương: người kiểm soát được huyết áp dù không can thiệp; chấm xanh lá: người kiểm soát được thêm nhờ can thiệp; chấm xám: chưa kiểm soát. Dữ liệu giả định.
Quy về 100 người mỗi nhánh thì ở nhánh chứng có 46 người kiểm soát được huyết áp, ở nhánh SMS có 59 người. Phần chênh, 13 người trên 100, chính là hiệu nguy cơ. Cứ khoảng 8 người được can thiệp thì có một chấm xanh lá.
Khi đọc NNT, cần lưu ý ba điều. Thứ nhất, NNT luôn đi cùng khoảng thời gian: NNT sau 12 tháng không phải là NNT sau năm năm. Thứ hai, NNT thừa hưởng độ bất định của hiệu nguy cơ. Lấy nghịch đảo hai đầu KTC của RD, ta được khoảng từ 4,7 đến 20,9 người, rất rộng vì cận dưới của RD gần 0. Khi KTC của RD chứa 0, khoảng của NNT trở nên khó đọc, và nhiều tác giả khuyên báo cáo RD kèm KTC thay vì NNT. Thứ ba, khi kết cục là một tác hại, chính phép tính ấy cho biết phải điều trị bao nhiêu người thì có thêm một người bị hại; sách tiếng Anh gọi con số này là number needed to harm.
3.7.2 Hiệu lực vắc xin là một phân số quy thuộc
Trong thử nghiệm vắc xin, người ta báo cáo hiệu lực vắc xin (vaccine efficacy): tỷ lệ giảm nguy cơ ở nhóm tiêm so với nhóm không tiêm. Coi nhóm “không tiêm” là nhóm phơi nhiễm thì hiệu lực vắc xin chính là \(\text{AF}_e\) của việc không tiêm (Szklo và Nieto 2014, tr. 86–87):
Nguy cơ mắc bệnh ở nhóm không tiêm (nhóm giả dược)
\(R_{\text{tiêm}}\)
“R tiêm”
Nguy cơ mắc bệnh ở nhóm tiêm vắc xin
\(R_{\text{tiêm}}/R_{\text{không tiêm}}\)
“R tiêm chia R không tiêm”
Tỷ số nguy cơ, nhỏ hơn 1 khi vắc xin bảo vệ
Vậy hiệu lực vắc xin là một phân số dư: phần ca ở nhóm không tiêm vượt quá mức ta thấy ở nhóm tiêm, và mọi điều đã nói về \(\text{AF}_e\) đều đúng với nó. Đại lượng này dựa trên tỷ số nguy cơ, nên không cho biết bao nhiêu ca tránh được trong quần thể; muốn biết con số đó, cần thêm nguy cơ nền và tỷ lệ bao phủ.
Các KTC 95% trong chương này đều tính bằng các hàm trong R/epi.R. Cách dựng các khoảng ấy, và vì sao khoảng của NNT lại khó đọc như vậy, xin dành cho Chương 5.
3.8 Giới hạn của các số đo
Các số đo trong chương này là công cụ tóm tắt, và công cụ nào cũng có phạm vi của nó.
Chúng mô tả kết hợp, không chứng minh tác động. RR thô 2,82 là một sự thật về đoàn hệ này, nhưng không phải là tác động của THA: ví dụ PAF đã cho thấy riêng nhiễu do tuổi đã đẩy RR từ khoảng 2,0 lên 2,8. Muốn đọc một số đo như một tác động, ta cần các điều kiện ở Chương 6 và cách kiểm soát nhiễu ở Chương 7.
Một số đo tóm tắt có thể che giấu khác biệt giữa các tầng. RR chung cho cả đoàn hệ là một trung bình. Nếu RR khác nhau giữa các nhóm, hoặc RR như nhau nhưng RD khác nhau như giữa hai giới, thì một con số không kể hết được câu chuyện. Hãy xem số đo theo tầng trước khi tóm tắt.
Thiết kế quyết định số đo nào tính được. Đoàn hệ cho mọi số đo, nghiên cứu cắt ngang chỉ cho số đo hiện mắc, còn nghiên cứu bệnh–chứng không cho nguy cơ của từng nhóm nên không cho trực tiếp RR hay RD. Bảng tóm tắt ở cuối chương sẽ có thêm cột “thiết kế” khi đến Chương 4.
Mỗi số đo cần kèm đủ ngữ cảnh. Người đọc cần biết kết cục nào, trong bao lâu, so với nhóm nào, ở quần thể nào. NNT không có khoảng thời gian, RD không có đơn vị, hay RR không có nhóm so sánh đều là những con số không đọc được.
Hiểu lầm thường gặp
“RR bằng 2 nghĩa là nguy cơ tăng 200%.” RR bằng 2 nghĩa là nguy cơ tăng lên 2 lần, tức tăng thêm 100%. Phần trăm tăng thêm là \((\text{RR} - 1) \times 100\%\). Với RR thô của đoàn hệ, 2,82, nguy cơ cao hơn 182%.
“RR lớn thì vấn đề y tế công cộng lớn.” Gánh nặng trong quần thể tùy vào hiệu nguy cơ và vào mức độ phổ biến của phơi nhiễm, thể hiện qua PAF. Phơi nhiễm hiếm mà RR rất lớn có thể chỉ gây vài ca, còn THA, có ở 30% đoàn hệ, lại có PAF lớn dù RR hiệu chỉnh chỉ khoảng 2,0.
“Muốn PAF hiệu chỉnh, chỉ cần đưa RR hiệu chỉnh vào công thức Levin.” Không. Công thức Levin chỉ đúng với RR thô; dùng RR hiệu chỉnh, công thức này cho 0,239, thấp hơn giá trị thật 0,264. Hãy dùng công thức dựa trên ca bệnh, \(p_{X \mid \text{ca}}(\text{RR} - 1)/\text{RR}\), với RR hiệu chỉnh.
“PAF của THA là 28%, vậy 28% ca biến cố do riêng THA gây ra, phần còn lại do các yếu tố khác.” PAF là phân số dư của một yếu tố, chứ không phải một miếng của chiếc bánh chia đều. Nhiều ca cần nhiều yếu tố cùng lúc mới xảy ra, nên PAF của THA, hút thuốc và rượu có thể cộng lại vượt 100%. Mô hình nguyên nhân đủ và nguyên nhân thành phần ở Chương 6 sẽ cho thấy lý do.
“Tỷ số và hiệu phải cùng nói ‘có’ hoặc cùng nói ‘không’ khác biệt giữa các nhóm.” Ở hai giới, RR gần như bằng nhau, vậy mà RD của nam gấp 2,1 lần của nữ. Khi nguy cơ nền khác nhau mà tỷ số đều nhau thì hiệu không thể đều nhau, và ngược lại.
“NNT không cần ghi thời gian.” NNT là nghịch đảo của hiệu nguy cơ, và hiệu nguy cơ luôn gắn với một khoảng thời gian. Can thiệp SMS có NNT khoảng 8 sau 12 tháng; con số sau năm năm có thể rất khác.
Tự kiểm tra
Một nghiên cứu báo cáo RR bằng 2 cho một phơi nhiễm. Câu nào diễn giải đúng?
RR là thương của hai nguy cơ, nên phần trăm tăng thêm là \((\text{RR} - 1) \times 100\%\)\(=\) 100%. Phương án thứ ba nhầm tỷ số với hiệu: muốn biết thêm bao nhiêu ca thì phải có nguy cơ nền. Phương án cuối nhầm RR với PAF, đại lượng còn tùy vào tỷ lệ phơi nhiễm.
Từ Bảng 3.2, tính tỷ số chênh của biến cố tim mạch giữa người THA và người không THA (hai chữ số thập phân).
\(\text{OR} = ad/bc = (891 \times 13.262)/(5.110 \times 737) = 3{,}14\). Con số này lớn hơn RR 2,82 vì nguy cơ ở người THA, 14,8%, không nhỏ: hệ số sửa \((1 - R_0)/(1 - R_1)\) bằng 1,113.
Trong một quần thể, 10% người có một phơi nhiễm, và RR (không bị nhiễu) là 3. Tính PAF bằng công thức Levin, hai chữ số thập phân.
\(\text{PAF} = p_X(\text{RR} - 1)/[1 + p_X(\text{RR} - 1)] = 0{,}10 \times 2/(1 + 0{,}20) = 0{,}167\). Dù RR khá lớn, PAF chỉ khoảng 17% vì phơi nhiễm không phổ biến. Công thức Levin dùng được ở đây vì đề bài cho biết RR không bị nhiễu.
Một thuốc làm giảm nguy cơ đột quỵ trong 5 năm từ 6% xuống 4%. Tính NNT (số nguyên).
\(\text{RD} = 0{,}04 - 0{,}06 = -0{,}02\), nên \(\text{NNT} = 1/0{,}02 = 50\). Diễn giải: cần điều trị 50 người trong 5 năm để tránh một ca đột quỵ. Tỷ số nguy cơ ở đây là 0,67, tức nguy cơ giảm tương đối 33%: con số này nghe ấn tượng hơn nhiều so với NNT.
Hai quần thể có cùng RR bằng 2 giữa hút thuốc và một bệnh, nhưng nguy cơ nền ở người không hút thuốc, tính trong cùng một khoảng thời gian, là 1% ở quần thể A và 10% ở quần thể B. Nếu một chương trình cai thuốc thành công như nhau ở hai nơi, và người bỏ thuốc trở về đúng nguy cơ của người không hút, thì ở đâu chương trình tránh được nhiều ca hơn trên 1.000 người hút thuốc?
Hiệu nguy cơ là \(R_0(\text{RR} - 1)\): 10 ca trên 1.000 người hút thuốc ở A và 100 ca ở B. Cùng một tỷ số, đặt trên một nền cao hơn, thì cho một hiệu lớn hơn, như ví dụ hai giới ở Mục 3.5.
Một khảo sát cắt ngang cho tỷ lệ hiện mắc 0,30 ở nhóm phơi nhiễm và 0,10 ở nhóm không phơi nhiễm. Tính POR (hai chữ số thập phân).
\(\text{POR} = (0{,}30/0{,}70)/(0{,}10/0{,}90) = 3{,}86\), trong khi \(\text{PR} = 3{,}00\). POR xa 1 hơn PR vì tỷ lệ hiện mắc ở nhóm phơi nhiễm không thấp.
Một báo cáo ước tính PAF của THA, hút thuốc và đái tháo đường đối với biến cố tim mạch, và tổng ba con số vượt quá 100%. Báo cáo có sai không? Giải thích trong một hoặc hai câu.
Không nhất thiết sai. Nhiều ca chỉ xảy ra khi có đồng thời nhiều yếu tố, và loại bỏ bất kỳ yếu tố nào trong số đó cũng tránh được ca ấy; vì vậy ca ấy được tính vào PAF của mọi yếu tố liên quan. PAF là phân số dư của từng yếu tố, chứ không phải các phần của một tổng cố định.
Đúng hay sai: “Trong đoàn hệ tim mạch, IRR là 3,08 còn RR là 2,82; vậy một trong hai con số đã bị tính sai.”
Sai: đó là hai số đo khác nhau. Người THA bị biến cố nhiều hơn nên rời nhóm có nguy cơ sớm hơn và đóng góp ít người-năm hơn; mẫu số của tỷ suất ở nhóm này co lại nhiều hơn, nên IRR xa 1 hơn RR khi kết cục không hiếm.
Thực hành R
Phần này hướng dẫn làm lại các phép tính của chương bằng R, với vài dòng mã bạn có thể chép về dùng. Hai hàm two_by_two() và mh_rr() nằm trong tệp R/epi.R của kho mã, còn mã vẽ các hình của chương nằm trong R/ch03.R. Có thể tải trực tiếp các tệp dữ liệu tại https://youcan-e64.pages.dev/nckh/data/doan_he_tim_mach.csv và https://youcan-e64.pages.dev/nckh/data/thu_nghiem_sms.csv.
Bảng 2×2 và một hàm nhỏ cho bốn số đo
Đọc dữ liệu rồi lập bảng 2×2, hàng là THA, cột là biến cố, đặt mức 1 lên trước cho đúng bố cục của sách. Hãy kiểm tra xem ô trên cùng bên trái có đúng là 891 không.
IRR là 3,08, xa 1 hơn RR 2,82; IRD là 11,8 ca trên 1.000 người-năm.
Tỷ số và hiệu theo giới, chuẩn hóa theo tuổi
Chuẩn hóa trực tiếp nguy cơ của từng nhóm giới × THA theo cơ cấu tuổi của cả đoàn hệ, như ở Mục 2.3, rồi tính RR và RD cho từng giới.
Xem mã R
w <-prop.table(table(tm$nhom_tuoi)) # dân số chuẩn: cơ cấu tuổi của cả đoàn hệtm |>group_by(gioi, tha, nhom_tuoi) |>summarise(nguy_co =mean(bien_co_tm), .groups ="drop") |>group_by(gioi, tha) |>summarise(nguy_co_chuan =sum(as.numeric(w[nhom_tuoi]) * nguy_co), .groups ="drop") |>pivot_wider(names_from = tha, values_from = nguy_co_chuan, names_prefix ="R") |>mutate(RR = R1 / R0, RD_tren_1000 = (R1 - R0) *1000)
# A tibble: 2 × 5
  gioi      R0     R1    RR RD_tren_1000
  <chr>  <dbl>  <dbl> <dbl>        <dbl>
1 nam   0.0820 0.165   2.01         83.1
2 nu    0.0362 0.0750  2.07         38.8
RR gần như bằng nhau ở hai giới (2,07 và 2,01), trong khi hiệu nguy cơ là 39 và 83 ca trên 1.000 người. Hàm hinh_thang_gioi() trong R/ch03.R vẽ Hình 3.3 từ đúng các con số này.
Phân số quy thuộc quần thể, bốn cách
Ta cần các thành phần: nguy cơ chung, nguy cơ ở nhóm không THA, hai tỷ lệ phơi nhiễm và hai RR. RR hiệu chỉnh theo tuổi lấy từ hàm mh_rr(), giải thích ở Chương 7.
Kết quả khớp với Bảng 3.4: công thức Levin với RR hiệu chỉnh cho 0,239, công thức dựa trên ca bệnh với RR hiệu chỉnh cho 0,280. Hàm mh_rr() tự đổi các ô sang số thực, nên số đếm lớn không làm tràn số.
Thử nghiệm SMS: RD, RR và NNT
Giữ lại những người còn được theo dõi ở tháng 12, rồi lập bảng 2×2, hàng là nhánh (can thiệp trước), cột là kiểm soát huyết áp (có trước).
RD là 0,130 và NNT là 7,7, làm tròn lên thành 8 người.
Tóm tắt và đọc thêm
Bảng 2×2 xếp phơi nhiễm theo hàng và kết cục theo cột. Mọi số đo của chương đều tính từ bốn ô \(a, b, c, d\), hoặc từ số ca và người-thời gian.
Tỷ số (RR, IRR, OR, PR, POR) trả lời “gấp bao nhiêu lần” và có giá trị không là 1. Trong đoàn hệ Bạch Hải, RR thô là 2,82 (KTC 95%: 2,57–3,09). IRR xa 1 hơn RR khi kết cục không hiếm, vì nhóm phơi nhiễm đóng góp ít người-thời gian hơn.
Tỷ số chênh bằng RR nhân với hệ số \((1 - R_0)/(1 - R_1)\), nên chỉ xấp xỉ RR khi bệnh hiếm ở cả hai nhóm. Tỷ số chênh còn đối xứng: tỷ số chênh của phơi nhiễm bằng tỷ số chênh của bệnh, và nghiên cứu bệnh–chứng khai thác chính tính chất này.
Hiệu (RD, IRD) trả lời “thêm bao nhiêu ca”, có giá trị không là 0 và luôn kèm đơn vị cùng khoảng thời gian. Cùng một tỷ số có thể đi với những hiệu rất khác nhau khi nguy cơ nền khác nhau, như giữa nam và nữ.
\(\text{AF}_e\) và PAF là phân số dư, không phải xác suất một ca cụ thể do phơi nhiễm gây ra. Khi có nhiễu, tính PAF bằng công thức dựa trên ca bệnh với RR hiệu chỉnh, không bằng công thức Levin.
NNT là nghịch đảo của hiệu nguy cơ, nên luôn kèm kết cục và khoảng thời gian. Hiệu lực vắc xin là \(\text{AF}_e\) của việc không tiêm.
Bảng 3.5: Các số đo kết hợp và tác động của chương: công thức, giá trị không, miền giá trị và đơn vị.
Số đo
Công thức
Giá trị không
Miền giá trị
Đơn vị
Tỷ số nguy cơ (RR)
\(R_1/R_0\)
1
0 đến \(\infty\)
Không có
Tỷ số tỷ suất (IRR)
\(I_1/I_0\)
1
0 đến \(\infty\)
Không có
Tỷ số chênh (OR)
\(ad/bc\)
1
0 đến \(\infty\)
Không có
Tỷ số hiện mắc (PR)
\(P_1/P_0\)
1
0 đến \(\infty\)
Không có
Hiệu nguy cơ (RD)
\(R_1 - R_0\)
0
\(-1\) đến \(1\)
Tỷ lệ trong một khoảng thời gian
Hiệu tỷ suất (IRD)
\(I_1 - I_0\)
0
\(-\infty\) đến \(\infty\)
Ca trên người-thời gian
Phân số quy thuộc ở nhóm phơi nhiễm (\(\text{AF}_e\))
\((\text{RR} - 1)/\text{RR}\)
0
dưới 1
Không có
Phân số quy thuộc quần thể (PAF)
\(p_{X \mid \text{ca}}(\text{RR} - 1)/\text{RR}\)
0
dưới 1
Không có
Số người cần điều trị (NNT)
\(1/\lvert \text{RD} \rvert\)
\(\infty\) (khi RD = 0)
từ 1 trở lên
Người, trong một khoảng thời gian
Đọc thêm.
Szklo và Nieto trình bày các số đo kết hợp trong đoàn hệ, quan hệ giữa OR và RR, phân số quy thuộc và công thức Levin, với nhiều ví dụ tính tay (Szklo và Nieto 2014, tr. 79–93).
Gordis Epidemiology có hai chương ngắn viết cho người đọc lâm sàng, bàn về tỷ số nguy cơ, tỷ số chênh và nguy cơ quy thuộc (Celentano và Szklo 2019, tr. 242–268).
Modern Epidemiology phân biệt số đo tác động với số đo kết hợp, phân số dư với phân số căn nguyên, và cho cách ước lượng phân số quy thuộc khi có phân tầng (Lash và c.s. 2021, ch 5 và 18).
Celentano, David D., và Moyses Szklo. 2019. Gordis Epidemiology. 6th ab. Philadelphia, PA: Elsevier.
Lash, Timothy L., Tyler J. VanderWeele, Sebastien Haneuse, và Kenneth J. Rothman. 2021. Modern Epidemiology. 4th ab. Philadelphia, PA: Wolters Kluwer.
Szklo, Moyses, và F. Javier Nieto. 2014. Epidemiology: Beyond the Basics. 3rd ab. Burlington, MA: Jones & Bartlett Learning.