Theo dữ liệu giả định năm 2024, tỉnh Bạch Hải có tỷ suất tử vong thô cao hơn tỉnh Lục Vân. Thế nhưng tách theo nhóm tuổi thì ở mọi nhóm tuổi, người Lục Vân lại tử vong nhiều hơn. Vậy tỉnh nào “khỏe” hơn, và phải so sánh hai tỉnh thế nào cho công bằng?
Chương này trả lời câu hỏi ấy bằng một kỹ thuật đã cũ nhưng vẫn còn nguyên giá trị: chuẩn hóa (standardization). Học xong chương này, bạn có thể:
giải thích vì sao tỷ suất thô là trung bình có trọng số của các tỷ suất đặc hiệu, và vì sao điều đó làm phép so sánh thô sai lệch khi cơ cấu tuổi khác nhau;
tính tỷ suất chuẩn hóa trực tiếp, tỷ số và hiệu tỷ suất chuẩn hóa, rồi diễn giải cho đúng: “nếu hai tỉnh có cùng cơ cấu tuổi như dân số chuẩn”;
dùng chuẩn hóa gián tiếp để tính và diễn giải tỷ số tử vong chuẩn hóa (SMR);
biết khi nào dùng chuẩn hóa trực tiếp, khi nào dùng gián tiếp, chọn dân số chuẩn ra sao, và nhận ra lúc nào lựa chọn ấy làm đổi kết luận;
nêu những điều chuẩn hóa không làm được.
Chương này dùng lại các khái niệm tỷ suất (rate), người-thời gian (person-time), tỷ suất thô (crude rate) và tỷ suất đặc hiệu (specific rate) đã học ở Chương 1, nên sẽ không nhắc lại định nghĩa.
Dữ liệu giả định
Mọi số liệu trong chương này đều là dữ liệu giả định, mô phỏng từ mô hình có hạt giống ngẫu nhiên cố định, và không phản ánh địa phương hay cơ sở y tế có thật nào. Chương dùng bốn bộ dữ liệu: hai_tinh (tử vong và đái tháo đường ở tỉnh Lục Vân và tỉnh Bạch Hải, Mục C.3.1), dan_so_chuan (ba dân số chuẩn, Mục C.3.2), cong_nhan_ng_nam (người-năm theo dõi của công nhân Công ty Khai thác Đá X, Mục C.3.6) và cong_nhan_mo_da (số liệu từng công nhân của chính đoàn hệ ấy, Mục C.3.5).
2.1 Câu đố hai tỉnh
Lục Vân là tỉnh miền núi, dân số trẻ, có 800.000 người. Bạch Hải là tỉnh ven biển, đô thị hóa, dân số già hơn, có 1.200.000 người. Năm 2024, Lục Vân ghi nhận 5.858 ca tử vong do mọi nguyên nhân, Bạch Hải ghi nhận 11.663 ca. Đây chính là hai tỉnh bạn đã gặp ở Mục 1.7 (chi tiết bộ dữ liệu ở Mục C.3.1). Mỗi người sống trọn một năm đóng góp một người-năm (person-years), nên ta dùng dân số giữa năm làm số người-năm.
Tỷ suất tử vong (mortality rate) thô của Bạch Hải là 9,7 trên 1.000 người-năm, của Lục Vân là 7,3. Lấy Bạch Hải chia cho Lục Vân, tỷ số giữa hai tỷ suất thô là 1,33 (KTC 95%: 1,29–1,37). Chỉ nhìn con số này, ta sẽ kết luận người Bạch Hải tử vong nhiều hơn khoảng 33%.
Bảng 2.1 chia chính số ca tử vong ấy theo 6 nhóm tuổi. Ở nhóm tuổi nào, tỷ suất của Bạch Hải cũng thấp hơn Lục Vân: tỷ số Bạch Hải/Lục Vân chỉ dao động từ 0,78 đến 0,84. Nhóm tuổi ít ca nhất cũng có 158 ca tử vong, nên các tỷ số theo tuổi rất ổn định. Vì thế chương chỉ ghi khoảng tin cậy (confidence interval, KTC) cho các số đo tóm tắt; KTC là dải giá trị cho biết con số ước lượng có thể xê dịch bao nhiêu chỉ vì tình cờ, sẽ bàn kỹ ở Chương 5.
Bảng 2.1: Dân số, số tử vong và tỷ suất tử vong (trên 1.000 người-năm) theo nhóm tuổi ở hai tỉnh, năm 2024. Dòng cuối là tỷ suất thô. Dữ liệu giả định.
Nhóm tuổi
Dân số LV
Tử vong LV
Tỷ suất LV
Dân số BH
Tử vong BH
Tỷ suất BH
BH/LV
0–14
208.000
203
1,0
192.000
158
0,8
0,84
15–29
200.000
252
1,3
216.000
213
1,0
0,78
30–44
168.000
413
2,5
252.000
496
2,0
0,80
45–59
120.000
895
7,5
252.000
1.546
6,1
0,82
60–74
72.000
1.655
23,0
192.000
3.425
17,8
0,78
75+
32.000
2.440
76,2
96.000
5.825
60,7
0,80
Chung (thô)
800.000
5.858
7,3
1.200.000
11.663
9,7
1,33
Hai cách nhìn, hai câu trả lời ngược nhau. Trước khi đọc tiếp, bạn hãy tự chọn lấy một.
Đoán trước khi đọc tiếp · mức dễ. Tỉnh nào có điều kiện sống “khỏe” hơn, theo nghĩa người dân ở cùng độ tuổi ít tử vong hơn?
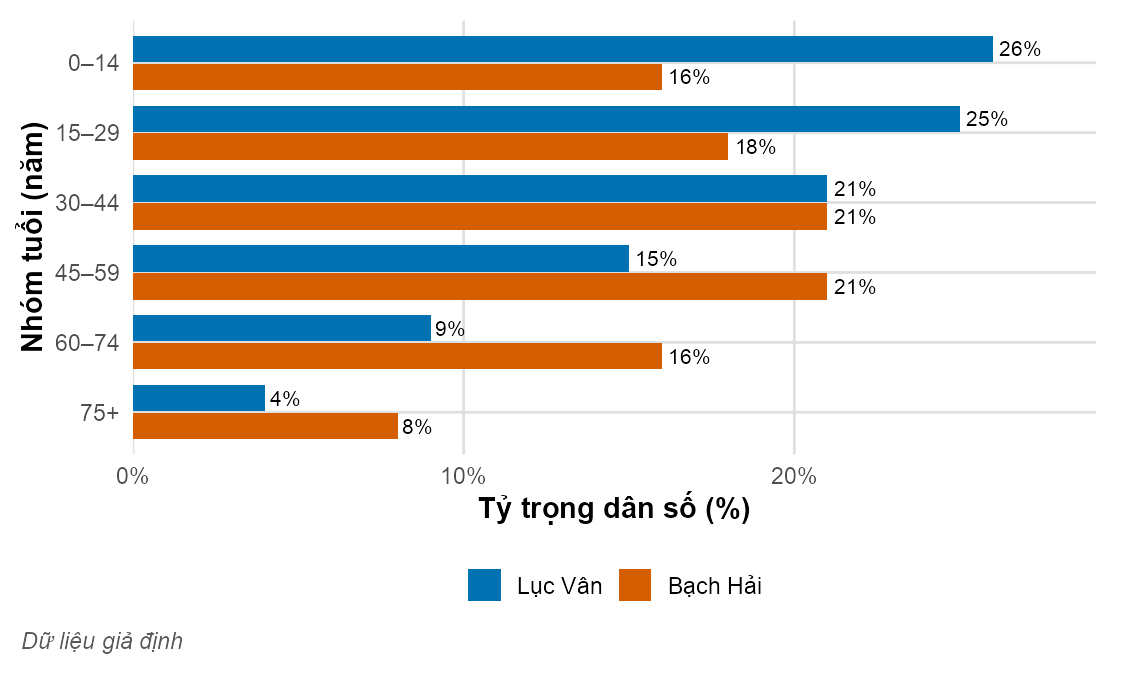
Câu trả lời nằm ở cơ cấu tuổi (age structure) của hai tỉnh (Hình 2.1). Ở Lục Vân, 51% dân số dưới 30 tuổi. Ở Bạch Hải, 24% dân số từ 60 tuổi trở lên, gấp 1,8 lần tỷ trọng 13% của Lục Vân. Mà tử vong lại tăng rất nhanh theo tuổi, nên tỉnh nào nhiều người già thì tỉnh ấy nhiều ca tử vong hơn, dù người già ở đó được chăm sóc tốt hơn.
Xem mã R
hinh_co_cau_tuoi() +gia_dinh()
Hình 2.1: Cơ cấu tuổi của hai tỉnh: tỷ trọng dân số trong từng nhóm tuổi. Bạch Hải có tỷ trọng người trung niên và cao tuổi lớn hơn hẳn Lục Vân. Dữ liệu giả định.
Phần còn lại của chương sẽ biến trực giác ấy thành phép tính. Ý chính rất đơn giản: tỷ suất thô trộn hai thứ khác nhau vào một con số, còn chuẩn hóa (standardization) tách chúng ra.
2.2 Tỷ suất thô là trung bình có trọng số
2.2.1 Hai thành phần của mọi tỷ suất thô
Tỷ suất thô đếm mọi ca tử vong trong quần thể rồi chia cho toàn bộ người-thời gian. Đó là con số thật: năm 2024, Bạch Hải đúng là có 11.663 người chết. Phép đếm không có gì sai. Vấn đề chỉ nảy sinh khi ta đặt hai tỷ suất thô cạnh nhau để so sánh.
Tỷ suất tử vong không như nhau ở mọi lứa tuổi. Ở Bạch Hải, tỷ suất của nhóm 75+ là 60,7 trên 1.000 người-năm, gấp khoảng 62 lần nhóm 15–29. Tỷ suất thô của cả tỉnh chính là các tỷ suất đặc hiệu theo tuổi ấy trộn lại với nhau, trong đó mỗi nhóm tuổi góp phần theo đúng tỷ trọng người-thời gian mà nhóm ấy chiếm. Nói gọn, tỷ suất thô là trung bình có trọng số (weighted average) của các tỷ suất đặc hiệu.
Viết bằng ký hiệu, với quần thể chia thành các tầng (stratum) tuổi \(k\):
Trọng số của tầng \(k\): tỷ trọng người-thời gian của tầng đó; các \(w_k\) cộng lại bằng 1
\(I_k = A_k / T_k\)
“i hoa ca”
Tỷ suất đặc hiệu ở tầng \(k\)
Ở vế giữa, \(T_k\) ở tử số của trọng số (weight) triệt tiêu \(T_k\) ở mẫu số của tỷ suất, nên vế phải bằng đúng vế trái: \(\sum_k w_k I_k = \sum_k A_k / T = I\). Đây là đẳng thức chứ không phải phép xấp xỉ hay mẹo tính: vẫn con số ấy, chỉ viết lại cho lộ ra hai thành phần (Lash và c.s. 2021, ch 4; Szklo và Nieto 2014, tr. 236).
Với Bạch Hải, \(w_k\) là tỷ trọng dân số của từng nhóm tuổi trong Hình 2.1, còn \(I_k\) là cột “Tỷ suất BH” trong Bảng 2.1. Nhân từng cặp rồi cộng lại, bạn sẽ được đúng 9,7 trên 1.000 người-năm.
Hai thành phần, hai câu hỏi khác nhau. Tỷ suất đặc hiệu \(I_k\) phản ánh điều kiện gây tử vong ở từng lứa tuổi: sinh học, môi trường, hệ thống y tế; đó thường là điều ta muốn so sánh. Trọng số \(w_k\) phản ánh nhân khẩu học: tỉnh có bao nhiêu người già, bao nhiêu trẻ em. Với câu hỏi “tỉnh nào khỏe hơn”, trọng số chính là thứ cần gạt ra khỏi phép so sánh. Tỷ suất thô lại hòa hai thành phần này vào một con số, và chỉ nhìn con số ấy thì không cách nào tách chúng ra được.
2.2.2 Vì sao trộn hai thành phần lại làm phép so sánh sai
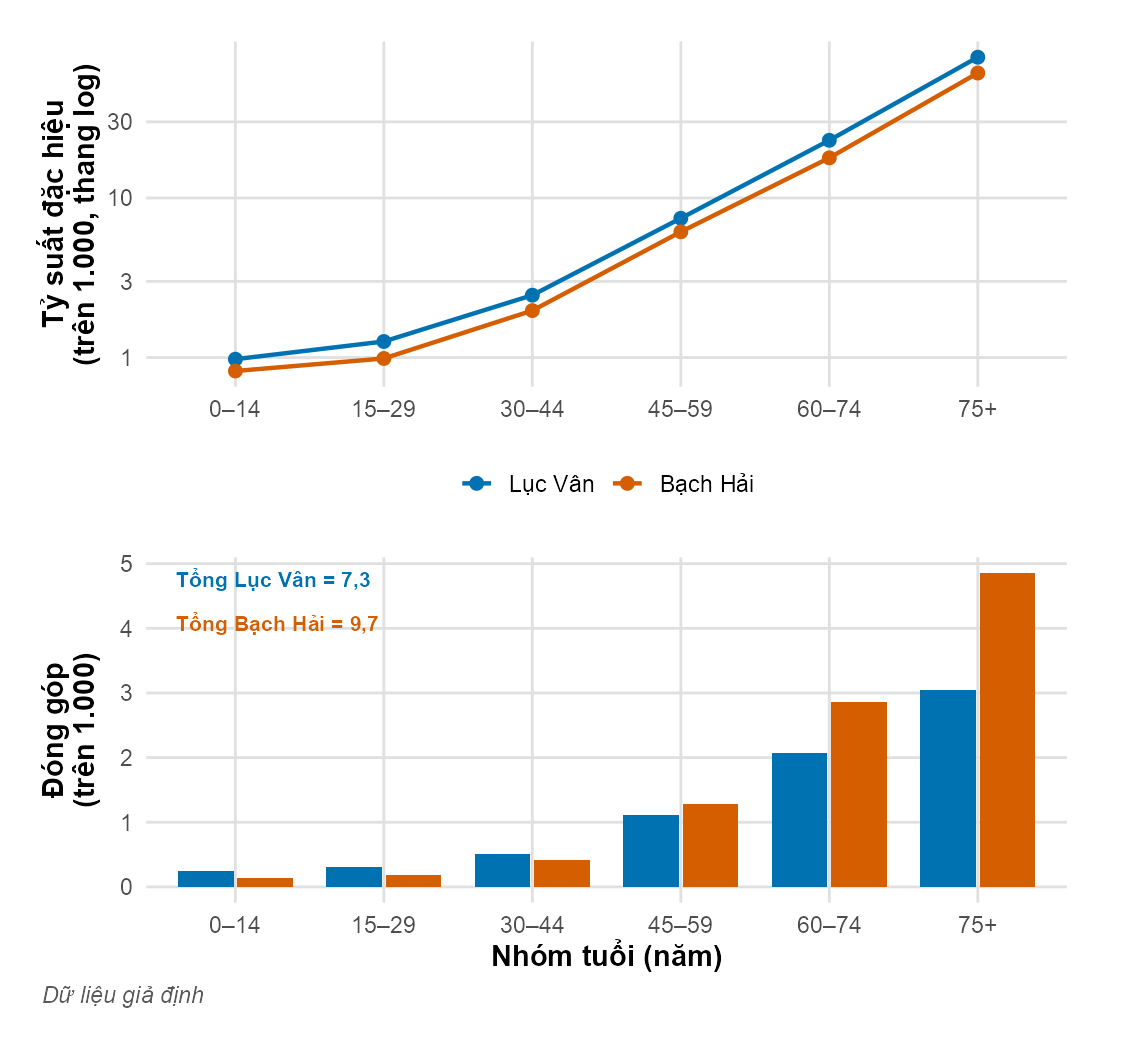
Hãy tách tỷ suất thô của mỗi tỉnh ra thành các phần đóng góp \(w_k I_k\) của từng nhóm tuổi (Hình 2.2). Ở hình trên, đường của Lục Vân nằm trên đường của Bạch Hải ở mọi nhóm tuổi: cùng độ tuổi, người Lục Vân tử vong nhiều hơn. Ở hình dưới, phần đóng góp của Bạch Hải lại lớn hơn hẳn ở hai nhóm tuổi cao nhất. Riêng nhóm 75+ đã góp 4,9 trong tổng số 9,7 trên 1.000 người-năm của Bạch Hải, tức 50% tỷ suất thô, dù chỉ chiếm 8% dân số.
Xem mã R
hinh_dong_gop() +gia_dinh()
Hình 2.2: Hai thành phần của tỷ suất thô. Trên: tỷ suất tử vong đặc hiệu theo tuổi; Lục Vân cao hơn Bạch Hải ở mọi nhóm tuổi. Dưới: phần đóng góp của từng nhóm tuổi vào tỷ suất thô (trọng số nhân tỷ suất); Bạch Hải đóng góp nhiều hơn ở các nhóm tuổi cao vì có nhiều người già. Tổng các cột của một tỉnh bằng tỷ suất thô của tỉnh đó. Dữ liệu giả định.
Ở đây trực giác dễ đánh lừa ta. Lục Vân tệ hơn ở mọi lứa tuổi, vậy mà tỷ suất thô lại thấp hơn. Chiều so sánh đảo ngược không phải do tỷ suất, mà hoàn toàn do trọng số: khi một tầng có tỷ suất cao (người già) lại chiếm tỷ trọng lớn, tỷ suất thô của tỉnh bị kéo lên theo.
Hiện tượng này có tên: tuổi đang gây nhiễu phép so sánh hai tỉnh. Tuổi liên quan đến “tỉnh nào” (Bạch Hải già hơn), lại liên quan mạnh đến tử vong. Ở đây ta mới dùng chữ nhiễu (confounding) theo nghĩa trực giác: phép so sánh không công bằng vì hai nhóm khác nhau ở một yếu tố quyết định kết cục (outcome), ở đây là tử vong. Định nghĩa chặt chẽ xin dành cho Chương 7.
2.3 Chuẩn hóa trực tiếp
2.3.1 Ý tưởng trong một câu
Giữ nguyên tỷ suất đặc hiệu của mỗi tỉnh, nhưng thay trọng số của tỉnh đó bằng trọng số của một dân số chuẩn (standard population) chung cho cả hai tỉnh.
Chuẩn hóa trực tiếp (direct standardization) chỉ gói gọn trong câu ấy. Giờ hai tỉnh dùng chung một bộ trọng số, nên nếu tỷ suất tóm tắt vẫn chênh nhau thì phần chênh ấy không thể do cơ cấu tuổi, vì cơ cấu tuổi của hai bên nay đã giống hệt nhau. Bộ trọng số chung ấy lấy từ một dân số chuẩn (standard population), có thật hoặc giả định.
2.3.2 Công thức, từng ký hiệu
Tỷ suất chuẩn hóa trực tiếp (directly standardized rate, DSR) của quần thể \(j\) là trung bình các tỷ suất đặc hiệu của chính \(j\), với trọng số của dân số chuẩn:
Đoán trước khi đọc tiếp · mức vừa. Giả sử ta lấy chính Lục Vân làm dân số chuẩn. Khi đó tỷ suất chuẩn hóa trực tiếp của Lục Vân sẽ ra sao?
Đặt công thức 2.1 và công thức 2.2 cạnh nhau, ta thấy đó là cùng một phép tính: tỷ suất thô dùng trọng số của chính quần thể, \(\sum_k w_k I_k\), còn tỷ suất chuẩn hóa dùng trọng số của dân số chuẩn, \(\sum_k w_k^* I_k\). Chuẩn hóa không đụng đến tỷ suất nào cả, chỉ thay bộ trọng số. Từ đó có một hệ quả thú vị: lấy chính một tỉnh làm dân số chuẩn thì tỷ suất chuẩn hóa của tỉnh ấy bằng đúng tỷ suất thô.
Khi các tầng là nhóm tuổi, tỷ suất này còn có tên là tỷ suất chuẩn hóa theo tuổi (age-standardized rate). Nhiều sách gọi phép tính này là hiệu chỉnh (adjustment) trực tiếp theo tuổi. Hiệu chỉnh có nghĩa rộng hơn chuẩn hóa: nó bao gồm cả những cách kiểm soát nhiễu khác mà ta sẽ gặp ở Chương 7.
2.3.3 Làm từng bước
Trước hết phải chọn một dân số chuẩn. Đơn giản nhất là gộp hai tỉnh: dân số chuẩn ở mỗi nhóm tuổi bằng tổng dân số của Lục Vân và Bạch Hải ở nhóm đó. Đây là chuẩn nội bộ (internal standard), sẽ bàn kỹ ở Mục 2.4. Bảng 2.2 trình bày phép tính theo từng cột.
Xem mã R
bang <-tibble(`Nhóm tuổi`=c(nhan_tuoi, "Tổng"),`Dân số chuẩn`=so(c(tung_buoc$T_chuan, sum(tung_buoc$T_chuan)), 0),`Trọng số chuẩn`=so(c(tung_buoc$w_chuan, sum(tung_buoc$w_chuan)), 3),`Tỷ suất LV`=c(so(tung_buoc$I_lv, 1), ""),`Tỷ suất BH`=c(so(tung_buoc$I_bh, 1), ""),`Trọng số × tỷ suất LV`=so(c(tung_buoc$wI_lv, nb$dsr_lv), 2),`Trọng số × tỷ suất BH`=so(c(tung_buoc$wI_bh, nb$dsr_bh), 2))knitr::kable(bang, align ="lrrrrrr")
Bảng 2.2: Chuẩn hóa trực tiếp với dân số chuẩn nội bộ (hai tỉnh gộp). Tỷ suất tính trên 1.000 người-năm. Tổng của hai cột cuối là tỷ suất chuẩn hóa trực tiếp của mỗi tỉnh. Dữ liệu giả định.
Nhóm tuổi
Dân số chuẩn
Trọng số chuẩn
Tỷ suất LV
Tỷ suất BH
Trọng số × tỷ suất LV
Trọng số × tỷ suất BH
0–14
400.000
0,200
1,0
0,8
0,20
0,16
15–29
416.000
0,208
1,3
1,0
0,26
0,21
30–44
420.000
0,210
2,5
2,0
0,52
0,41
45–59
372.000
0,186
7,5
6,1
1,39
1,14
60–74
264.000
0,132
23,0
17,8
3,03
2,35
75+
128.000
0,064
76,2
60,7
4,88
3,88
Tổng
2.000.000
1,000
10,27
8,16
Cột thứ ba là \(w_k^*\); cột thứ tư và thứ năm là \(I_{jk}\) của hai tỉnh; hai cột cuối là các tích \(w_k^* I_{jk}\). Cộng dọc hai cột cuối, ta được:
Lục Vân: \(\text{DSR}_{\text{LV}} = 10{,}3\) trên 1.000 người-năm;
Bạch Hải: \(\text{DSR}_{\text{BH}} = 8{,}2\) trên 1.000 người-năm.
Thứ tự đã đảo ngược so với tỷ suất thô: đặt hai tỉnh lên cùng một cơ cấu tuổi thì Lục Vân mới là tỉnh có tỷ suất tử vong cao hơn.
Còn một cách tính khác cho cùng kết quả, giúp hiểu vì sao phương pháp có tên “trực tiếp”: áp thẳng tỷ suất đặc hiệu của Lục Vân lên dân số chuẩn. Ở nhóm 75+, 128.000 người với tỷ suất 76,2 trên 1.000 người-năm sẽ có khoảng 9.760 ca tử vong. Cộng qua mọi nhóm tuổi, dân số chuẩn sẽ có 20.550 ca tử vong nếu áp tỷ suất của Lục Vân, và 16.324 ca nếu áp tỷ suất của Bạch Hải. Chia cho 2.000.000 người của dân số chuẩn, ta lại được 10,3 và 8,2 trên 1.000 người-năm (Szklo và Nieto 2014, tr. 236).
2.3.4 So sánh hai tỷ suất chuẩn hóa
Đứng riêng, một tỷ suất chuẩn hóa gần như chẳng nói lên điều gì, vì độ lớn của nó tùy vào dân số chuẩn ta chọn. Giá trị của nó chỉ hiện ra khi so sánh: hai tỷ suất chuẩn hóa theo cùng một dân số chuẩn thì đặt cạnh nhau được. Ta so sánh chúng bằng tỷ số tỷ suất chuẩn hóa (standardized rate ratio, SRR) hoặc hiệu tỷ suất chuẩn hóa (standardized rate difference, SRD):
Tỷ suất chuẩn hóa trực tiếp của hai tỉnh, cùng một dân số chuẩn
\(w_k^*\)
“đáp-bờ-liu ca sao”
Trọng số chuẩn, giống nhau ở tử số và mẫu số
\(I_{\text{BH},k}\), \(I_{\text{LV},k}\)
“i Bạch Hải ca”, “i Lục Vân ca”
Tỷ suất đặc hiệu của hai tỉnh ở tầng \(k\)
Mấu chốt là cùng một \(w_k^*\) có mặt ở cả tử số lẫn mẫu số; chính điều đó bảo đảm tính so sánh được. Vế phải của hiệu còn cho thấy thêm một điều: hiệu hai tỷ suất chuẩn hóa chính là trung bình có trọng số của các hiệu theo từng tầng (Lash và c.s. 2021, ch 5; Szklo và Nieto 2014, tr. 236).
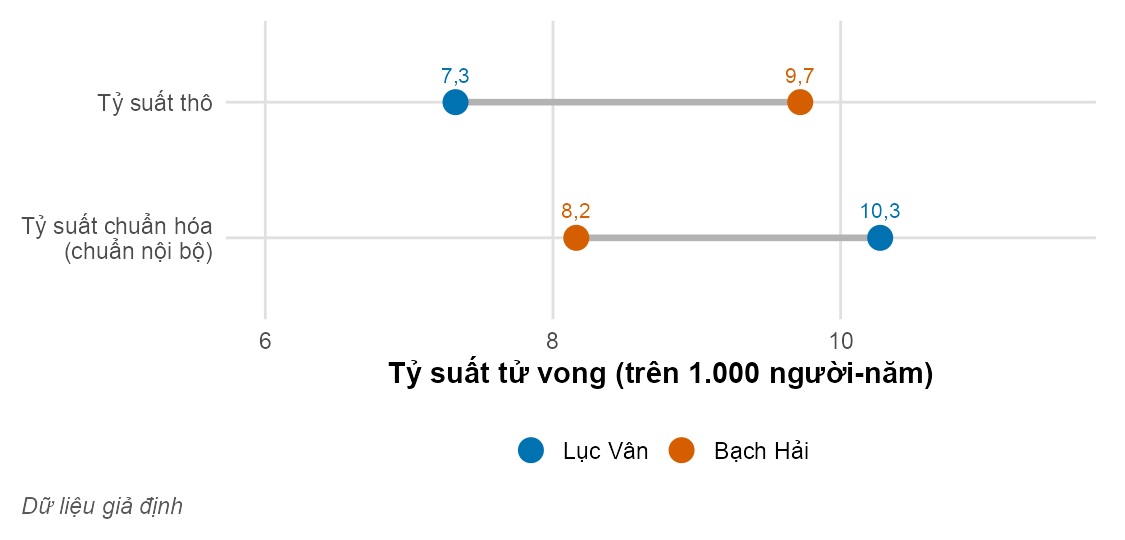
Với chuẩn nội bộ, SRR là 0,79 (KTC 95%: 0,77–0,82). Hiệu tỷ suất chuẩn hóa là −2,11 trên 1.000 người-năm (KTC 95%: −2,42 đến −1,81): sau chuẩn hóa, Bạch Hải thấp hơn Lục Vân khoảng 2,1 ca tử vong trên mỗi nghìn người-năm. So với tỷ số thô 1,33, chiều so sánh đã lật ngược (Hình 2.3).
Xem mã R
hinh_tho_chuan() +gia_dinh()
Hình 2.3: Tỷ suất tử vong thô và tỷ suất chuẩn hóa trực tiếp (chuẩn nội bộ) của hai tỉnh. Theo tỷ suất thô, Bạch Hải cao hơn; sau khi đặt hai tỉnh lên cùng một cơ cấu tuổi, Lục Vân cao hơn. Dữ liệu giả định.
Dưới đây là câu diễn giải mẫu, bạn nên dùng gần như nguyên văn mỗi khi báo cáo một SRR:
Nếu Bạch Hải và Lục Vân có cùng cơ cấu tuổi như dân số chuẩn, tỷ suất tử vong ở Bạch Hải sẽ bằng khoảng 0,79 lần Lục Vân.
Toàn bộ ý nghĩa của câu nằm ở hai cụm từ. Chữ “Nếu” nhắc rằng cơ cấu tuổi chỉ là giả định: không tỉnh nào thật sự có cơ cấu của dân số chuẩn. Cụm “tỷ suất tử vong ở Bạch Hải” nhắc rằng các tỷ suất đặc hiệu là thật, lấy từ chính tỉnh ấy. Vì vậy tỷ suất chuẩn hóa là đại lượng nửa thật nửa giả định: tỷ suất thật, trọng số mượn.
Đi sâu hơn
Sai số chuẩn và khoảng tin cậy của tỷ suất chuẩn hóa trực tiếp. Giả sử số ca tử vong \(A_{jk}\) ở mỗi tầng theo phân phối Poisson (Poisson distribution), tức có phương sai bằng chính nó, và người-thời gian là cố định. Khi đó phương sai của tỷ suất đặc hiệu là \(A_{jk}/T_{jk}^2\). Coi trọng số chuẩn \(w_k^*\) là hằng số, ta có phương sai của tổng có trọng số là
Số ca và người-thời gian của quần thể \(j\) ở tầng \(k\) (không có dấu sao: của quần thể nghiên cứu)
Sai số chuẩn (standard error, SE) là căn bậc hai của phương sai; KTC 95% gần đúng là \(\text{DSR}_j \pm 1{,}96 \times \text{SE}\). Với Lục Vân, \(\text{DSR}_{\text{LV}}\) có KTC 95% từ 10,01 đến 10,54 trên 1.000 người-năm.
Để so sánh hai tỷ suất chuẩn hóa độc lập, ta cộng phương sai: hiệu có \(\text{SE} = \sqrt{\text{SE}_{\text{BH}}^2 + \text{SE}_{\text{LV}}^2}\). Tỷ số thì xử lý trên thang log: \(\text{SE}(\ln \text{SRR}) = \sqrt{\text{SE}_{\text{BH}}^2/\text{DSR}_{\text{BH}}^2 + \text{SE}_{\text{LV}}^2/\text{DSR}_{\text{LV}}^2}\), rồi lấy mũ hai đầu của \(\ln \text{SRR} \pm 1{,}96 \times \text{SE}\)(Lash và c.s. 2021, ch 18; Szklo và Nieto 2014, tr. 443). Hàm std_compare() trong R/epi.R làm đúng các bước này. Có một hệ quả cần nhớ: khoảng tin cậy phụ thuộc vào trọng số chuẩn, nhưng không phản ánh chút bất định nào về cách chọn chuẩn. Ý nghĩa của khoảng tin cậy sẽ bàn ở Chương 5.
2.4 Chọn dân số chuẩn
2.4.1 Chuẩn nội bộ và chuẩn bên ngoài
Có hai cách chọn dân số chuẩn (Szklo và Nieto 2014, tr. 238–239). Chuẩn nội bộ (internal standard) dựng từ chính các quần thể đang so sánh: tổng hai tỉnh như ở trên, hoặc một trong hai tỉnh. Chuẩn bên ngoài (external standard) là một cơ cấu tuổi có sẵn: dân số cả nước, dân số một vùng, hay một dân số chuẩn quốc tế mà nhiều nghiên cứu cùng dùng để kết quả so sánh được với nhau.
Dân số chuẩn không nhất thiết phải là quần thể có thật. Về bản chất, đó chỉ là một bộ trọng số dương cộng lại bằng 1, nên một bộ trọng số chia đều cho mọi nhóm tuổi cũng là dân số chuẩn hợp lệ. Bộ dữ liệu dan_so_chuan có ba bộ trọng số giả định, chia theo đúng các nhóm tuổi của hai tỉnh. Kể từ nhóm trẻ nhất, trọng số của từng bộ là:
Khi một nhóm nhỏ hơn hẳn nhóm kia. Nhớ lại hệ quả ở Mục 2.3.2: quần thể nào được chọn làm chuẩn thì tỷ suất chuẩn hóa của nó trùng với tỷ suất thô. Vậy lấy nhóm nhỏ làm chuẩn thì các tỷ suất đặc hiệu chập chờn của nhóm nhỏ biến khỏi phép tính; chỉ còn các tỷ suất đặc hiệu ổn định của nhóm lớn được áp lên cơ cấu của nhóm nhỏ. Szklo và Nieto khuyên chọn cách này, và còn nêu một “dân số chuẩn phương sai nhỏ nhất”, với trọng số chọn sao cho ước lượng ổn định nhất (Szklo và Nieto 2014, tr. 238–239). Ở Mục 2.5, bạn sẽ thấy tỷ số hai tỷ suất khi ấy chính là SMR của nhóm nhỏ, với nhóm lớn làm quần thể tham chiếu (reference population).
2.4.2 Lựa chọn chuẩn làm thay đổi gì
Đoán trước khi đọc tiếp · mức khó. Ở Bảng 2.2, dân số chuẩn là hai tỉnh gộp. Nếu đổi sang một dân số chuẩn già hơn hẳn, tỷ số tỷ suất chuẩn hóa (SRR) tử vong Bạch Hải/Lục Vân sẽ ra sao?
Ta tính lại phép so sánh tử vong với cả bốn dân số chuẩn (Bảng 2.3).
Bảng 2.3: Tỷ suất tử vong chuẩn hóa trực tiếp (trên 1.000 người-năm), tỷ số và hiệu tỷ suất chuẩn hóa Bạch Hải so với Lục Vân, với bốn dân số chuẩn. Cột thứ hai là tỷ trọng của hai nhóm tuổi cao nhất trong dân số chuẩn. Dữ liệu giả định.
Dân số chuẩn
Tỷ trọng 60+
DSR Lục Vân
DSR Bạch Hải
SRR (KTC 95%)
Hiệu BH − LV (KTC 95%)
Nội bộ (hai tỉnh gộp)
20%
10,3
8,2
0,79 (0,77–0,82)
−2,11 (−2,42 đến −1,81)
Quốc gia giả định
16%
8,7
6,9
0,80 (0,77–0,82)
−1,78 (−2,04 đến −1,53)
Chuẩn trẻ
8%
5,0
4,0
0,80 (0,77–0,83)
−1,01 (−1,17 đến −0,85)
Chuẩn già
36%
18,2
14,4
0,79 (0,77–0,82)
−3,77 (−4,34 đến −3,20)
Hai điều nổi lên ngay.
Thứ nhất, độ lớn của tỷ suất chuẩn hóa thay đổi rất nhiều: tỷ suất chuẩn hóa của Bạch Hải đi từ 4,0 (chuẩn trẻ) đến 14,4 trên 1.000 người-năm (chuẩn già). Lý do dễ hiểu: chuẩn già đặt nhiều trọng số vào các nhóm tuổi có tỷ suất cao. Trong hai con số ấy, không con số nào là “tỷ suất tử vong của Bạch Hải”. Độ lớn của một tỷ suất chuẩn hóa không bao giờ diễn giải được khi đứng một mình (Celentano và Szklo 2019, tr. 83).
Thứ hai, tỷ số tỷ suất chuẩn hóa gần như không đổi: từ 0,79 đến 0,80. Lý do nằm ở Bảng 2.1: tỷ số Bạch Hải/Lục Vân gần như bằng nhau ở mọi nhóm tuổi, mà lấy trung bình những con số gần bằng nhau thì dùng trọng số nào kết quả cũng gần bằng chúng.
Hiệu tỷ suất chuẩn hóa thì khác: mức Bạch Hải thấp hơn Lục Vân đi từ 1,01 (chuẩn trẻ) đến 3,77 trên 1.000 người-năm (chuẩn già), chênh nhau gần 4 lần. Đó là vì hiệu theo từng nhóm tuổi không hằng định: ở người già, tỷ suất cao nên khoảng cách tuyệt đối giữa hai tỉnh lớn hơn nhiều. Hiệu chuẩn hóa lại là trung bình có trọng số của các hiệu theo tầng (công thức 2.3), nên chuẩn già cho hiệu lớn hơn.
Quy tắc rút ra: số đo chuẩn hóa chỉ không phụ thuộc vào dân số chuẩn khi số đo theo tầng tương ứng gần như hằng định. Tỷ số hằng định thì SRR ổn định, hiệu hằng định thì hiệu chuẩn hóa ổn định, và hiếm khi cả hai cùng hằng định (Szklo và Nieto 2014, tr. 236–238).
2.4.3 Khi lựa chọn chuẩn đảo ngược kết luận
Với tử vong, dân số chuẩn nào cũng cho cùng một kết luận. Với đái tháo đường (ĐTĐ) típ 2 thì không. Ca mới ở đây là người được chẩn đoán ĐTĐ típ 2 lần đầu trong năm 2024, đếm từ sổ đăng ký của hai tỉnh (chi tiết ở Mục C.3.1). Để đơn giản, mẫu số vẫn là dân số giữa năm, kể cả người đã mắc ĐTĐ từ trước. Mẫu số đúng phải là quần thể có nguy cơ (population at risk), tức những người chưa mắc và còn có thể thành ca mới, nên tỷ suất ở đây chỉ gần đúng. Tỷ suất mới mắc (incidence rate) là tốc độ xuất hiện ca mới. Tính thô, tỷ suất mới mắc ĐTĐ ở Lục Vân là 3,29 trên 1.000 người-năm, ở Bạch Hải là 4,83, cho tỷ số thô Lục Vân/Bạch Hải là 0,68 (KTC 95%: 0,65–0,71).
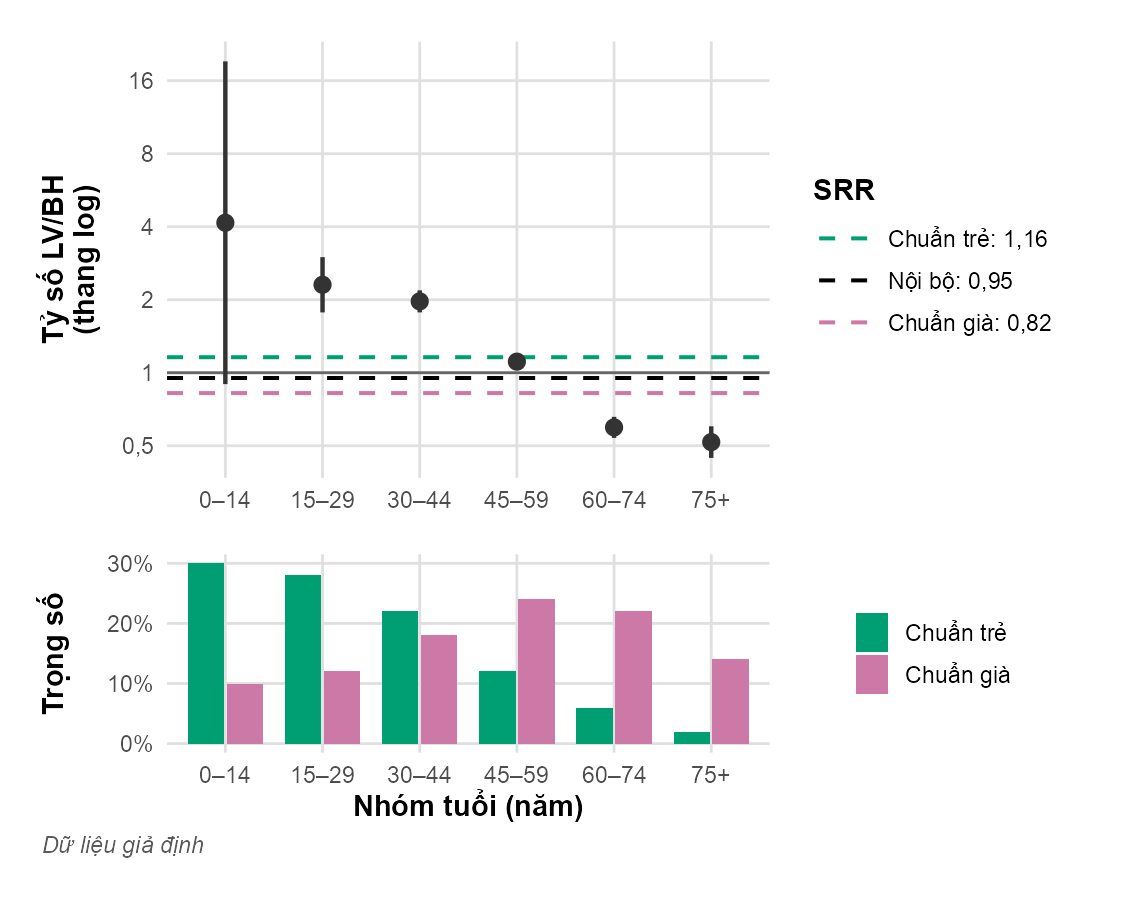
Nhưng tỷ số theo tuổi không hằng định (Hình 2.4, hình trên). Ở người trẻ, Lục Vân có tỷ suất ĐTĐ cao hơn: gấp 2,30 lần ở nhóm 15–29 và 1,97 lần ở nhóm 30–44. Ở người già thì ngược lại: chỉ bằng 0,52 lần ở nhóm 75+. Các tỷ số cắt qua đường 1.
Đoán trước khi đọc tiếp · mức vừa. Tính thô, tỷ số Lục Vân/Bạch Hải là 0,68, tức Lục Vân có vẻ ít ĐTĐ hơn. Nếu chuẩn hóa theo chuẩn trẻ, dồn trọng số vào các nhóm tuổi trẻ, kết luận sẽ thế nào?
Xem mã R
hinh_dtd() +gia_dinh()
Hình 2.4: Trên: tỷ số tỷ suất mới mắc đái tháo đường típ 2, Lục Vân so với Bạch Hải, theo nhóm tuổi (điểm và KTC 95%); các đường đứt là SRR với ba dân số chuẩn. Dưới: trọng số của chuẩn trẻ và chuẩn già. Chuẩn trẻ dồn trọng số vào các nhóm tuổi có tỷ số trên 1, chuẩn già dồn vào các nhóm có tỷ số dưới 1. Dữ liệu giả định.
Vì vậy kết quả chuẩn hóa phụ thuộc vào trọng số. Với chuẩn trẻ, SRR là 1,16 (KTC 95%: 1,10–1,22): Lục Vân “tệ hơn”. Với chuẩn già, SRR là 0,82 (KTC 95%: 0,78–0,87): Lục Vân “tốt hơn”. Với chuẩn nội bộ và chuẩn quốc gia giả định, SRR lần lượt là 0,95 (KTC 95%: 0,91–1,00) và 1,00 (KTC 95%: 0,96–1,05): hai tỉnh gần như ngang nhau. Cùng một bộ dữ liệu, chỉ đổi dân số chuẩn mà Lục Vân có thể “tệ hơn”, “tốt hơn” hoặc “ngang bằng” Bạch Hải.
Không SRR nào “đúng” hơn các SRR còn lại; mỗi con số trả lời một câu hỏi khác: “nếu cả hai tỉnh trẻ như chuẩn trẻ thì sao”, “nếu cả hai già như chuẩn già thì sao”. Cái khó là không con số nào tóm tắt được dữ liệu, vì bản thân dữ liệu không có một tỷ số chung để tóm tắt: mối liên quan giữa tỉnh và ĐTĐ thay đổi theo tuổi. Đó là tính không đồng nhất (heterogeneity) của số đo. Khi tính không đồng nhất ấy là thật, ta nói tuổi làm thay đổi tác động (effect-measure modification), chủ đề của Chương 8.
Bài học thực hành: luôn xem tỷ suất đặc hiệu theo tầng trước khi chuẩn hóa. Khi các tỷ số theo tầng khác nhau rõ rệt, hãy báo cáo từng tỷ số, đừng chỉ đưa ra một số đo chuẩn hóa duy nhất (Celentano và Szklo 2019, tr. 83; Szklo và Nieto 2014, tr. 237).
2.5 Chuẩn hóa gián tiếp và tỷ số tử vong chuẩn hóa
2.5.1 Khi nào phải chuyển sang chuẩn hóa gián tiếp
Chuẩn hóa trực tiếp cần tỷ suất đặc hiệu \(I_{jk}\) của quần thể nghiên cứu ở mọi tầng. Có ba tình huống thường gặp khi ta không có các tỷ suất ấy, hoặc có mà không tin được (Szklo và Nieto 2014, tr. 239–240; Celentano và Szklo 2019, tr. 84):
quần thể nghiên cứu nhỏ, mỗi tầng chỉ có vài ca, nên tỷ suất đặc hiệu dao động rất mạnh;
ta biết tổng số ca tử vong nhưng không biết chúng phân bố theo tuổi ra sao;
ta muốn so một nhóm đặc thù với dân số chung, như bệnh nhân một bệnh viện hay một đoàn hệ (cohort) công nhân, tức một nhóm công nhân được theo dõi qua nhiều năm.
Ví dụ của chương là đoàn hệ 4.000 nam công nhân Công ty Khai thác Đá X ở tỉnh Bạch Hải. Đó là mọi người công ty tuyển từ năm 2005 đến năm 2015, được theo dõi xem còn sống hay đã mất đến năm 2025, tổng cộng 58.202 người-năm. Công ty có hai khu vực: khu khai thác và nghiền đá, nơi công nhân hít bụi đá, và khu văn phòng. Câu hỏi đặt ra: công nhân ở đây có tử vong nhiều hơn mức “bình thường” không?
Chi tiết bộ dữ liệu
Đoàn hệ công nhân mỏ đá X (cong_nhan_mo_da và cong_nhan_ng_nam, xem thêm Mục C.3.5, Mục C.3.6).
Ai vào đoàn hệ. Danh sách lấy từ hồ sơ nhân sự của công ty. Mỗi người vào đoàn hệ từ ngày được tuyển.
Tìm ca tử vong. Danh sách công nhân được ghép với dữ liệu đăng ký hộ tịch để biết ai đã mất và mất vì nguyên nhân gì. Nhờ vậy, người nghỉ việc vẫn được theo dõi tiếp, và không ai mất theo dõi (loss to follow-up), tức không ai rời khỏi nghiên cứu giữa chừng mà không rõ sống hay chết.
Giả định của dữ liệu. Đăng ký hộ tịch ghi đủ và đúng mọi ca tử vong cùng nguyên nhân.
Khu vực làm việc. Mỗi công nhân thuộc đúng một khu vực trong suốt thời gian theo dõi.
Hai tệp dữ liệu.cong_nhan_mo_da có một dòng cho mỗi công nhân (Mục C.3.5). cong_nhan_ng_nam cộng sẵn người-năm và số tử vong theo khu vực và nhóm tuổi, là bảng dùng để tính trong chương (Mục C.3.6).
Trong suốt thời gian theo dõi, khu văn phòng chỉ có 5 ca tử vong do bệnh hô hấp mạn tính và ung thư phổi (gọi gọn là tử vong hô hấp), dồn cả vào nhóm 45–59; 3 trong 4 nhóm tuổi không có ca nào. Tỷ suất đặc hiệu tính từ vài ca như thế gần như vô nghĩa: thêm hay bớt một ca là tỷ suất của cả nhóm tuổi thay đổi hẳn.
2.5.2 Cú lật: dùng tỷ suất của chuẩn, trọng số của nhóm nghiên cứu
Chuẩn hóa gián tiếp (indirect standardization) lật ngược vai trò của hai thành phần: giữ người-thời gian theo tuổi của nhóm nghiên cứu, còn tỷ suất đặc hiệu thì mượn của một quần thể tham chiếu lớn, có tỷ suất ổn định. Câu hỏi giờ thành: với số người-năm ở từng độ tuổi như của đoàn hệ này, nếu họ tử vong theo tỷ suất của quần thể tham chiếu thì sẽ có bao nhiêu ca? Con số ấy là số kỳ vọng (expected number). Đem nó so với số quan sát (observed number), ta được tỷ số tử vong chuẩn hóa (standardized mortality ratio, SMR):
Số quan sát: tổng số ca tử vong thực sự ghi nhận trong đoàn hệ (chỉ cần tổng, không cần theo tầng)
\(T_k\)
“tê hoa ca”
Người-thời gian của đoàn hệ ở tầng \(k\): trọng số đến từ nhóm nghiên cứu
\(I_k^*\)
“i ca sao”
Tỷ suất đặc hiệu của quần thể tham chiếu ở tầng \(k\): thành phần được mượn
\(E\)
“e”
Số kỳ vọng: số ca tử vong nếu đoàn hệ có tỷ suất của quần thể tham chiếu
\(\text{SMR}\)
“ét em a”
Tỷ số tử vong chuẩn hóa
Với đoàn hệ công nhân, \(I_k^*\) là tỷ suất tử vong của nam giới tỉnh Bạch Hải năm 2024, còn \(T_k\) là người-năm theo nhóm tuổi đạt được (Szklo và Nieto 2014, tr. 239–240; Lash và c.s. 2021, ch 5). Tức là mỗi năm theo dõi của một công nhân được tính vào nhóm tuổi mà người ấy đang ở trong năm đó. Ai được theo dõi lâu thì già dần qua nhiều nhóm tuổi, nên góp người-năm cho nhiều nhóm. Dấu sao trên \(I_k^*\) vẫn đánh dấu thành phần đi mượn, như ở công thức 2.2, chỉ có điều lần này thứ đi mượn là tỷ suất. Số quan sát \(O\) và số kỳ vọng \(E\) là hai số đếm cùng đơn vị, nên SMR không có đơn vị.
Đọc SMR rất đơn giản. SMR bằng 1 nghĩa là số ca tử vong đúng bằng số kỳ vọng; lớn hơn 1 là nhiều ca hơn kỳ vọng, nhỏ hơn 1 là ít hơn. Phần chênh so với 1 cho biết nhiều hay ít hơn bao nhiêu phần trăm. Câu đọc ấy luôn kèm một vế ngầm: “so với quần thể tham chiếu, khi đã xét đến cơ cấu tuổi của chính đoàn hệ”. Khi kết cục là mới mắc thay vì tử vong, cùng phép tính ấy cho ra tỷ số mới mắc chuẩn hóa (standardized incidence ratio, SIR).
2.5.3 Làm từng bước: công nhân mỏ đá X
Bảng 2.4 là bảng tính cho cả công ty: mỗi dòng nhân người-năm với tỷ suất tham chiếu để được số kỳ vọng, rồi cộng dọc lại.
Bảng 2.4: Bảng tính số tử vong kỳ vọng và SMR cho đoàn hệ công nhân mỏ đá X (cả công ty). Tỷ suất tham chiếu là tỷ suất của nam giới tỉnh Bạch Hải năm 2024, tính trên 1.000 người-năm. Dữ liệu giả định.
Nhóm tuổi
Người-năm
Tỷ suất tham chiếu
Kỳ vọng
Quan sát
Tỷ suất hô hấp tham chiếu
Kỳ vọng hô hấp
Quan sát hô hấp
15–29
3.893
1,16
4,5
2
0,018
0,1
1
30–44
30.814
2,22
68,5
57
0,095
2,9
5
45–59
21.857
6,87
150,1
121
0,332
7,3
23
60–74
1.639
20,46
33,5
29
1,902
3,1
4
Tổng
58.202
256,6
209
13,4
33
Đoán trước khi đọc tiếp · mức dễ. Cả công ty có 209 ca tử vong do mọi nguyên nhân, trong khi số kỳ vọng là 256,6 ca. Công nhân mỏ đá X tử vong thế nào so với kỳ vọng?
Với tử vong do mọi nguyên nhân, đoàn hệ có \(O = 209\) ca, trong khi kỳ vọng là \(E = 256{,}6\), vậy SMR là 0,81 (KTC 95%: 0,71–0,93): công nhân mỏ đá X tử vong ít hơn kỳ vọng khoảng 19%.
Hiểu lầm thường gặp
“SMR nhỏ hơn 1 nghĩa là làm ở mỏ đá tốt cho sức khỏe.” Không phải. Người được tuyển và còn đi làm thường khỏe hơn dân số chung, vốn gồm cả người ốm yếu, tàn tật, không thể đi làm, nên so công nhân với dân số chung thường cho SMR dưới 1 ngay cả khi công việc có hại. Đó là hiệu ứng người lao động khỏe mạnh (healthy worker effect) (Lash và c.s. 2021, ch 14). Hiện tượng này thường được xếp vào sai lệch chọn lựa (selection bias), tức sai lệch sinh ra từ cách chọn người vào nghiên cứu; Chương 9 phân tích cấu trúc của nó và cho thấy nó mang cấu trúc của nhiễu.
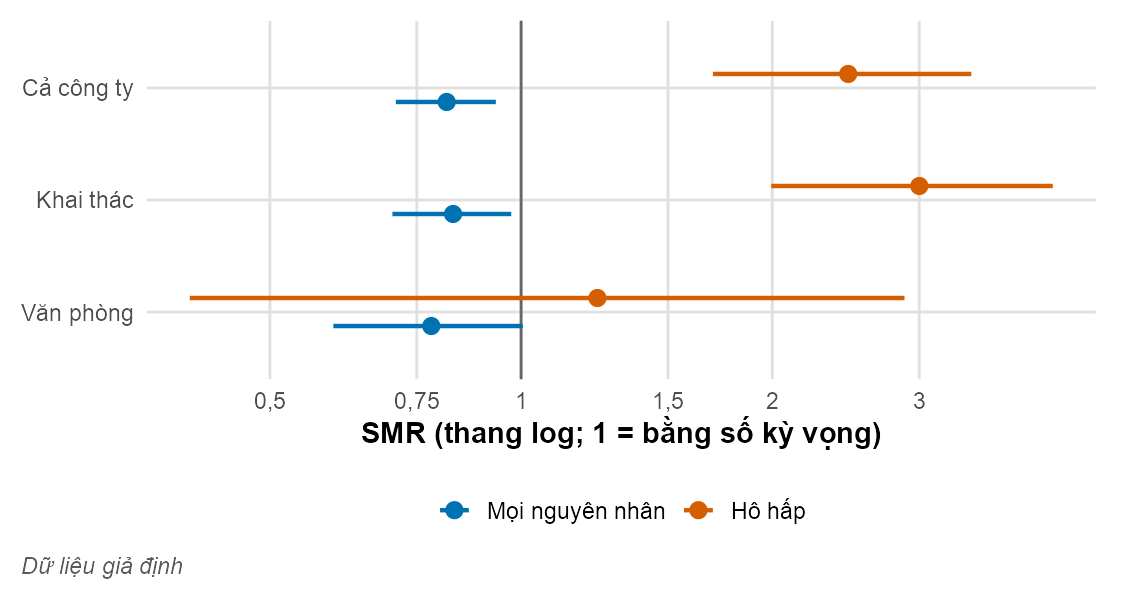
Câu hỏi đúng hơn nhắm vào một nguyên nhân tử vong cụ thể mà bụi đá có thể gây ra. Với tử vong hô hấp, số kỳ vọng cho cả công ty chỉ là 13,4 ca, vậy mà có tới 33 ca; SMR hô hấp là 2,47 (KTC 95%: 1,70–3,46). Tách theo khu vực, SMR hô hấp ở khu khai thác là 3,00 (KTC 95%: 1,99–4,34), còn ở khu văn phòng là 1,23 (KTC 95%: 0,40–2,88) (Hình 2.5).
Xem mã R
hinh_smr() +gia_dinh()
Hình 2.5: SMR tử vong do mọi nguyên nhân và tử vong hô hấp của công nhân mỏ đá X, so với nam giới tỉnh Bạch Hải, kèm KTC 95% chính xác. Tử vong chung thấp hơn kỳ vọng ở cả hai khu vực, nhưng tử vong hô hấp ở khu khai thác cao gấp khoảng 3 lần kỳ vọng. Dữ liệu giả định.
Hai SMR hô hấp kể cùng một câu chuyện. Công nhân văn phòng, được tuyển như công nhân khai thác nhưng không hít bụi đá, có số tử vong hô hấp không khác rõ rệt so với kỳ vọng; khoảng tin cậy rất rộng vì chỉ có 5 ca. Công nhân khai thác thì có số tử vong hô hấp gấp khoảng 3 lần kỳ vọng. So sánh bên trong công ty, giữa hai khu vực có cùng quá trình tuyển dụng, ít bị hiệu ứng người lao động khỏe mạnh làm sai lệch hơn so sánh với dân số chung. Nhưng đem hai SMR so với nhau thì phải cẩn thận; Mục 2.6 giải thích vì sao.
Đi sâu hơn
Khoảng tin cậy của SMR. Số kỳ vọng \(E\) tính từ tỷ suất của một quần thể tham chiếu rất lớn, nên ta coi nó là hằng số; chỉ số quan sát \(O\) là ngẫu nhiên, theo phân phối Poisson. Vì vậy KTC 95% của SMR chỉ đơn giản là KTC 95% của \(O\) chia cho \(E\)(Szklo và Nieto 2014, tr. 444; Rosner 2016, tr. 196).
Có hai cách lấy KTC cho \(O\). Cách chính xác dùng các giới hạn Poisson chính xác của \(O\); sách dùng cách này trong các bảng và hình (hàm smr_calc() với method = "exact"). Cách gần đúng tính trên thang log, với \(\text{SE}(\ln \text{SMR}) \approx 1/\sqrt{O}\), cho KTC \(\exp(\ln \text{SMR} \pm 1{,}96/\sqrt{O})\) (mặc định của smr_calc()). Khi \(O\) lớn, hai cách gần như trùng nhau: với tử vong chung, cách gần đúng cho 0,71–0,93, cách chính xác cho 0,71–0,93. Khi \(O\) nhỏ, chúng khác nhau rõ hơn: với tử vong hô hấp ở khu văn phòng, cận dưới là 0,51 theo cách gần đúng và 0,40 theo cách chính xác.
Để ý một điều: trên thang log, sai số chuẩn \(1/\sqrt{O}\) chỉ phụ thuộc vào tổng số ca quan sát, chứ không phụ thuộc vào cách các ca phân bố theo tầng. Vì thế, khi số ca nhỏ, SMR ổn định hơn tỷ suất chuẩn hóa trực tiếp: nó không dùng đến tỷ suất đặc hiệu chập chờn của từng tầng trong nhóm nghiên cứu. Ý nghĩa của khoảng tin cậy và phân phối Poisson sẽ bàn ở Chương 5.
2.6 Hai phương pháp đặt cạnh nhau
2.6.1 Bảng ảnh gương
Chuẩn hóa trực tiếp và gián tiếp là ảnh gương của nhau (Bảng 2.5): cả hai đều nhân một bộ tỷ suất với một bộ trọng số, chỉ khác nhau ở chỗ mỗi bộ lấy từ đâu.
Bảng 2.5: Chuẩn hóa trực tiếp và gián tiếp: hai ảnh gương
Chuẩn hóa trực tiếp
Chuẩn hóa gián tiếp
Tỷ suất đặc hiệu lấy từ
Quần thể nghiên cứu (\(I_{jk}\))
Quần thể tham chiếu (\(I_k^*\))
Trọng số lấy từ
Dân số chuẩn (\(w_k^*\))
Quần thể nghiên cứu (\(T_k\))
Cần gì từ quần thể nghiên cứu
Tỷ suất đặc hiệu ở mọi tầng
Người-thời gian theo tầng và tổng số ca
Kết quả
Tỷ suất chuẩn hóa (DSR); so sánh bằng SRR hoặc hiệu
Tỷ số O/E (SMR, SIR)
Kết quả mang cơ cấu của ai
Của dân số chuẩn, chung cho mọi nhóm
Của chính từng nhóm nghiên cứu
Dùng khi
So sánh nhiều quần thể, hoặc một quần thể qua thời gian
Tầng nhỏ, tỷ suất đặc hiệu không ổn định hoặc không có
Điểm yếu
Độ lớn phụ thuộc dân số chuẩn; tầng nhỏ làm tỷ suất dao động
Hai SMR thường không so sánh được với nhau
Câu dễ nhớ: trực tiếp mượn trọng số, gián tiếp mượn tỷ suất. Nhóm nào cho tỷ suất thì nhóm kia cho trọng số. Một nhầm lẫn rất phổ biến là tưởng chuẩn hóa gián tiếp dùng tỷ suất đặc hiệu của nhóm nghiên cứu; thực ra nó chỉ cần tổng số ca của nhóm nghiên cứu.
2.6.2 Vì sao hai SMR thường không so sánh được với nhau
Đoán trước khi đọc tiếp · mức khó. Hai nhóm công nhân có tỷ suất tử vong ở từng nhóm tuổi giống hệt nhau, nhưng một nhóm già hơn hẳn. Tính SMR của cả hai nhóm, cùng so với nam giới tỉnh Bạch Hải. Hai SMR có chắc chắn bằng nhau không?
Mỗi SMR là một trung bình có trọng số, với trọng số là người-thời gian của chính nhóm đó. SMR của khu khai thác được “chuẩn hóa” theo cơ cấu tuổi của khu khai thác, SMR của khu văn phòng theo cơ cấu của khu văn phòng. Hai SMR không đứng trên cùng một bộ trọng số, nên đem chúng so với nhau có thể đưa nhiễu do tuổi quay trở lại (Szklo và Nieto 2014, tr. 240–241; Lash và c.s. 2021, ch 5). Thậm chí hai nhóm có tỷ suất đặc hiệu giống hệt nhau vẫn có thể có hai SMR khác nhau, nếu cơ cấu tuổi khác nhau.
Nói chính xác hơn, so sánh hai SMR chỉ an toàn trong hai trường hợp: cơ cấu tuổi của hai nhóm gần giống nhau, hoặc tỷ số giữa tỷ suất của nhóm và tỷ suất tham chiếu gần như hằng định qua các tầng (Lash và c.s. 2021, ch 5).
Hiểu lầm thường gặp
“Hai nhà máy có SMR bằng nhau so với dân số tỉnh, vậy tử vong ở hai nhà máy như nhau.” Chưa chắc. Mỗi SMR so một nhà máy với dân số tỉnh, theo cơ cấu tuổi của riêng nhà máy đó, chứ không so hai nhà máy với nhau. Muốn so hai nhà máy, hãy chuẩn hóa trực tiếp cả hai theo cùng một dân số chuẩn.
Hãy kiểm tra điều này với mỏ đá X, bằng cách chuẩn hóa trực tiếp hai khu vực theo cùng một dân số chuẩn là tổng người-năm của cả công ty. Với tử vong chung, tỷ số tỷ suất chuẩn hóa khai thác/văn phòng là 1,06 (KTC 95%: 0,79–1,44), còn tỷ số hai SMR là 1,06: hai con số gần như trùng nhau. Với tử vong hô hấp, tỷ số chuẩn hóa trực tiếp là 2,32 (KTC 95%: 0,90–6,02), còn tỷ số hai SMR là 2,43: vẫn gần nhau, dù khoảng tin cậy rất rộng.
Vì sao ở đây hai cách lại khớp nhau? Không phải vì tỷ số theo tuổi hằng định: khu văn phòng mỗi tầng chỉ có vài ca, nên các tỷ số ấy dao động mạnh. Lý do là cơ cấu tuổi của hai khu vực gần như giống hệt nhau. Chẳng hạn, nhóm 30–44 chiếm 53% người-năm ở khu khai thác và 53% ở khu văn phòng, nên hai SMR dùng hai bộ trọng số gần bằng nhau. Ở một công ty có khu văn phòng già hơn hẳn khu khai thác, kết luận có thể khác.
Lưu ý: các sách trình bày khác nhau
Trong chuẩn hóa gián tiếp, đâu là “dân số chuẩn”?Gordis Epidemiology gọi hai phương pháp là hiệu chỉnh theo tuổi trực tiếp và gián tiếp; với SMR, sách áp tỷ suất của dân số chung lên nhóm nghiên cứu rồi nhân tỷ số O/E với 100 (Celentano và Szklo 2019, tr. 82–85). Rosner cũng so với dân số chung và định nghĩa SMR dưới dạng phần trăm, nên SMR bằng 100% nghĩa là đúng như kỳ vọng (Rosner 2016, tr. 261–262). Szklo và Nieto lưu ý rằng quần thể cung cấp tỷ suất hay bị gọi là “dân số chuẩn”, nhưng dân số chuẩn thật sự là chính nhóm nghiên cứu, vì trọng số lấy từ nhóm đó (Szklo và Nieto 2014, tr. 240). Modern Epidemiology nói cùng ý ấy theo cách khác: SMR là một tỷ số tỷ suất chuẩn hóa mà dân số chuẩn là chính nhóm phơi nhiễm (Lash và c.s. 2021, ch 5).
Cách gọi không làm thay đổi phép tính, nhưng ảnh hưởng đến cách hiểu. Nếu nghĩ quần thể cung cấp tỷ suất là “chuẩn”, người đọc dễ tin rằng mọi SMR dùng chung quần thể ấy đều so sánh được với nhau, mà mục này vừa cho thấy điều đó sai. Chương này theo Szklo và Nieto, sách dẫn đầu về phương pháp ứng dụng, và theo Modern Epidemiology: quần thể cung cấp tỷ suất gọi là quần thể tham chiếu, còn SMR viết dưới dạng tỷ số (1 nghĩa là đúng như kỳ vọng) thay vì phần trăm. Khác biệt về ký hiệu giữa các sách được đối chiếu ở Mục B.10.
Đi sâu hơn
Chuẩn hóa và suy luận nhân quả. Chuẩn hóa trả lời một câu hỏi dạng “nếu … thì”: tỷ suất của mỗi nhóm sẽ là bao nhiêu nếu cả hai nhóm có cùng một phân bố của yếu tố \(Z\) (ở đây là tuổi). Lấy trung bình các nguy cơ hay tỷ suất theo tầng trên một phân bố \(Z\) đã chọn chính là dạng đơn giản nhất của thứ mà các sách hiện đại gọi là công thức g (g-formula). Chọn phân bố của chính nhóm phơi nhiễm (exposure) làm chuẩn thì ta được SMR; chọn phân bố của cả quần thể thì ta được phép so sánh “nếu cả quần thể phơi nhiễm, so với nếu không ai phơi nhiễm” (Lash và c.s. 2021, ch 5 và 18).
Muốn con số chuẩn hóa mang nghĩa nhân quả, cần thêm những giả định mà phép tính không tự bảo đảm: trong mỗi tầng tuổi, hai nhóm phải so sánh được với nhau về mọi yếu tố khác, và tầng nào cũng phải có người ở cả hai nhóm. Các giả định này sẽ bàn ở Chương 6 và Chương 7. Modern Epidemiology còn lưu ý một điểm tinh tế: với tỷ suất, phơi nhiễm có thể làm thay đổi chính phân bố người-thời gian dùng làm trọng số, nên tỷ số tỷ suất chuẩn hóa chỉ là số đo tác động khi điều đó không xảy ra, hoặc khi tỷ số theo tầng hằng định (Lash và c.s. 2021, ch 5).
2.7 Những điều chuẩn hóa không làm được
Chuẩn hóa là công cụ giúp so sánh công bằng hơn, chứ không phải phép màu. Có năm điều nó không làm được.
Nó che giấu tính không đồng nhất. Ví dụ ĐTĐ ở Mục 2.4.3 cho thấy: khi tỷ số theo tầng cắt qua 1, số đo chuẩn hóa nào cũng chỉ là trung bình có trọng số của những con số trái chiều nhau, và một con số thì không thể đại diện cho “Lục Vân cao hơn ở người trẻ, thấp hơn ở người già”. Đó là giới hạn của mọi số đo tóm tắt, chuẩn hóa hay không.
Nó chỉ kiểm soát biến được chuẩn hóa. Chuẩn hóa theo tuổi làm hai tỉnh giống nhau về tuổi, và chỉ về tuổi mà thôi. Nếu hai tỉnh khác nhau về giới, hút thuốc hay khả năng tiếp cận dịch vụ y tế, những khác biệt ấy vẫn còn nguyên. Với giới, ta kiểm tra được: tỷ lệ nữ chung chênh nhau đôi chút giữa hai tỉnh (50,4% ở Lục Vân, 51,3% ở Bạch Hải), nhưng trong từng nhóm tuổi thì tỷ lệ nữ của hai tỉnh bằng nhau. Chuẩn hóa đồng thời theo tuổi và giới cho SRR 0,79 (KTC 95%: 0,77–0,82), đúng bằng kết quả khi chỉ chuẩn hóa theo tuổi: một khi tuổi đã cố định, giới không còn khác nhau giữa hai tỉnh nên không thể gây nhiễu. Đó là đặc điểm riêng của bộ dữ liệu này, không phải điều mà chuẩn hóa theo tuổi bảo đảm. Còn với yếu tố không đo được, ta không có cách nào kiểm tra.
Đoán trước khi đọc tiếp · mức vừa. Sở y tế Bạch Hải cần dự trù giường bệnh và nhân lực cho năm tới. Nên dựa vào tỷ suất tử vong nào?
Tỷ suất chuẩn hóa không phải tỷ suất thật. Đừng bao giờ trích dẫn một tỷ suất chuẩn hóa như thể đó là “tỷ suất tử vong của Bạch Hải”. Với chuẩn già, con số ấy là 14,4 trên 1.000 người-năm, trong khi số người chết thật ở Bạch Hải ứng với tỷ suất thô 9,7. Khi lập kế hoạch giường bệnh, nhân lực hay ngân sách, tỷ suất thô mới là gánh nặng thật mà hệ thống y tế phải đáp ứng (Celentano và Szklo 2019, tr. 83).
Tầng thô để lại nhiễu tồn dư. Chuẩn hóa chỉ loại bỏ khác biệt về tuổi ở mức chi tiết của các tầng đã dùng. Bên trong nhóm 75+, tuổi vẫn có thể chênh nhau nhiều: nếu người cao tuổi ở Bạch Hải sống lâu hơn, nhóm này của Bạch Hải sẽ có nhiều người rất cao tuổi hơn nhóm tương ứng của Lục Vân. Phần chênh ấy vẫn gây nhiễu, gọi là nhiễu tồn dư (residual confounding; xem Chương 7). Dữ liệu hai_tinh không có tuổi chi tiết hơn để kiểm tra điều này.
Một so sánh chuẩn hóa tự nó không chứng minh nhân quả. Chuẩn hóa loại bỏ một nguồn không so sánh được, là khác biệt về cơ cấu tuổi, nhưng không biến một so sánh mô tả giữa hai tỉnh thành ước lượng tác động. Muốn nói “sống ở Lục Vân làm tăng tử vong”, ta phải lập luận thêm về những giả định nhân quả của Chương 6.
Riêng ví dụ mỏ đá X còn một chỗ giản lược cần nói rõ: tỷ suất tham chiếu là của năm 2024, nhưng lại áp cho người-năm tích lũy từ 2005 đến 2025 mà không chia theo giai đoạn lịch, tức từng khoảng năm. Nghiên cứu thật sẽ dùng tỷ suất tham chiếu theo cả nhóm tuổi lẫn giai đoạn lịch, vì tỷ suất tử vong thay đổi qua các năm.
Hiểu lầm thường gặp
“Tỷ suất chuẩn hóa là tỷ suất ‘thật’ sau khi đã sửa sai.” Không. Tỷ suất chuẩn hóa là con số giả định, dùng tỷ suất đặc hiệu thật với trọng số đi mượn. Độ lớn của nó tùy vào dân số chuẩn: cùng Bạch Hải, cùng năm 2024, mà có thể là 4,0 hay 14,4 trên 1.000 người-năm tùy chuẩn. Chỉ phép so sánh giữa hai tỷ suất chuẩn hóa theo cùng một chuẩn mới có nghĩa.
“Chuẩn hóa luôn cho kết quả đúng hơn tỷ suất thô.” Không. Hai số đo trả lời hai câu hỏi khác nhau: tỷ suất thô cho biết gánh nặng thật mà tỉnh đang gánh, còn tỷ suất chuẩn hóa cho biết tỉnh nào có điều kiện tử vong tốt hơn ở cùng độ tuổi. Giám đốc sở y tế cần con số thứ nhất để lập kế hoạch; nhà nghiên cứu đi tìm nguyên nhân cần con số thứ hai.
“Đổi dân số chuẩn không bao giờ đổi kết luận.” Điều này chỉ đúng khi số đo theo tầng gần như hằng định, như tỷ số tử vong ở ví dụ hai tỉnh. Khi tỷ số theo tầng cắt qua 1, như với ĐTĐ, chuẩn trẻ cho SRR 1,16 còn chuẩn già cho 0,82: hai kết luận ngược nhau.
“Đã chuẩn hóa theo tuổi thì không còn nhiễu.” Chuẩn hóa theo tuổi chỉ kiểm soát tuổi, và chỉ ở mức chi tiết của các nhóm tuổi đã dùng. Mọi yếu tố khác mà hai quần thể chênh nhau vẫn có thể gây nhiễu, và nhiễu do tuổi vẫn còn sót lại trong mỗi nhóm tuổi rộng.
Tự kiểm tra
Hai huyện có tỷ suất tử vong đặc hiệu theo tuổi giống hệt nhau ở mọi nhóm tuổi, nhưng một huyện già hơn hẳn. So sánh nào sẽ cho thấy “không có khác biệt”?
Khi \(I_{jk}\) của hai huyện bằng nhau ở mọi tầng, \(\sum_k w_k^* I_{jk}\) của hai huyện cũng bằng nhau với mọi bộ trọng số \(w_k^*\). Tỷ suất thô thì khác nhau, vì huyện già hơn đặt nhiều trọng số hơn vào các tầng có tỷ suất cao.
Đúng hay sai: “Nếu tỷ số theo tuổi thay đổi mạnh giữa các nhóm tuổi, một tỷ số tỷ suất chuẩn hóa duy nhất là cách báo cáo tốt nhất.”
Sai. Khi tỷ số theo tầng khác nhau, SRR phụ thuộc vào dân số chuẩn và che giấu tính không đồng nhất (ví dụ ĐTĐ ở Mục 2.4.3), nên hãy báo cáo tỷ số theo từng tầng.
Ở khu văn phòng của mỏ đá X, có \(O = 5\) ca tử vong hô hấp, trong khi số kỳ vọng là \(E = 4{,}05\). SMR bằng bao nhiêu (hai chữ số thập phân)?
SMR \(= O/E =\) 5 \(/\) 4,05 \(=\) 1,23. Khu văn phòng có số tử vong hô hấp nhiều hơn kỳ vọng khoảng 23%, nhưng chỉ với 5 ca thì KTC 95% (0,40–2,88) rất rộng và chứa 1.
Dùng tỷ suất đặc hiệu của Lục Vân trong Bảng 2.1 và trọng số của chuẩn già trong bộ dữ liệu dan_so_chuan (0,10; 0,12; 0,18; 0,24; 0,22; 0,14 cho sáu nhóm tuổi từ trẻ đến già), tính tỷ suất tử vong chuẩn hóa trực tiếp của Lục Vân (trên 1.000 người-năm, lấy một chữ số thập phân).
\(\text{DSR}_{\text{LV}} = \sum_k w_k^* I_{\text{LV},k}\) = 0,10 × 1,0 + 0,12 × 1,3 + 0,18 × 2,5 + 0,24 × 7,5 + 0,22 × 23,0 + 0,14 × 76,2 ≈ 18,2 trên 1.000 người-năm. Con số này lớn hơn nhiều so với tỷ suất thô 7,3, vì chuẩn già đặt nhiều trọng số vào các nhóm tuổi có tỷ suất cao; đứng một mình, nó không cho biết gì về Lục Vân.
Vì sao một huyện miền núi nhỏ, mỗi năm chỉ có ít ca tử vong, thường nên dùng chuẩn hóa gián tiếp khi so với tỉnh?
Chuẩn hóa gián tiếp mượn tỷ suất ổn định của tỉnh và chỉ cần tổng số ca của huyện. Phương án cuối là hiểu lầm phổ biến: chuẩn hóa gián tiếp không dùng tỷ suất đặc hiệu của nhóm nghiên cứu.
Tỷ số tỷ suất thô giữa hai quần thể là 1, nhưng tỷ số tỷ suất chuẩn hóa là 1,5. Điều này cho biết gì về cơ cấu tuổi?
Đặt lên cùng một cơ cấu tuổi thì một quần thể có tỷ suất cao hơn 50%. Nếu tỷ suất thô vẫn bằng nhau, quần thể ấy phải có trọng số dồn vào các tầng tỷ suất thấp, tức là trẻ hơn. Tuổi đã che lấp một khác biệt có thật, giống như trường hợp Lục Vân trong chương này.
Nhà máy A và nhà máy B có SMR bằng nhau, cùng so với dân số tỉnh. Có thể kết luận tử vong ở hai nhà máy như nhau không? Giải thích bằng một hoặc hai câu.
Không. Mỗi SMR dùng cơ cấu tuổi của chính nhà máy đó làm trọng số, nên hai SMR không đứng trên cùng một bộ trọng số. Chúng chỉ so sánh được khi hai nhà máy có cơ cấu tuổi gần giống nhau, hoặc khi tỷ số so với dân số tỉnh gần như hằng định qua các nhóm tuổi. Để so hai nhà máy với nhau, hãy chuẩn hóa trực tiếp cả hai theo cùng một dân số chuẩn.
Với ĐTĐ, chuẩn trẻ cho SRR Lục Vân/Bạch Hải trên 1, chuẩn già cho SRR dưới 1. Hãy mô tả một bộ trọng số làm cho SRR gần bằng 1, và giải thích vì sao.
SRR nằm giữa các tỷ số theo tầng và nghiêng về phía các tầng được đặt nhiều trọng số. Muốn SRR gần 1, cần cân bằng trọng số giữa các nhóm tuổi trẻ (tỷ số trên 1) và các nhóm tuổi già (tỷ số dưới 1), hoặc dồn trọng số vào nhóm 45–59, là nhóm có tỷ số gần 1 nhất (1,11). Chuẩn quốc gia giả định làm đúng như vậy và cho SRR 1,00. Bài tập cho thấy SRR là sản phẩm của lựa chọn trọng số, chứ không phải đặc tính cố định của hai tỉnh.
Thực hành R
Phần này hướng dẫn làm lại các phép tính của chương bằng R, với vài dòng mã bạn có thể chép về dùng. Các hàm direct_std(), std_compare() và smr_calc() nằm trong tệp R/epi.R của kho mã; mã vẽ các hình của chương nằm trong R/ch02.R. Có thể tải trực tiếp các tệp dữ liệu tại https://youcan-e64.pages.dev/nckh/data/hai_tinh.csv, https://youcan-e64.pages.dev/nckh/data/dan_so_chuan.csv và https://youcan-e64.pages.dev/nckh/data/cong_nhan_ng_nam.csv.
Làm lại bảng chuẩn hóa trực tiếp
Bước đầu: đọc dữ liệu và gộp hai giới, để mỗi dòng là một tỉnh trong một nhóm tuổi. Kết quả phải có đúng 12 dòng; bạn hãy kiểm tra lại.
Tiếp theo, dựng dân số chuẩn nội bộ (hai tỉnh gộp) và trọng số chuẩn, rồi ghép vào bảng để tính tích trọng số × tỷ suất. Cộng cột w_x_ty_suat theo từng tỉnh, ta được tỷ suất chuẩn hóa. (R in số thập phân bằng dấu chấm.)
Xem mã R
chuan_tb <- theo_tuoi |>group_by(nhom_tuoi) |>summarise(dan_so_chuan =sum(nguoi_nam)) |># chuẩn nội bộ: tổng hai tỉnhmutate(w_chuan = dan_so_chuan /sum(dan_so_chuan)) # trọng số chuẩn, cộng lại bằng 1bang_buoc <- theo_tuoi |>left_join(chuan_tb, by ="nhom_tuoi") |>mutate(ty_suat = tu_vong / nguoi_nam *1000, # tỷ suất đặc hiệu, trên 1.000 người-nămw_x_ty_suat = w_chuan * ty_suat)bang_buoc |>group_by(tinh) |>summarise(dsr =sum(w_x_ty_suat))
Kết quả khớp với Bảng 2.2: 10,3 cho Lục Vân và 8,2 cho Bạch Hải. Hàm direct_std() cho cùng kết quả, kèm KTC 95%, và std_compare() so sánh hai tỷ suất chuẩn hóa:
Dòng SRR cho tỷ số 0,79 (KTC 95%: 0,77–0,82); dòng SRD cho hiệu −2,11 trên 1.000 người-năm.
Thử mọi dân số chuẩn
Hàm nhỏ dưới đây nhận một bộ trọng số và trả về SRR. Ta áp nó cho bốn dân số chuẩn của chương, với cả tử vong (Bạch Hải/Lục Vân) lẫn ĐTĐ (Lục Vân/Bạch Hải).
Xem mã R
dtd <- ht |>group_by(tinh, nhom_tuoi) |>summarise(ca =sum(so_ca_moi_dtd), .groups ="drop")srr_theo_chuan <-function(w, ca_tu, ca_mau, pt_tu, pt_mau) {sum(w * ca_tu / pt_tu) /sum(w * ca_mau / pt_mau) # tỷ số hai trung bình có trọng số}ds_chuan <-read_csv(dth_path("data/dan_so_chuan.csv"), show_col_types =FALSE)bon_chuan <-list(noi_bo = chuan_nb /sum(chuan_nb), quoc_gia = ds_chuan$chuan_quoc_gia_gd,tre = ds_chuan$chuan_tre, gia = ds_chuan$chuan_gia)dtd_lv <- dtd$ca[dtd$tinh =="luc_van"]; dtd_bh <- dtd$ca[dtd$tinh =="bach_hai"]sapply(bon_chuan, function(w) c(tu_vong =srr_theo_chuan(w, bh_th$tu_vong, lv_th$tu_vong, bh_th$nguoi_nam, lv_th$nguoi_nam),dtd =srr_theo_chuan(w, dtd_lv, dtd_bh, lv_th$nguoi_nam, bh_th$nguoi_nam)))
           noi_bo  quoc_gia      tre       gia
tu_vong 0.7943739 0.7952282 0.797508 0.7931901
dtd     0.9513704 1.0006493 1.158770 0.8244812
Bây giờ hãy thử mọi bộ trọng số mà mỗi tỷ trọng là bội số của một phần mười. Có đúng 3.003 bộ như vậy, và mã dưới đây liệt kê hết chúng mà không cần đến số ngẫu nhiên.
Xem mã R
luoi <-expand.grid(rep(list(0:10), 6)) # mọi tổ hợp 0..10 cho sáu nhóm tuổiluoi <-as.matrix(luoi[rowSums(luoi) ==10, ]) /10# giữ các bộ có tổng bằng 1nrow(luoi)
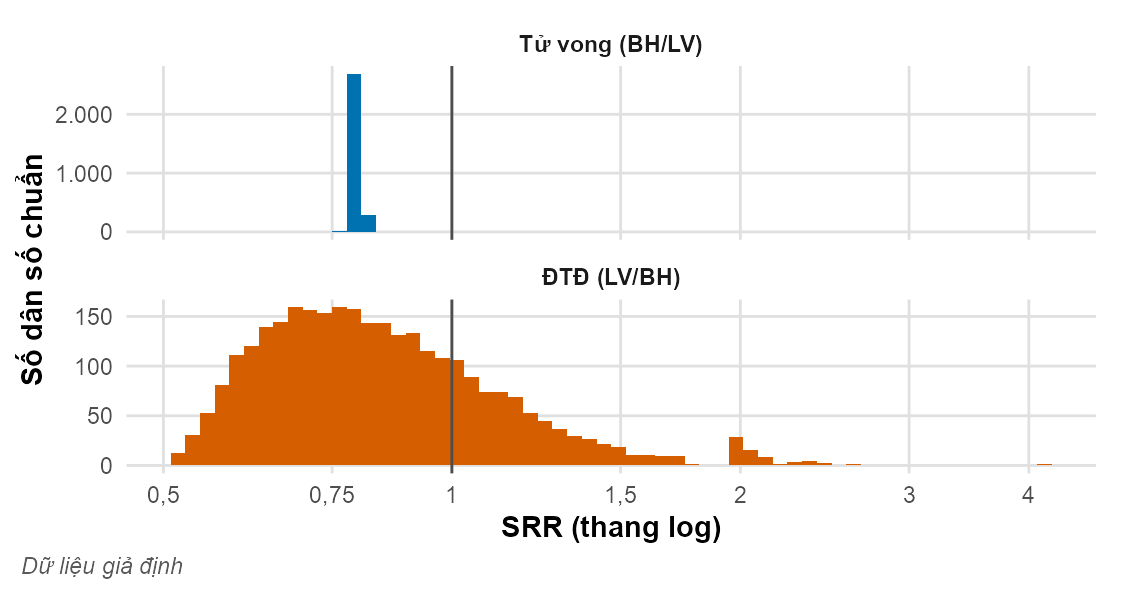
Với tử vong, dân số chuẩn nào cũng cho SRR trong khoảng 0,78–0,84. Với ĐTĐ, SRR đi từ 0,52 đến 4,15, tức là từ “Lục Vân tốt hơn hẳn” đến “Lục Vân tệ hơn hẳn” (Hình 2.6). SRR luôn nằm giữa tỷ số thấp nhất và cao nhất theo tầng, vì nó là trung bình có trọng số của các tỷ số đó. Hai đầu mút đến từ những “dân số chuẩn” kỳ quặc dồn toàn bộ trọng số vào một nhóm tuổi; đầu trên chính là tỷ số của nhóm 0–14, vốn chỉ dựa trên 11 ca. Vì thế nên chọn dân số chuẩn không quá khác các quần thể đang so sánh (Celentano và Szklo 2019, tr. 83).
Hình 2.6: Phân bố của SRR qua mọi dân số chuẩn có tỷ trọng là bội số của một phần mười. Với tử vong, SRR gần như không đổi; với đái tháo đường, SRR có thể nằm ở bất kỳ đâu từ dưới 1 đến trên 1, tùy dân số chuẩn. Dữ liệu giả định.
SMR của công nhân mỏ đá X
Ghép người-năm của đoàn hệ với tỷ suất tham chiếu của nam giới Bạch Hải theo nhóm tuổi, rồi tính số kỳ vọng bằng smr_calc(). Theo mặc định, hàm trả về SMR nhân 100 như cách viết của một số sách; với scale = "ratio", hàm trả về tỷ số O/E như trong chương này.
Xem mã R
cn_th <-read_csv(dth_path("data/cong_nhan_ng_nam.csv"), show_col_types =FALSE)tham_chieu_th <- ht |>filter(tinh =="bach_hai", gioi =="nam") |>transmute(nhom_tuoi, ty_suat = so_tu_vong / dan_so *1000, ty_suat_hh = so_tu_vong_ho_hap / dan_so *1000)cn_th <-left_join(cn_th, tham_chieu_th, by ="nhom_tuoi") # chỉ giữ các nhóm tuổi của đoàn hệcn_th |>group_by(khu_vuc) |>summarise(O =sum(so_tu_vong_ho_hap),E =smr_calc(O, nguoi_nam, ty_suat_hh, per =1000)$expected,SMR = O / E)
# A tibble: 2 × 4
  khu_vuc       O     E   SMR
  <chr>     <dbl> <dbl> <dbl>
1 khai_thac    28  9.33  3.00
2 van_phong     5  4.05  1.23
SMR hô hấp là 3,00 ở khu khai thác và 1,23 ở khu văn phòng, khớp với Hình 2.5. Thay so_tu_vong_ho_hap bằng so_tu_vong và ty_suat_hh bằng ty_suat là được SMR do mọi nguyên nhân. Còn KTC 95% chính xác của một SMR thì dùng smr_calc(O, nguoi_nam, ty_suat, per = 1000, scale = "ratio", method = "exact").
Chuẩn hóa theo cả tuổi và giới
Ta lặp lại chuẩn hóa trực tiếp với 12 tầng tuổi × giới thay vì 6 tầng tuổi; dân số chuẩn vẫn là hai tỉnh gộp.
SRR theo tuổi và giới là 0,79 (KTC 95%: 0,77–0,82), không khác SRR chỉ theo tuổi. Lý do: trong mỗi nhóm tuổi, tỷ lệ nữ của hai tỉnh bằng nhau (từ 49% ở nhóm trẻ nhất đến 60% ở nhóm 75+), nên khi tuổi đã cố định, giới không còn khác nhau giữa hai tỉnh và không thể gây nhiễu. Bạn có thể kiểm tra bằng ht |> group_by(tinh, nhom_tuoi) |> summarise(ty_le_nu = sum(dan_so[gioi == "nu"]) / sum(dan_so)).
Tóm tắt và đọc thêm
Tỷ suất thô là trung bình có trọng số của các tỷ suất đặc hiệu, với trọng số là cơ cấu của chính quần thể. Hai quần thể khác cơ cấu tuổi có thể có tỷ suất thô ngược chiều với tỷ suất đặc hiệu, như Bạch Hải (thô 9,7) và Lục Vân (thô 7,3 trên 1.000 người-năm).
Chuẩn hóa trực tiếp giữ tỷ suất đặc hiệu của mỗi quần thể, chỉ thay trọng số bằng trọng số của một dân số chuẩn chung. Câu diễn giải luôn mở đầu bằng “nếu hai quần thể có cùng cơ cấu tuổi như dân số chuẩn”. Với chuẩn nội bộ, SRR Bạch Hải/Lục Vân là 0,79 (KTC 95%: 0,77–0,82).
Độ lớn của tỷ suất chuẩn hóa phụ thuộc vào dân số chuẩn, nên không diễn giải được khi đứng một mình. SRR chỉ ổn định khi tỷ số theo tầng gần như hằng định; khi các tỷ số ấy cắt qua 1, như với ĐTĐ, lựa chọn chuẩn có thể đảo ngược kết luận, và khi đó hãy báo cáo số đo theo tầng.
Chuẩn hóa gián tiếp mượn tỷ suất của quần thể tham chiếu, giữ người-thời gian của nhóm nghiên cứu, và cho SMR \(= O/E\); phương pháp này hữu ích khi tầng nhỏ. SMR dưới 1 ở công nhân thường phản ánh hiệu ứng người lao động khỏe mạnh, chứ không phải tác dụng bảo vệ.
Hai SMR dùng hai bộ trọng số khác nhau nên thường không so sánh được với nhau; muốn so hai nhóm, hãy chuẩn hóa trực tiếp theo cùng một chuẩn.
Chuẩn hóa chỉ kiểm soát biến được chuẩn hóa, ở mức chi tiết của các tầng đã dùng; tự nó không chứng minh quan hệ nhân quả.
Thẻ tra nhanh. Trực tiếp: \(\text{DSR}_j = \sum_k w_k^* I_{jk}\), với \(w_k^* = T_k^*/\sum_k T_k^*\). So sánh: \(\text{SRR} = \text{DSR}_{\text{BH}}/\text{DSR}_{\text{LV}}\) và hiệu \(\text{DSR}_{\text{BH}} - \text{DSR}_{\text{LV}}\), cùng một dân số chuẩn. Gián tiếp: \(E = \sum_k T_k I_k^*\), \(\text{SMR} = O/E\). Cú tráo: trực tiếp lấy tỷ suất của nhóm nghiên cứu và trọng số của chuẩn; gián tiếp lấy tỷ suất của quần thể tham chiếu và trọng số của nhóm nghiên cứu.
Đọc thêm.
Szklo và Nieto trình bày rất rõ chuẩn hóa trực tiếp, gián tiếp và vai trò của giả định đồng nhất, kèm ví dụ cho thấy khi nào lựa chọn chuẩn làm đổi kết quả (Szklo và Nieto 2014, tr. 234–242).
Gordis Epidemiology có phần nhập môn ngắn gọn về hiệu chỉnh theo tuổi và SMR, viết cho người đọc lâm sàng (Celentano và Szklo 2019, tr. 82–85).
Modern Epidemiology đặt chuẩn hóa vào khung số đo tác động và suy luận nhân quả, kèm công thức phương sai đầy đủ (Lash và c.s. 2021, ch 4, 5 và 18).
Rosner trình bày chuẩn hóa theo tuổi từ góc nhìn thống kê sinh học (Rosner 2016, tr. 656–657).
Celentano, David D., và Moyses Szklo. 2019. Gordis Epidemiology. 6th ab. Philadelphia, PA: Elsevier.
Lash, Timothy L., Tyler J. VanderWeele, Sebastien Haneuse, và Kenneth J. Rothman. 2021. Modern Epidemiology. 4th ab. Philadelphia, PA: Wolters Kluwer.
Rosner, Bernard. 2016. Fundamentals of Biostatistics. 8th ab. Boston, MA: Cengage Learning.
Szklo, Moyses, và F. Javier Nieto. 2014. Epidemiology: Beyond the Basics. 3rd ab. Burlington, MA: Jones & Bartlett Learning.